

iPhone新品首发那段时间,我相信很多人都经历过一种焦虑:页面刷了又刷,购物车加了又加,结果一到结算就是“已售完”。更气人的是,过半小时再点进去,某个门店又冒出两台现货,等你切过去早就没了。这种“明明有货,却总是错过”的感觉,才是抢购真正的痛点。
后来我干脆想,与其靠人肉刷新,不如让程序盯着苹果产品的库存接口。但这个想法刚冒出来,又被自己劝退了:写爬虫、解析 JSON、处理异步请求、接通知服务,这套流程一个人从零开始搞,怎么也得一个周末。那几天我正好在试 OpenAI 的 Codex,一个能在终端里自主写代码、跑命令、看报错、自己改代码的 AI 编程 Agent。我突发奇想:这种“目标明确、逻辑相对独立”的小工具,不正是让 AI 来做最好的场景吗?于是就有了这个项目:用 Codex 做一个苹果库存监控工具。
这篇文章我不打算写成教程式的说明书,而是想认真聊聊整个过程中最值得记录的几件事:为什么我会选 Codex 而不是自己手写,监控工具的架构是怎么一步步被 AI 搭起来的,以及在实战里踩过的那些坑。无论你是对 AI 编程感兴趣,还是想用技术解决“抢不到货”这种小烦恼,这篇文章应该都能给你一些启发。

1. 需求拆解:为什么“抢不到”本质上是个信息差问题
1.1 库存不是一次性放出的,而是动态流动的
很多人以为 iPhone 新品开售是“一次性放出全部库存”,实际上并不是这样。苹果线上商店的库存,尤其是热门型号和颜色,经常会以非常不规律的方式分批释放。可能是有人取消订单后回流,可能是某个仓库临时调配,也可能是区域配送计划的间隙。这些库存往往只存在几分钟,甚至几十秒。
这就是信息差:你看到的“无货”,只是某个瞬间的无货,并不代表接下来五分钟不会补货。而人工刷新页面的频率,再快也就是几分钟一次,中间的大量窗口期全部浪费掉了。所以库存监控工具的核心价值,不是“抢”,而是“第一时间感知变化”。它用程序替你把“盯着页面”这个动作做到极致,一旦检测到状态变化就立刻提醒你。
1.2 监控工具的三个基本职责
一个合格的库存监控工具,至少要做三件事:
轮询
:定期去请求苹果产品的库存接口,获取某个产品编码在附近门店的实时库存状态。
判断
:把当前结果与上一次结果做对比,只有在状态发生变化时才触发后续动作,避免重复通知。
通知
:通过手机推送、即时通讯机器人等渠道,把“某门店出现现货”这个消息以最快速度送到你手上。
听起来不复杂,但真正落地时你会发现,这三件事分别对应了网络请求、状态管理和异常处理,每一项都有不少细节。比如轮询频率太高会被风控,判断逻辑不严谨会漏报或误报,通知服务没配好会导致消息延迟。这些细节,正是 AI 辅助编程最容易“翻车”的地方,也是后面 Codex 让我惊喜又头疼的原因。
2. 为什么选 Codex?AI Agent 和传统补全工具完全是两个物种
2.1 Codex 到底是什么
Codex 是 OpenAI 推出的编程 Agent,准确说,它能直接在终端里“干活”。跟你在 IDE 里用 Copilot 补全代码不一样,Codex 不是等你敲几个字符再帮你接一句,而是你给它一个目标,它自己去读项目文件、写代码、执行命令、看运行结果、根据报错自动修复。整个过程是循环的:执行、观察、修正、再执行。
我用的是 Codex CLI,在终端里跑
codex
命令启动交互式会话。它可以在你指定的目录下自由操作文件系统,相当于一个能自己动手写代码的“实习生”。这件事的震撼感在于,你不再需要把每一行代码都想好,只需要把需求描述清楚,它就能把整个功能骨架搭起来。
2.2 Agent 式开发与传统 AI 编程的差别
传统 AI 编程工具,比如 IDE 里的代码补全,本质是“在你已经搭好的框架里填内容”。人还是主导者,你得自己规划模块、自己建文件、自己处理依赖关系。
Codex 这种 Agent 式工具则完全不同。它更像一个拥有“工程能力”的初级开发人员:你告诉它“帮我写一个异步轮询苹果库存接口的脚本”,它会自己决定用哪个库、建几个文件、怎么组织函数、怎么处理异常。你后期做的是“验收”和“纠偏”,而不是“零开始编码”。
这个差别对做小工具来说意义很大。库存监控这种项目,逻辑不算复杂,但要写的样板代码不少:异步客户端、重试机制、参数解析、通知封装……如果人手写,至少磨蹭半天。Codex 在一个小时之内就能把整套东西跑起来。我只需要在关键节点上检查它的思路,防止它跑偏。
2.3 选型思考:Python 还是 Node.js?
我一开始没指定语言,Codex 默认用了 Python,理由是生态成熟:
httpx
做异步请求、
apscheduler
做定时调度、
json
处理解析,都是现成方案。我认可这个选择,因为 Python 的工具链对“写监控脚本”这类任务是最省事的。就算你不熟悉 Python,读它的代码也相对容易理解。
不过这里有个很重要的原则:你可以让 AI 选技术栈,但你自己必须清楚验收标准。Codex 选了 Python,我就按 Python 项目的惯例去检查它;如果它选了 Node.js,我也会用 Node 的方式去验收。AI 可以决定“怎么做”,但“做成什么样才合格”,必须由人来定义。
3. 核心实现拆解:库存监控工具的完整技术链路
3.1 数据源:苹果产品的库存JSON接口
要监控库存,首先得知道数据从哪来。苹果产品的商品详情页并不是纯静态页面,当你进入“选购”流程、选择型号后,页面上会显示附近门店的取货可用性,这部分数据是通过异步请求加载的。浏览器开发者工具里能看到一个返回 JSON 的接口,里面包含每个店铺的库存状态、可用数量、取货时间等信息。
这个接口需要带几类参数:
产品编码,也就是你盯的那款 iPhone 的零件号,页面数据里能找到。
地域信息,通常是经纬度,用来计算附近门店。
请求头,至少要带正常的 User-Agent,否则很容易被识别成异常请求。
我没有在文章里直接贴具体接口地址,因为这类接口的细节会随着产品改版而变化。更重要的是思路:找数据接口、看返回结构、定位字段、封装请求。这个思路通用性极强,换任何网站都成立。
3.2 技术架构:异步并发 + 状态对比 + 多路通知
确认数据源之后,我给 Codex 描述的目标是:写一个 Python 脚本,每隔一段时间查询附近门店的库存,发现状态变化就发送通知。Codex 给出的结构大概是这样的:
config.py
:集中管理产品编码、门店列表、轮询间隔和通知方式。
fetcher.py
:负责请求库存接口,解析每个门店的库存状态。
compare.py
:保存上一次的查询结果,用于差异检测。
notifier.py
:封装通知渠道,包括微信机器人、Telegram、Server酱等。
main.py
:主循环,负责按时间间隔执行抓取、比较和通知。
这个分层很合理。我唯一调整的是把“对比”单独拎出来成一个模块。原因是状态变化检测是这整个工具的大脑:如果每次都无脑通知,手机一会儿就会被轰炸;如果变化检测逻辑写错了,该通知的时候又没反应。所以对比逻辑必须独立、清晰、可测试。
3.3 关键代码:核心轮询逻辑是怎么实现的
下面这段是 Codex 写的核心抓取逻辑简化版,我加了一些注释。要注意,接口地址和字段名我是按当时抓包的示例写的,上线前你需要以实际抓包结果为准。
import asyncio
import httpx
import random

STORE_LIST = [
    {"id": "R001", "name": "示例门店A", "lat": 31.2304, "lng": 121.4737},
    {"id": "R002", "name": "示例门店B", "lat": 39.9042, "lng": 116.4074},
]

async def fetch_store_availability(client, store, product_code):
    """查询单个门店的库存状态"""
    params = {
        "product": product_code,
        "location": f"{store['lat']},{store['lng']}",
    }
    headers = {
        "User-Agent": "Mozilla/5.0 (iPhone; CPU iPhone OS 17_0 like Mac OS X)",
        "Accept": "application/json",
    }
    try:
        resp = await client.get(
            "[地址已省略]",
            params=params,
            headers=headers,
            timeout=10,
        )
        resp.raise_for_status()
        data = resp.json()
        # 实际字段需根据接口结构调整
        return data["store"]["availability"]
    except Exception as e:
        return {"error": str(e)}

async def main():
    async with httpx.AsyncClient() as client:
        # 使用信号量限制并发,比如同一时间最多发 3 个请求
        sem = asyncio.Semaphore(3)
        async def guarded(store):
            async with sem:
                return store["id"], await fetch_store_availability(client, store, PRODUCT_CODE)
        results = await asyncio.gather(*(guarded(s) for s in STORE_LIST))
        for store_id, availability in results:
            print(store_id, availability)

if __name__ == "__main__":
    asyncio.run(main())
这段代码的关键点是用了
Semaphore(3)
。这是我特意让 Codex 加的,因为如果不限制并发量,几十家门店同时发请求,很快就会被服务器拒之门外。
3.4 轮询策略与风控意识
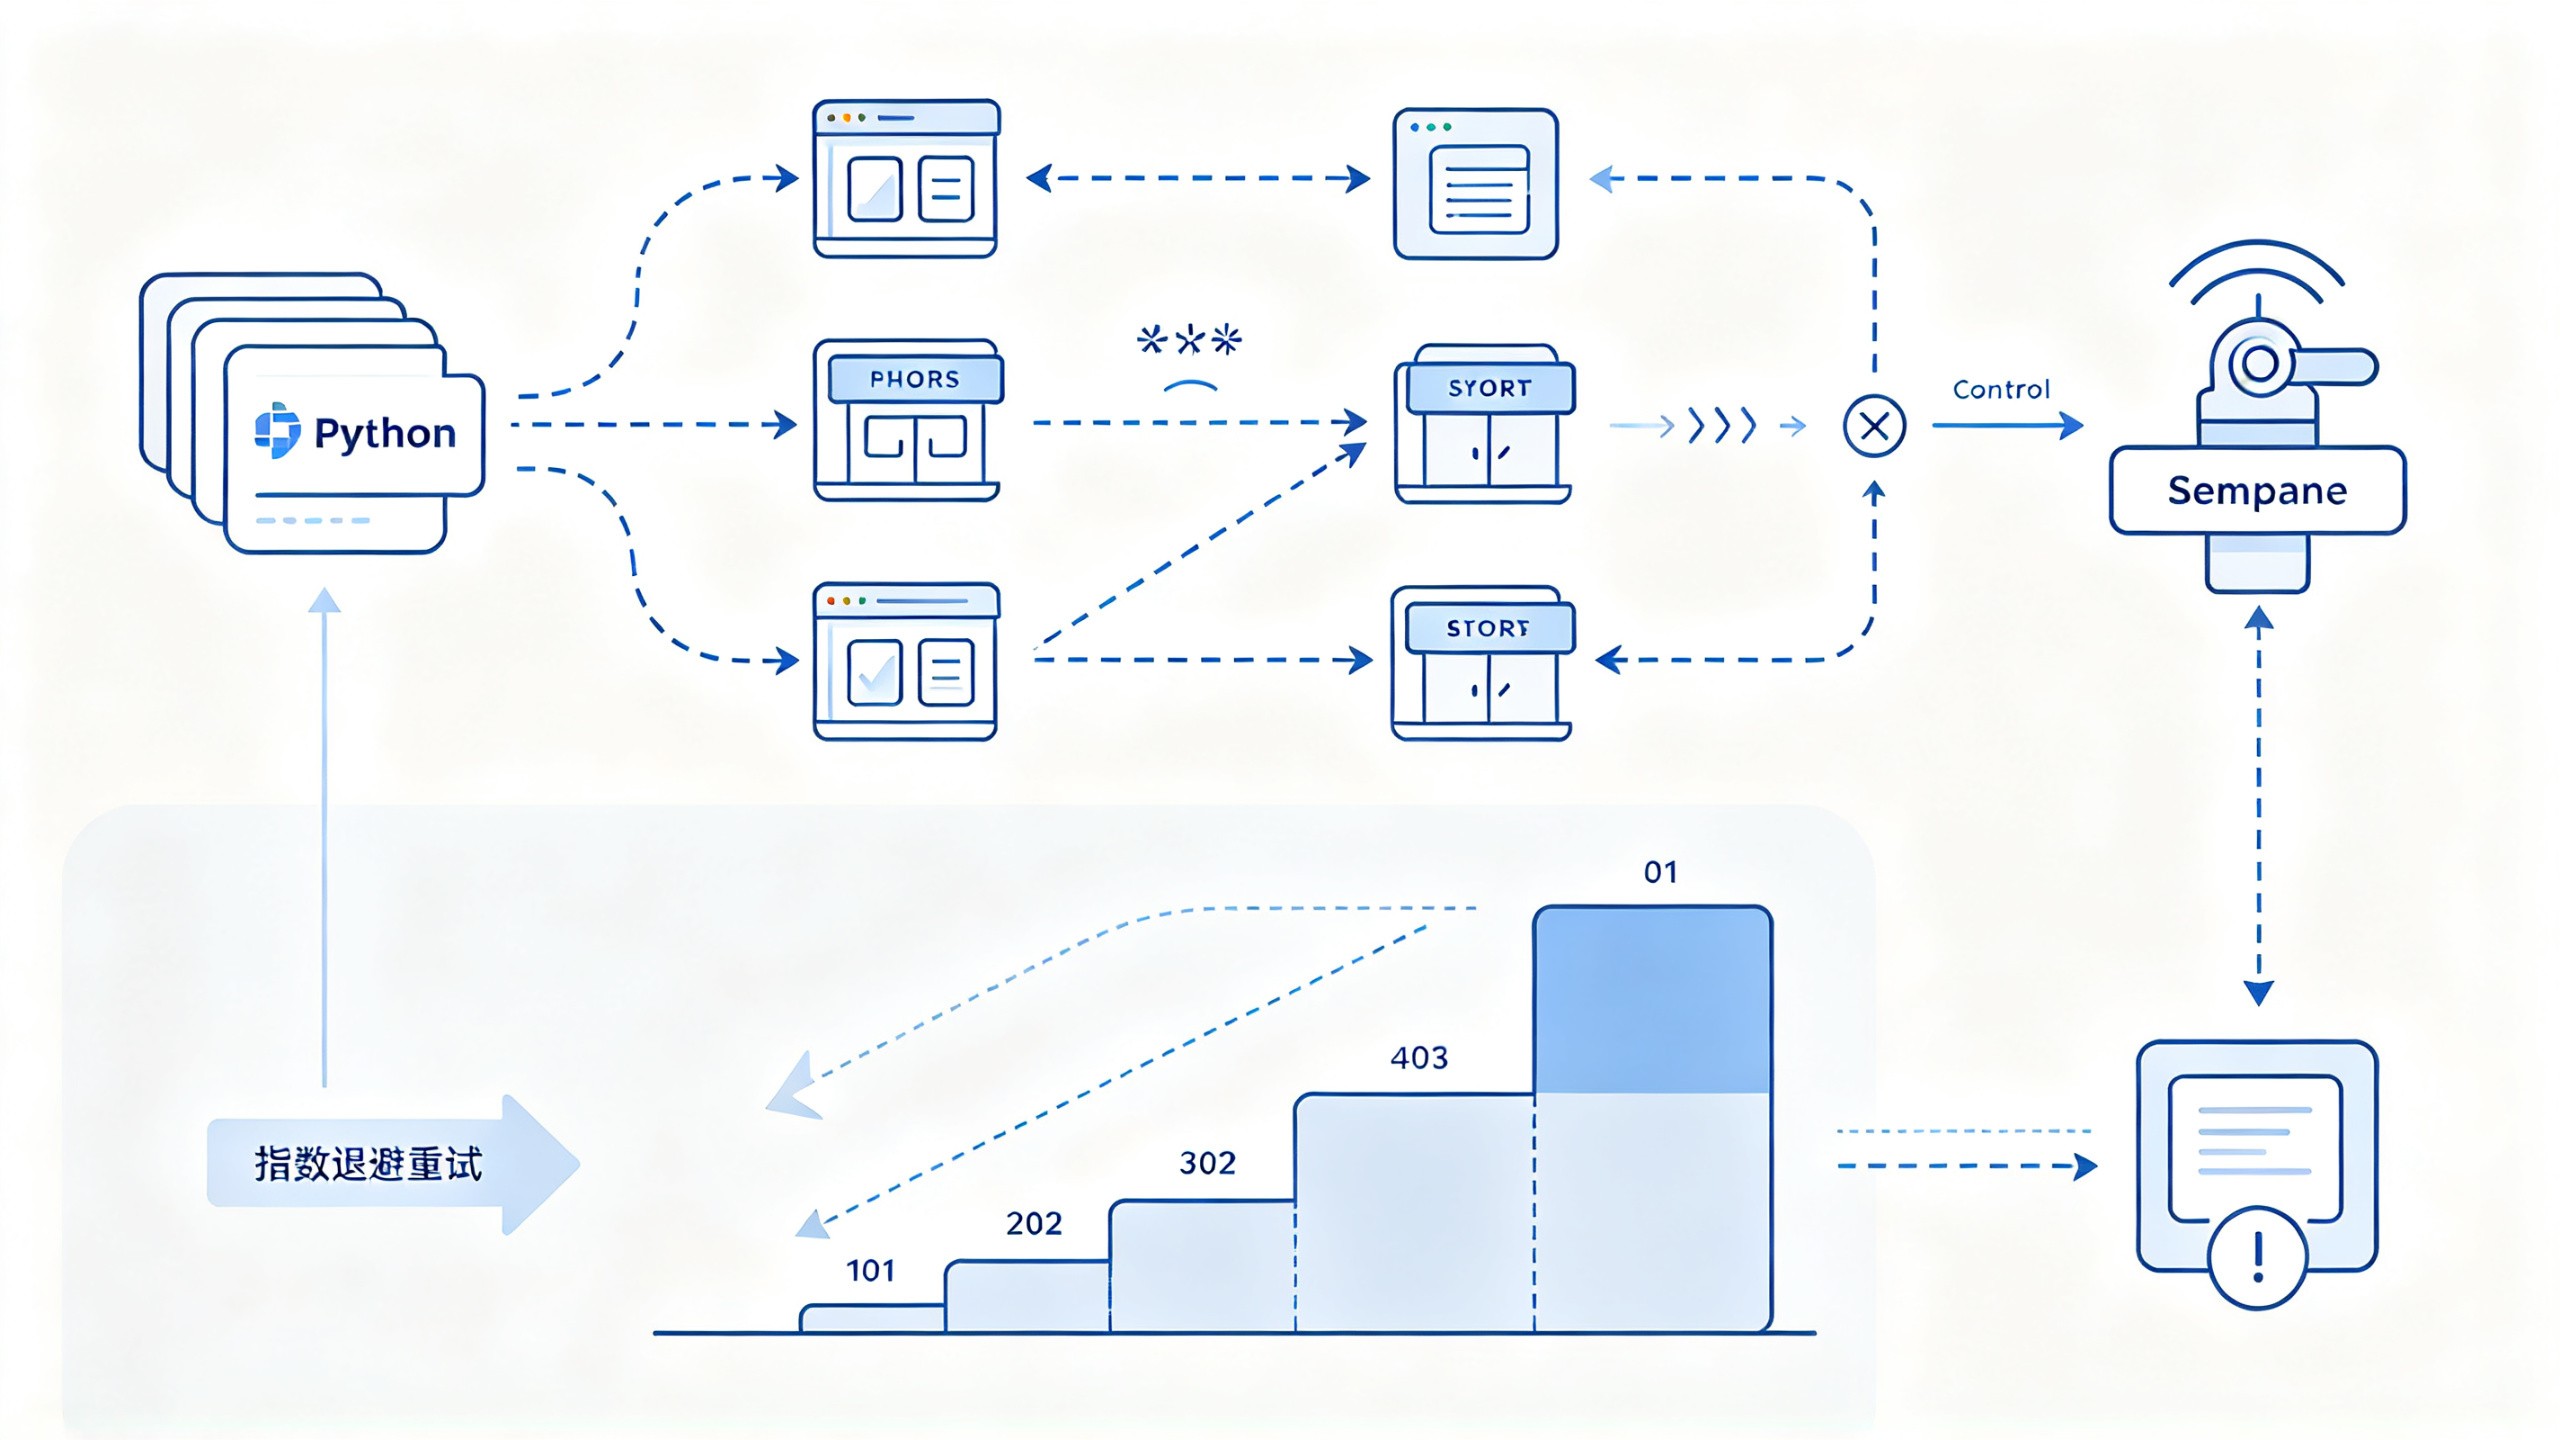
监控工具本质上是一个自动化请求程序,所以必须对目标服务器保持基本的尊重。我的策略是:
把轮询间隔设置为 15 到 30 秒随机化,避免像定时炸弹一样在同一秒发出请求。
每次请求之间引入 0.5 到 2 秒的随机延迟,打散请求节奏。
单轮查询完所有门店后必须休息一轮,不做持续高频请求。
失败时采用指数退避重试,比如首次等待 2 秒、第二次 4 秒、第三次 8 秒,最多重试 3 次。
注意:任何网站的接口都不是给你无限刷的。监控工具的价值在于“知道何时有货”,而不是“把服务器干趴下”。保持低频、随机、克制,是对自己账号安全也是对服务商基本的尊重。
这个部分是整个项目里最需要你坚守原则的地方。AI 不会主动告诉你“你这个频率太高了”,但它写出来的代码会默默把你推向风险边缘。作为项目负责人,把握节奏的必须是你。
4. 实操过程:我是怎么用 Codex 一步步把工具搭起来的
4.1 第一次对话的关键提示词
用 Codex 写项目,最重要的不是它的能力,而是你“怎么描述需求”。我第一次给的提示词就踩了坑,只写了一句“帮我写个苹果库存监控”,结果是代码跑倒是能跑,但什么都没监控到——因为我不知道具体产品编码,也没告诉它怎么获取数据源。
后来我重构了提示词,把目标拆成了几层:
我要做一个苹果官网库存监控工具。

目标:
1. 根据我提供的产品编码,查询附近门店的可用库存。
2. 每 20 秒轮询一次,如果某个门店的库存状态发生变化,就发送通知。
3. 通知方式先接企业微信机器人,后续再加 Telegram。

已知信息:
- 我在 config.py 里提供一个 STORE_LIST,包含门店 id、名称、经纬度。
- 库存接口可以抓包获取,先按这种 URL 格式写:`[地址已省略]。
- 返回的 JSON 结构我待会儿会贴给你。

请在项目目录里初始化 Python 项目,并保证代码可直接运行。
这个提示词的关键在于:我给了 Codex 明确的“验收标准”和“已知条件”,而不是让它在真空中猜测。它对业务的理解完全来自我的话,我给得越具体,它做出来的东西就越贴近真实需求。
4.2 Codex 的完整工作流程实录
Codex 的交互方式很像在终端里“远程指挥”一名工程师。我观察下来,它会自己执行这么几步:
扫描当前目录,确认有没有现成的项目结构。
创建虚拟环境和依赖文件,安装
httpx
、
apscheduler
等库。
按我描述的目标分模块写代码,先写核心抓取,再写通知。
运行测试脚本,观察输出。
遇到报错时,自己读 traceback,定位问题,修改代码,重新运行。
让我比较惊艳的一个场景是:第一版代码跑起来后,出现了
json.decoder.JSONDecodeError
,原因是我给的接口地址是示意性的,返回的是 HTML 而不是 JSON。Codex 没有干等,它自己去分析响应内容,尝试从 HTML 里找到库存字段,然后调整了解析逻辑。这种“发现问题—分析原因—自动修复”的闭环,是传统 AI 补全工具完全做不到的。
当然,它也有让我无语的时候。比如它会把我的示意接口地址当成真实地址,努力尝试“修正”它。这时候我就得提醒它:接口地址我是占位的,真实地址需要抓包拿到,你先别在这个上面死磕。这里也体现了人类的必要性:AI 缺乏外部世界的真实信息,需要你给它提供“现实数据”。
4.3 人工验收:AI 写的代码不能直接信任
Codex 写完全部代码后,我做了一次系统的验收,主要查几个点:
请求频率是否合理
:看主循环里有没有写死的短间隔,有没有随机延迟。
异常处理是否健壮
:网络请求失败时会不会导致整个程序崩溃。
通知内容是否清晰
:推送消息有没有包含门店名、产品名、当前状态。
对比逻辑是否准确
:状态变化时,是“有货 => 无货”和“无货 => 有货”都能触发,还是只触发其中一种。
我检查后发现 Codex 的一个典型问题:它把“有货”判定写成了一个固定布尔值,但真实接口返回的状态字段可能是“available today”“unavailable”之类的字符串,甚至包含数量。这种“AI 对字段理解的偏差”如果不在验收阶段发现,上线后就会变成漏报。
我给它补充了字段样例后,它很快调整了判断逻辑。这个过程中我的角色是“测试工程师”,而非“编码工程师”。这也说明了一个趋势:AI 编程时代,人的核心能力正从“怎么写代码”转向“怎么定义好问题,以及怎么验收答案”。
5. 实战避坑:测试和上线过程中踩过的那些坑
5.1 代码没问题,但接口被风控了
第一版工具上线后,我美滋滋地等着通知。结果跑了不到 20 分钟,发现所有请求都返回空数据,像是被“静静屏蔽”了。排查了半天,不是代码逻辑问题,而是请求频率太高,触发了服务端的风控。
解决办法是调整策略:把轮询间隔从 10 秒拉到 30 秒,并且每次请求都带上短暂的随机延迟。另外我给每个请求加上了更完整的请求头,包括
Accept-Language
和
Referer
,让请求看起来更像从浏览器页面发起的。调完之后,跑了整整一天,再没出现过被屏蔽的情况。
这个坑给我最大的教训是:
监控工具真正的敌人不是“接口不存在”,而是“你的请求姿势不正确”。
如果每次访问都像一个无感情的刷量机器人,服务商当然会给你上“冷静期”。
5.2 Codex 终端工具的经典报错:“local proxy failed while handling codex endpoint”
用 Codex CLI 的过程中,最常见的报错之一就是类似
cc switch local proxy failed while handling codex endpoint /responses.
这样的信息。它的大意是:Codex 在调用本地后端服务时,网络代理这一环出了问题,导致请求没能送到 Codex 的接口服务上。
我遇到这个问题的场景很典型:频繁切换网络环境后,Codex 突然开始报错,代码写一半根本没法继续。解决思路如下:
先检查本地代理配置是否和当前网络环境匹配。很多开发者会配置本地 HTTP 代理工具来调试接口,如果代理规则没更新,所有请求都可能被卡住。
清理 Codex 的配置缓存,重新登录确认会话状态。
升级 Codex CLI 到最新版本,新版本对网络异常的容错通常更好。
这个报错本身不是代码问题,而是运行环境问题。我的习惯是遇到这类网络层问题,先不急着改代码,而是理清调试工具、系统代理、应用配置这三层关系,再逐层排查。
5.3 模型不支持的报错:“model is not supported”
有一次我更新 Codex 后,运行时报了类似
the 'gpt-5.6-sol' model is not supported when using codex
的错误。原因是我的配置文件中指定了一个当前版本 CLI 不支持的模型名,或者本地版本太旧,不认识新模型。
解决方式很简单:检查
config.toml
里的
model
配置,改成你当前可用、受支持的模型名;或者升级 CLI 版本,让配置项和实际运行环境匹配。这类问题都需要你先冷静看一下报错信息里的关键词,“not supported”指向的就是配置和版本不匹配。
5.4 配置文件告警:“unrecognized configuration setting”
Codex 对配置文件的解析是很严格的。有一次我在配置文件里加了一行自定义参数,结果启动时给了个警告:
codex is ignoring 1 unrecognized configuration setting. Check for typos or deprecated keys.
翻译过来就是“有个配置项我没认出来,我给忽略了”。
这类问题一定要重视。配置被忽略,意味着某些行为不会按你预期工作。可能你自以为设置了某个开关,实际却用的是默认值。解决办法是逐个检查配置项,删除已经废弃的键,或者查文档确认最新写法。
5.5 通知渠道对比与选型
监控工具最后一步是把结果送到你手上,通知渠道的选择也很重要。我实际用过三类:
| 渠道 | 优点 |
|---|
缺点
|
适合场景
| | Server酱 | 配置简单,微信公众号推送 |
|---|
需要申请 Key,依赖第三方平台
|
个人自用,快速上手
| | 企业微信机器人 | 推送速度快,可以发普通文本和 Markdown |
|---|
需要创建企业微信群
|
手头有现成群,通知比较稳定
| | Telegram Bot | 全球可达,API 开放,机器人配置简单 |
|---|
部分网络环境下访问不稳定
|
已有 Telegram 使用习惯的用户
|
我最后选的是企业微信机器人 + Server酱双路通知。原因是可靠性优先:万一其中一个通道服务波动,另一个还能兜底。通知消息里我会带上门店名称、具体型号、库存状态和查看链接,减少收到通知后还要自己去产品反复确认的时间。
6. 常见问题与排查技巧实录
用 AI 做项目,最磨人的其实不是 AI 本身,而是它出错时你怎么定位。我整理了一份自己真实的排查记录,按“症状—原因—处理”的格式放在下面,方便你对照。
| 症状 | 可能原因 |
|---|
处理方式
| | 程序运行后没有拿到任何数据 | 接口地址是占位符,或者返回结构解析失败 |
|---|
打开浏览器开发者工具,重新抓包确认真实接口和字段
| | 请求返回 429 或空数据 | 请求频率太高触发风控 |
|---|
调大轮询间隔,加随机延迟,补全请求头
| | 有货时不通知,无货时乱通知 | 对比逻辑只判断了单一方向的状态 |
|---|
检查 compare 模块,确保“从无到有”和“从有到无”都触发
| | 推送偶尔延迟超过 5 分钟 | 通知服务本身不稳定,或者网络链路有问题 |
|---|
配置双路通知,用备用通道兜底
| | Codex 半天不动,像是在“死循环” | 任务目标不清晰,或它在一个分支里绕不出来 |
|---|
中断会话,重新描述需求,给出现有的代码文件和明确的下一步
| | 代码能跑,但换一个产品编码就失效 | 硬编码了产品编码或门店信息 |
|---|
把可变参数全部抽到 config.py,代码里禁止出现业务常量
| | 程序崩溃后没有自动恢复 | 缺少异常捕获和重启机制 |
|---|
给主循环加 try/except,配合 systemd 或 supervisor 常驻运行
|
这里我想特别强调“硬编码”这个问题。Codex 第一版写出来的东西特别倾向于把产品编码、门店列表直接写在函数参数里,看起来方便,但换一个型号就要改代码。我后来专门花了一轮会话让它把配置全部外置,过程和结果都清爽了很多。
还有一个容易被忽视的细节:监控工具跑的时间长了,会产生大量日志。如果不做日志轮换,磁盘很快会被撑满。我给 Codex 加了一个按天滚动写入日志文件的需求,它写得很干净,这样即使工具连续跑几个月,也不会把机器拖垮。
7. 扩展思路:这个项目还能玩出什么花
等库存监控跑稳定之后,你会发现整个架构可以迁移到各种“信息差”场景。核心模式都是一样的:
低频轮询公共接口 + 状态变化检测 + 即时通知
。比如:
监控某个购物网站的商品降价,把“库存状态”替换成“价格字段”,对比逻辑从“是否有货”改成“价格是否低于阈值”。
监控场馆票务平台的余票,逻辑几乎一模一样。
监控某个查询接口返回的特定关键字,比如新版本固件发布公告。
更有意思的是,你可以让多个 AI Agent 参与这个项目,一个负责写代码,一个负责审查代码,一个负责写测试用例。多 AI 协作的意义在于互相当“质检员”,能够显著降低单个模型产生的盲区。我在这个项目的后期测试脚本就是让另一个 AI 会话帮忙写的,它确实找出了一些边界问题。
这个经验也再次说明了一件事:在 AI 编程时代,你的工作重心会从“亲手写每一行代码”迁移到“设计系统、定义验收标准、整合多个 AI 的产出”。这就像一个制片人,不再需要自己扛摄影机,但必须知道每个镜头要拍什么,以及怎么判断拍得好不好。
我个人的体会是,Codex 这类工具最大的价值不是“帮你省时间”,而是“帮你找回做小项目的主动权”。以前很多念头因为“工程量太大”而被搁置,现在只需要把目标描述清楚,AI 就能在半小时内把骨架搭起来。你依然需要理解代码逻辑、理解业务边界、理解风控规则,但这种“理解”的成本,已经比“从零手写”低太多了。
如果你手头也有一个“要是能自动盯着就好”的小需求,我建议你直接打开 Codex,用这篇文章里的提示词结构试一试。第一次跑通之后你会感受到,真正困难的从来不是写代码,而是想清楚你到底想要什么。