

iOS 5.6被拒到多次被拒:资质、元数据与包体三步排查整改全流程
问题引入:5.6被拒为什么容易滑向封号
不少开发者第一次收到 5.6 拒审时,会先改元数据或换关键词再次提审,以为只是普通功能问题。这里有个容易忽略的前提:Guideline 5.6 对应的是审核方认为应用存在操纵审核、误导审核或规避审核的行为。和普通功能问题不同,5.6 拒审之后,审核方会重点看你提交的整改是否真实、是否前后一致。消极处理或重复提审,账号进入封禁流程的概率会明显上升。本文面向 iOS 开发者与技术团队,梳理从 5.6 被拒到多次被拒后的排查与整改流程,包括资质核对、元数据一致性、包体相似度检测与提审前检查清单。
一、先判断 5.6 具体指向哪类风险
不要只看 5.6 这个编号,要结合 Resolution Center 原文、附件截图和你的提审记录判断。常见的三类入口:
- 资质边界问题:提交了与主体资质不符的应用类型。个人开发者提交模拟赌博、金融等敏感品类,属于典型的资质越界。
- 元数据与包内实际内容不符:截图、描述、关键词展示了包内没有的功能,或展示的界面无法在包内实际触发。
- 提审方式被判定为规避审核:隐藏功能、审核期间动态下发内容、包体内存在与描述无关的模块。
先写一句结论:是资质问题、元数据问题还是包体问题。结论不同,整改动作完全不同。把结论写在自查记录里,再决定下一步。
二、分步整改流程
第一步:冻结提审,建立时间线
收到 5.6 拒审后,不要在原包上做小改动直接重新提交。先记录被拒版本号、被拒时间、拒审条款和原文,整理成时间线。时间线能帮你判断:同一个问题是否已经反复出现多次,以及每次提审之间是否真的完成了整改。
第二步:核对主体资质
如果你的 App 落在受限品类,先确认个人账号是否具备提交资格。该案例中被拒邮件明确提到,只有经批准的企业主体才可提交赌博类应用。资质不符时,继续改包体没有意义,应先调整产品定位或申请合规主体,而不是反复换描述再提审。

上图是被拒邮件中的资质说明片段,可对照自己的拒审原文判断是否属于同类问题。
第三步:核对元数据与包体一致性
逐条比对各语言的描述、截图、关键词和预览视频,确认所有展示的界面和功能都能在包内实际触发,且不依赖审核期之后才下发的开关。常见的坑是:描述里写了会员对比页,包里其实只做了一个静态占位页;截图里展示了社交功能,包内该模块被远端配置关闭。
第四步:检查包体相似度
如果团队同时维护多个应用,或者采购过源码二次开发,5.6 常和 4.3 一起出现。提审前建议做 IPA 相似度检测,观察业务二进制、资源、目录结构和相同文件的比对结果,避免被判定为重复应用。检测维度包括:
- 校验上传文件完整性与基础格式;
- 识别开发语言(uni-app、Flutter、React Native、OC&Swift 等);
- 提取应用元信息、目录与文件统计;
- 分析 Mach-O 二进制结构与指纹;
- 对比元数据与资源、目录结构相似度;
- 检测控制流、数据流与语义线索;
- SHA-256 精确匹配相同文件;
- 生成评分、表格与建议报告。
检测报告中的评分和维度可作为自查依据,但不替代审核结论,也不能用来预测审核结果。
第五步:撰写整改说明
在 Resolution Center 回复时只陈述可核验的事实:改了什么、在哪一版生效、如何验证。不要承诺「已完成」「保证合规」这类无法核对的表述,也不要解释成「误会」。如果确实涉及资质问题,就如实说明当前状态和后续安排。
三、被拒多次后封号前的止损动作
如果 5.6 已经被拒多次,账号状态开始异常,建议立即停止重复提审,转而做一次完整自查:
- 整理所有被拒版本与被拒条款,确认是否存在同一问题反复出现。
- 确认是否在回复中提供了不实信息,这会直接影响账号存续。
- 暂停全部关联应用的提审,避免触发主体级别的连锁处理。
- 如涉及资质问题,在整改完成前不再提交同类应用。
需要说明的是,封号判定由审核方作出,本文无法承诺任何申诉结果,也不提供规避审核的做法。以下清单只用于提高自查完整度。
四、提审前检查清单
<table><tbody><tr><th><p>检查项</p></th><th><p>通过条件</p></th></tr><tr><td><p>主体资质</p></td><td><p>敏感品类已确认符合提交主体要求</p></td></tr><tr><td><p>元数据一致性</p></td><td><p>描述、截图、关键词均可在包内触发</p></td></tr><tr><td><p>包体独立性</p></td><td><p>已做过相似度检测,无异常重复</p></td></tr><tr><td><p>整改说明</p></td><td><p>只包含可核验事实,无夸大承诺</p></td></tr><tr><td><p>提审节奏</p></td><td><p>同一问题未整改完成前不提审新版本</p></td></tr></tbody></table>
五、结语
5.6 被拒的核心不是「改哪里」,而是「是否真实、是否匹配资质」。把资质、元数据和包体三件事核对清楚,再决定提审节奏,比反复试错更省时间。本文提到的工具能力与资质条款分别来自对应资料,具体审核结果仍以审核方通知为准。
问题引入:5.6被拒为什么容易滑向封号
不少开发者第一次收到 5.6 拒审时,会先改元数据或换关键词再次提审,以为只是普通功能问题。这里有个容易忽略的前提:Guideline 5.6 对应的是审核方认为应用存在操纵审核、误导审核或规避审核的行为。和普通功能问题不同,5.6 拒审之后,审核方会重点看你提交的整改是否真实、是否前后一致。消极处理或重复提审,账号进入封禁流程的概率会明显上升。本文面向 iOS 开发者与技术团队,梳理从 5.6 被拒到多次被拒后的排查与整改流程,包括资质核对、元数据一致性、包体相似度检测与提审前检查清单。
一、先判断 5.6 具体指向哪类风险
不要只看 5.6 这个编号,要结合 Resolution Center 原文、附件截图和你的提审记录判断。常见的三类入口:
- 资质边界问题:提交了与主体资质不符的应用类型。个人开发者提交模拟赌博、金融等敏感品类,属于典型的资质越界。
- 元数据与包内实际内容不符:截图、描述、关键词展示了包内没有的功能,或展示的界面无法在包内实际触发。
- 提审方式被判定为规避审核:隐藏功能、审核期间动态下发内容、包体内存在与描述无关的模块。
先写一句结论:是资质问题、元数据问题还是包体问题。结论不同,整改动作完全不同。把结论写在自查记录里,再决定下一步。
二、分步整改流程
第一步:冻结提审,建立时间线
收到 5.6 拒审后,不要在原包上做小改动直接重新提交。先记录被拒版本号、被拒时间、拒审条款和原文,整理成时间线。时间线能帮你判断:同一个问题是否已经反复出现多次,以及每次提审之间是否真的完成了整改。
第二步:核对主体资质
如果你的 App 落在受限品类,先确认个人账号是否具备提交资格。该案例中被拒邮件明确提到,只有经批准的企业主体才可提交赌博类应用。资质不符时,继续改包体没有意义,应先调整产品定位或申请合规主体,而不是反复换描述再提审。
上图是被拒邮件中的资质说明片段,可对照自己的拒审原文判断是否属于同类问题。
第三步:核对元数据与包体一致性
逐条比对各语言的描述、截图、关键词和预览视频,确认所有展示的界面和功能都能在包内实际触发,且不依赖审核期之后才下发的开关。常见的坑是:描述里写了会员对比页,包里其实只做了一个静态占位页;截图里展示了社交功能,包内该模块被远端配置关闭。
第四步:检查包体相似度
如果团队同时维护多个应用,或者采购过源码二次开发,5.6 常和 4.3 一起出现。提审前建议做 IPA 相似度检测,观察业务二进制、资源、目录结构和相同文件的比对结果,避免被判定为重复应用。检测维度包括:
- 校验上传文件完整性与基础格式;
- 识别开发语言(uni-app、Flutter、React Native、OC&Swift 等);
- 提取应用元信息、目录与文件统计;
- 分析 Mach-O 二进制结构与指纹;
- 对比元数据与资源、目录结构相似度;
- 检测控制流、数据流与语义线索;
- SHA-256 精确匹配相同文件;
- 生成评分、表格与建议报告。
检测报告中的评分和维度可作为自查依据,但不替代审核结论,也不能用来预测审核结果。
第五步:撰写整改说明
在 Resolution Center 回复时只陈述可核验的事实:改了什么、在哪一版生效、如何验证。不要承诺「已完成」「保证合规」这类无法核对的表述,也不要解释成「误会」。如果确实涉及资质问题,就如实说明当前状态和后续安排。
三、被拒多次后封号前的止损动作
如果 5.6 已经被拒多次,账号状态开始异常,建议立即停止重复提审,转而做一次完整自查:
- 整理所有被拒版本与被拒条款,确认是否存在同一问题反复出现。
- 确认是否在回复中提供了不实信息,这会直接影响账号存续。
- 暂停全部关联应用的提审,避免触发主体级别的连锁处理。
- 如涉及资质问题,在整改完成前不再提交同类应用。
需要说明的是,封号判定由审核方作出,本文无法承诺任何申诉结果,也不提供规避审核的做法。以下清单只用于提高自查完整度。
四、提审前检查清单
<table><tbody><tr><th><p>检查项</p></th><th><p>通过条件</p></th></tr><tr><td><p>主体资质</p></td><td><p>敏感品类已确认符合提交主体要求</p></td></tr><tr><td><p>元数据一致性</p></td><td><p>描述、截图、关键词均可在包内触发</p></td></tr><tr><td><p>包体独立性</p></td><td><p>已做过相似度检测,无异常重复</p></td></tr><tr><td><p>整改说明</p></td><td><p>只包含可核验事实,无夸大承诺</p></td></tr><tr><td><p>提审节奏</p></td><td><p>同一问题未整改完成前不提审新版本</p></td></tr></tbody></table>
五、结语
5.6 被拒的核心不是「改哪里」,而是「是否真实、是否匹配资质」。把资质、元数据和包体三件事核对清楚,再决定提审节奏,比反复试错更省时间。本文提到的工具能力与资质条款分别来自对应资料,具体审核结果仍以审核方通知为准。
收起阅读 »
个人开发者账号升级公司账号:邓白氏编码申请与苹果电话审核关键步骤
经常有人问我:“我做App已经两三年了,账号一直是用个人名义注册的苹果开发者账号,现在想升级成公司开发者账号,该怎么操作?会不会很麻烦?”说实话,这个流程确实比重新注册一个公司账号要绕,但也没那么玄乎。关键在于两件事:一是邓白氏编码(D-U-N-S Number)能不能顺利拿到,二是苹果的电话审核能不能一次通过。搞明白这两点,整个升级流程基本就能顺畅走完。
这篇文章就是一份完整的苹果开发者账号从个人(Individual)升级为公司(Organization)的操作指南。我会把升级前的资质准备、邓白氏编码申请、苹果后台的具体点击路径、电话验证应答要点,以及整个流程里最容易踩的坑全部拆开讲清楚。无论你是因为上架App需要显示公司名称,还是因为要接入微信支付、Apple Pay这类需要公司主体才能开通的服务,这篇文章都适用。

1. 为什么要把个人开发者账号升级成公司开发者账号
1.1 个人、公司、企业三种账号到底差在哪
苹果开发者账号分三类,很多人分不清个人账号(Individual)和公司账号(Organization)的区别,更有人把公司账号和企业账号(Enterprise)搞混,这里先花点时间把底层的逻辑理清楚。
个人开发者账号(Individual)年费是99美元,注册时只需要提供个人身份信息,App Store里显示的开发者名称是你的个人姓名。这个账号适合个人开发者、独立开发者,或者还在试水阶段的小项目。所有涉及到真实企业资质的服务基本都开不了,比如微信开放平台、支付宝开放平台里不少接口要求App的开发者主体必须是企业,遇到这类审核你只能干瞪眼。
公司开发者账号(Organization)年费同样是99美元,但需要提供公司营业执照、邓白氏编码等企业资质。App Store里显示的开发者名称是公司的英文名称。绝大多数需要企业主体才能申请的服务,比如Apple Pay、Sign in with Apple、微信支付、苹果的某些特殊能力,都必须基于公司账号才能开通。
企业开发者账号(Enterprise)年费是299美元,只用于企业内部App分发,不上App Store,审核严格,必须有苹果的企业资质审批。这个不是普通人玩的路径,大多数人也不需要。
简单总结就是:个人账号是入门版,公司账号是正式版,企业账号是内部分发专用。标题说的“个人开发者账号升级成公司开发者账号”,走的就是从入门版到正式版的升级路径。
1.2 升级之后到底多了什么
从开发者后台功能上看,个人和公司账号的会员权限其实基本一致,能上传App、能管理TestFlight、能看崩溃日志,这些没有本质区别。那升级的意义在哪?我用实际场景说。
最大的变化是主体变化。个人版开发者名称是你的姓名,公司版开发者名称是公司名。用户在App Store详情页看到开发者名称,个人姓名和公司名的信任感完全不在一个量级。尤其做金融、医疗、工具类App,一个带公司名的壳很重要。
第二个变化是财务和税务信息的录入维度不同。公司账号可以填写公司的银行账户、税务信息、发票抬头,个人账号只能走个人结算渠道。如果你的App涉及内购分成收入,或者需要合规性报税,公司主体的重要性是实打实的。
第三个变化是权限管理和团队协作。公司账号下可以邀请团队成员加入App Store Connect,设置不同的职能角色(管理员、财务、开发者、营销等),个人账号虽然也能邀请成员,但财务、税务、签名等敏感操作的主体还是你个人。一旦拉到公司层面,账号归属和管理边界必须清晰,这就是升级的必要性所在。
你原本的个人账号下的App、应用ID、证书、推送密钥、TestFlight记录,升级成功后都会原样保留,App不会被下架,用户也不用重装。这一点苹果处理得算厚道。
2. 升级前要准备的材料与资质
2.1 必备材料清单
升级这个动作可不是直接改个名就行,你需要提前把以下几样东西准备好,缺一样流程都会卡住。
公司营业执照(必须)。必须是有效的、处于存续状态的公司营业执照,个体户执照在不少地区也能走通,但苹果审核时会更严格,建议如果是个人独资企业或个体工商户,先咨询一下苹果客服再操作。
邓白氏编码(必须)。这是整条链路里最麻烦、最容易出问题的一环。邓白氏编码是 Dun & Bradstreet 公司为企业分配的唯一全球企业标识,类似企业的身份证号。苹果通过这个编码来核对你的公司主体是否真实存在、地址和电话是否对得上。这个编码不是苹果颁发的,需要向邓白氏官方申请,正常周期是3到10个工作日,赶上节假日可能拖到两周以上。
企业邮箱(强烈建议)。升级后的公司账号建议使用以公司域名结尾的企业邮箱作为主要联系方式,比如 。如果你用QQ邮箱或163邮箱,虽然也能过,但苹果后台的邮件往来和后续安全验证都会显得很业余,部分国家的审核员也会对个人邮箱发来的公司变更申请多打几个问号。
公司产品(建议有)。产品不是硬性要求,但苹果审核时经常通过你提交的公司域名来验证业务真实性。如果没有产品,用公司介绍页、公众号、小程序页面也能凑合,但产品是成本最低的信任凭证。
工作日可接听的审核联系电话(必须)。注意,这一步是整个流程中最容易翻车的地方。苹果在审核公司主体时,会打电话给你在后台填写的电话,通过电话来核实公司名称、地址、邓白氏编码等关键信息。这个电话是工作日打来的,一定要保证电话能接通,且接电话的人知道有这回事。
2.2 邓白氏编码的查询与申请渠道
很多人在申请邓白氏编码时,第一反应是去中国区D&B产品填表,结果填了半天没有下文。我先说结论:D&B产品有自己的申请入口,苹果也给你提供了一个间接申请通道,后者往往更快,因为苹果合作的审批链路是独立的。
另一个常见场景是:你在后台提交升级申请时,苹果会让你填邓白氏编码,但如果你还没有,系统会提供“Request D-U-N-S Number”的选项,相当于苹果会帮你把申请请求转到邓白氏那边。这个方式的好处是,你的申请会带标签(Apple Store Connect关联),审核优先级通常比自行在D&B产品递交要高。
我自己实测下来的建议是:升级流程的第一步先别去苹果后台,直接在D&B产品提交申请,拿到九位数的邓白氏编码后再去苹果后台填。别问我为什么,问就是苹果转发的申请有“沙箱”概率,你需要耐心等更新周期,不如自己主动把编码先拿到手。
3. 邓白氏编码申请实操流程
3.1 提交申请前的信息核对
邓白氏编码申请过程中最耗时的不是审核,而是反复修改信息。最常见的问题就是公司名称、地址、电话和注册地不一致,导致系统匹配失败。所以,在你打开申请页面之前,先花15分钟把下面几项信息统一到完全一致。
企业名称要用营业执照上的法定名称,中英文都要有。英文名建议用营业执照拼音直译或公司注册的正式英文名,比如“上海某某网络科技有限公司”对应“Shanghai Some Network Technology Co., Ltd.”。这个英文名之后会显示在App Store详情页,尽量核对好。
公司地址尽量精确到门牌和楼层,并且与营业执照上的地址一致。如果你在实际运营地址办公,可不可以填运营地址?
申请时预留的联系邮箱建议使用企业邮箱,电话填写能正常接听的座机或手机号码。如果预留手机号,也不要关闭防骚扰拦截,D&B经常从某一个较冷门的号码打过来,一旦被拦截就半天没有动静了。
3.2 申请环节的操作细节
表单里会要求填写公司中英文名、营业执照号码、统一社会信用代码、公司地址、联系方式、申请人信息等。填写时需要注意:
公司名称务必与营业执照完全一致,包括括号及括号中间的内容。中文名和英文名都不要省略任何词。
统一社会信用代码是18位,别填错,这是D&B核对工商信息的核心依据。
联系电话建议同时填写座机和手机。座机号最好是对外公布的,因为D&B会按公开数据库信息来核对。
提交完成后,D&B会让你选择行业分类,一般选“软件开发”或“互联网服务”即可。完成后会给你一个申请编号,建议截图保存,后期查询进度会用到。
这里要强调一下:D&B的中文产品上有个“快速查询”功能和“申请编码”功能,很多人会混淆。查询功能是看你的公司是否已有编码,如果不确定公司之前是否申请过邓白氏编码,先用查询入口查一下,不要盲目重复申请。重复申请会导致多条邓白氏记录,反而拖慢审核。
3.3 邓白氏审核周期与加速技巧
D&B审核周期通常在3到10个工作日之间,但实际会被各种因素拉长。我在操作过程中总结了几条缩短完成时间的经验:
第一,提交时把公司的产品地址写清楚。D&B审核人员会根据产品中展示的公司地址、联系方式来人工比对,如果你的产品信息与申请信息完全一致,审核基本是一次过,周期往往能压在5个工作日内。
第二,提交后第2个工作日主动联系中文客服或英文客服索要申请进度。D&B是有客服电话和邮件工单通道的,你主动询问的同时,对方也会查看你的待处理工单,把卡住的问题暴露出来。我试过两次,每次催完都能在隔天收到回复。
第三,如果7个工作日后还没有结果,直接给D&B的全球客服发邮件,写清楚公司全称、申请编号、提交时间,并说明是申请Apple Developer账号需要。带上“Apple”关键词通常会提高处理优先级,这不是玄学,是这条申请链路是D&B专门为苹果生态服务的一部分,有单独的标注。
一旦拿到邓白氏编码,建议先记录下来,再回到D&B产品的查询页面,把编码对应的公司名称、地址、电话截图留存,因为后面的苹果审核会用到这些信息,且号码必须与后台填写的信息一模一样。
4. 苹果开发者后台升级操作全流程
4.1 登录后台发起升级
邓白氏编码到手后,进入App Store Connect后台,当前账号是个人开发者类型,页面上会显示“Individual”标识。
登录后点击“用户和访问”,在顶部菜单栏的“协议、税务和银行业务”区域,或者在账号设置的首页,应该能看到一个按钮“升级为组织”或“Enroll as Organization”。这个入口偶尔会因为苹果改版而移位,但核心逻辑没变:个人账号会常驻一个切换主体类型的入口。
点击升级入口后,系统会重新引导你走一遍公司注册页面,让你选择“Organization”,然后填写公司名称、邓白氏编码、公司地址和产品等信息。这里填写的公司名称和你邓白氏编码对应的名称必须完全一致,大小写无所谓,但顺序和用词不能改。
这里有个容易错的点:苹果后台的“公司名称”填的是营业执照上的中文名还是英文名?答案是英文名。苹果开发者后台全英文操作,填英文公司名才是后面App Store详情页显示的法人名,营业执照中文名并不会直接出现在前台页面。如果你公司有对外正式英文名,就直接用;如果没有,用中文名拼音直译即可。

4.2 提交公司信息与法律实体资料
在这个阶段,苹果会让你确认法律实体类型,一般选“Corporation”,少数选“Partnership”或“Sole Proprietorship”,对应的就是有限公司、合伙企业和个体户。
其中有一点要特别注意:苹果审核人员有时会要求你提供营业执照扫描件、法人身份证扫描件、地址证明文件(如水电费账单),甚至在极少数情况下会要求提供公司公章盖章文件。这些文件的格式要求是PDF或JPG,大小能控制在5MB以内即可。虽然升级流程在正常情况下不强制上传营业执照,但提前备好扫描件,能省去后续补材料的来回邮件时间。
再往后是填“SIC Code”(标准行业分类码)。这个码不一定每个地区都会要求填,但有时候会出现在表单里。软件开发对应的常用码是7371(Computer Programming Services),互联网相关服务可以用7372,如果你做的是硬件,就查一下对应码填上。
4.3 电话验证环节怎么应对
提交公司信息后,苹果不会马上通过,而是进入人工审核阶段。这个阶段的核心动作是电话验证。
苹果的电话验证通常有两种触发方式:一种是苹果审核团队直接打给你在后台留的审核联系电话,另一种是审核团队发邮件要求你预约某个时间拨打审核电话。无论哪种,电话那头问的消息基本都是固定套路:公司全名、公司地址、邓白氏编码、是否在App Store Connect提交升级申请、公司主营业务、是否使用第三方仓库等。
应对技巧就三条:第一,接电话的人对上述信息必须烂熟于心,建议把公司名称、地址、邓白氏编码、注册资本这些信息打印在桌上;第二,如果接电话的人不是法人,而是技术人员,也务必把你公司的主营业务说清楚,别回答“我不太清楚,我是做技术的”——我见过有人就是这么被延后的;第三,保持耐心,语气平静,回答简洁,不过度展开。
电话验证通过后,苹果后台会显示“正在处理”,同时你会收到一封邮件,说明审核团队已收到申请,正在核实公司信息。接下来就是等。
4.4 缴费与等待审核
升级公司账号不会再从你的账户里额外扣一次99美元年费,因为你的个人账号本身已经在生效周期内,苹果会直接把剩余周期迁到公司账号上。如果你是续费日临近的时段操作,升级成功后系统会按公司主体的身份到续费日重新计费,个人版的费用不会退回。这点要提前想好:尽量在个人版刚续费完毕后马上升级,这样你花一份年费,公司账号能用满一年;如果马上要续费了,先续费再升级更划算。
提交后一般3天内会收到结果通知,快的当天就能通过,慢的可能拖两周,极端情况需要四到六周,主要卡在邓白氏匹配不成功、电话打不通或公司信息与工商信息不符这三类情况。
审核通过后,你在App Store Connect首页看到的主体类型会从“Individual”变成“Organization”,App Store详情页的开发者名称也会逐渐同步成公司英文名。这个同步有延迟,通常需要两到三天,别刚升级完发现没变化就着急重新提交。
5. 常见问题与排查技巧实录
5.1 高频问题速查表
我把这几年操作中读者和客户最常问到的问题整理成了一张表,你可以直接按图索骥。
| 问题 | 原因 |
|---|
解决方案
| | 升级提交后五六天没消息 | 人工审核排队,或后台信息待补充 |
|---|
登录后台检查有没有邮件通知,主动发邮件到 App Store Connect 技术支持询问处理进度
| | 电话验证总打不通 | 预留电话被拦截、关机或无人接听 |
|---|
工作日保持电话畅通,关闭陌生号码拦截,重新进后台修改联系电话并追加邮箱说明
| | 邓白氏编码已在别处用过 | 同一公司有多个邓白氏编码记录 |
|---|
|
| 公司名称在App Store显示成个人名 | 升级未完成,或后台主体仍为Individual |
|---|
确认升级通过后等待两到三天,详情页名称会按公司主体刷新
| | 升级期间还能提交审核吗 | 不影响,苹果冻结的是主体变更而非App审核 |
|---|
可以在后台正常上传App、提交审核,保持操作正常即可
| | 要不要先取消个人版再注册公司版 | 不建议 |
|---|
直接升级最快,取消再注册会丢失原有App、证书和下载记录
| | 老App的Bundle ID会受影响吗 | 不受影响 |
|---|
App ID、Bundle ID、推送证书、Keys全部保留
| | 税务和银行信息要重新填吗 | 需要 |
|---|
升级成功后重新进入“协议、税务和银行业务”填写公司银行账号与税务信息,否则会影响内购结算
|
5.2 我踩过的坑与独家建议
先说我第一次帮客户升级时踩的坑。当时客户公司信息很全,营业执照、产品、邮箱都齐了,但邓白氏编码填完提交后,苹果给拒了,原因是地址不匹配。
第二个坑是电话验证回答的细节。有一次验证,对方问我“公司主营业务是什么”,我这边接电话的人说“我们做互联网”,对方继续问“具体是哪类互联网服务”,接电话的人卡壳了。我不在现场,但电话那头明显停顿了几秒。最后还是我事后给苹果发了邮件补充了业务说明,才算平稳过关。
正确做法是在电话验证前,把公司主营业务的描述准备成一句话:比如“我们是一家专注于移动支付解决方案的软件开发公司”。点到为止,不要自我发挥,更不要扯“我们什么都做”。审核员怕的是信息不精确,不是低调。
第三个建议是,升级过程中不要同时在开发者后台做太频繁的账号改动。有些人一边升级,一边改邮箱、改安全设置、改手机号,这会导致苹果触发电邮验证和安全暂停。升级期间只改必要项,其他改动等主体切换完再操作。
再有,就是耐心的问题。整个流程顺利的话,算上邓白氏的等待时间,总体周期大概两到三周。如果算上电话打不通、资料补交、节假日,拖到一个月也不用慌。苹果审核不是挑刺,但流程节点确实多,给自己留足时间余量,别卡着上传App的节点才想起来升级。
5.3 邓白氏编码迟迟不下发怎么办
邓白氏编码是个人升级公司这条链路里最大的变量,这里单独讲一下异常处理的预案。
如果你的申请提交后超过10个工作日还没动静,先不要重复提交,因为重复提交会产生多条记录,反而让审核员更加迷惑。正确的操作顺序是:先查D&B产品的查询入口,输入营业执照上的公司全称,看看是否能查到记录。
不要只说“我很久以前申请了编码但没结果”,人工客服需要明确的关键词是:申请编号、公司全称、提交日期。
还有一个边境方案,就是直接跳过中文客服,给D&B美国总部发英文邮件,标题写“Request for D-U-N-S Number for Apple Developer Account”,正文写清楚公司全称和统一社会信用代码。我见过不少案例,美国总部介入后几个工作日就处理完了,效率反而比本地客服高。这个不是常规推荐路径,但确实能解决部分疑难问题。
6. 升级完成后的收尾工作
主体切换成功后,开发者的工作才算真正完成一大半,因为还有几项收尾工作不能漏。
第一件事是前往“协议、税务和银行业务”页面,更新税务信息和银行账户。个人账号的结算账户通常是个人银行卡,升级成公司后需要换成公司的对公账户,并补充公司税号。如果不更新,后期苹果的内购收入会被扣或多发,发到你个人卡上还会牵扯到做账问题。
第二件事是重新署名开发者名称。把个人名称换成公司名称后,如果App本身需要调整版本说明或者更新隐私政策,可以顺带把App Store的各种联系邮箱、隐私政策链接全部换成公司域名下的渠道,保持信息一致。
第三件事是如果后续还要做微信开放平台、支付宝开放平台、抖音开放平台等第三方服务的企业认证,此时凭公司在App Store上的公司开发者名称、公司营业执照就能顺利提交,很多平台对企业开发者的资质认可度比个人高很多,审核速度也快很多。
第四件事是团队权限。注册完公司账号后,App Store Connect里面可以添加团队成员,分配不同的角色。把财务、运营、技术分到不同角色下面,以后就算有人离职,也能精确回收权限,不会影响App的整体控制权。
这几步搞定,个人升公司这件事就算真正画上句号了。
根据我个人经验,整个升级过程最难熬的其实不是操作,而是等待期的焦虑。等邓白氏、等苹果回邮件、等电话响,每一环都像是黑洞。但只要你知道整个流程长什么样、需要什么材料、电话会问什么,这个事就变成了一个确定性很强的等待,而不是心里没底的拖沓。如果你正在准备升级,就把这篇文章里的清单打印出来按步走。顺利的话,你会在两到三周内看到自己App详情页上的开发者名称变成公司名,到那一步,你会发现前期这一通折腾都是值得的。
经常有人问我:“我做App已经两三年了,账号一直是用个人名义注册的苹果开发者账号,现在想升级成公司开发者账号,该怎么操作?会不会很麻烦?”说实话,这个流程确实比重新注册一个公司账号要绕,但也没那么玄乎。关键在于两件事:一是邓白氏编码(D-U-N-S Number)能不能顺利拿到,二是苹果的电话审核能不能一次通过。搞明白这两点,整个升级流程基本就能顺畅走完。
这篇文章就是一份完整的苹果开发者账号从个人(Individual)升级为公司(Organization)的操作指南。我会把升级前的资质准备、邓白氏编码申请、苹果后台的具体点击路径、电话验证应答要点,以及整个流程里最容易踩的坑全部拆开讲清楚。无论你是因为上架App需要显示公司名称,还是因为要接入微信支付、Apple Pay这类需要公司主体才能开通的服务,这篇文章都适用。
1. 为什么要把个人开发者账号升级成公司开发者账号
1.1 个人、公司、企业三种账号到底差在哪
苹果开发者账号分三类,很多人分不清个人账号(Individual)和公司账号(Organization)的区别,更有人把公司账号和企业账号(Enterprise)搞混,这里先花点时间把底层的逻辑理清楚。
个人开发者账号(Individual)年费是99美元,注册时只需要提供个人身份信息,App Store里显示的开发者名称是你的个人姓名。这个账号适合个人开发者、独立开发者,或者还在试水阶段的小项目。所有涉及到真实企业资质的服务基本都开不了,比如微信开放平台、支付宝开放平台里不少接口要求App的开发者主体必须是企业,遇到这类审核你只能干瞪眼。
公司开发者账号(Organization)年费同样是99美元,但需要提供公司营业执照、邓白氏编码等企业资质。App Store里显示的开发者名称是公司的英文名称。绝大多数需要企业主体才能申请的服务,比如Apple Pay、Sign in with Apple、微信支付、苹果的某些特殊能力,都必须基于公司账号才能开通。
企业开发者账号(Enterprise)年费是299美元,只用于企业内部App分发,不上App Store,审核严格,必须有苹果的企业资质审批。这个不是普通人玩的路径,大多数人也不需要。
简单总结就是:个人账号是入门版,公司账号是正式版,企业账号是内部分发专用。标题说的“个人开发者账号升级成公司开发者账号”,走的就是从入门版到正式版的升级路径。
1.2 升级之后到底多了什么
从开发者后台功能上看,个人和公司账号的会员权限其实基本一致,能上传App、能管理TestFlight、能看崩溃日志,这些没有本质区别。那升级的意义在哪?我用实际场景说。
最大的变化是主体变化。个人版开发者名称是你的姓名,公司版开发者名称是公司名。用户在App Store详情页看到开发者名称,个人姓名和公司名的信任感完全不在一个量级。尤其做金融、医疗、工具类App,一个带公司名的壳很重要。
第二个变化是财务和税务信息的录入维度不同。公司账号可以填写公司的银行账户、税务信息、发票抬头,个人账号只能走个人结算渠道。如果你的App涉及内购分成收入,或者需要合规性报税,公司主体的重要性是实打实的。
第三个变化是权限管理和团队协作。公司账号下可以邀请团队成员加入App Store Connect,设置不同的职能角色(管理员、财务、开发者、营销等),个人账号虽然也能邀请成员,但财务、税务、签名等敏感操作的主体还是你个人。一旦拉到公司层面,账号归属和管理边界必须清晰,这就是升级的必要性所在。
你原本的个人账号下的App、应用ID、证书、推送密钥、TestFlight记录,升级成功后都会原样保留,App不会被下架,用户也不用重装。这一点苹果处理得算厚道。
2. 升级前要准备的材料与资质
2.1 必备材料清单
升级这个动作可不是直接改个名就行,你需要提前把以下几样东西准备好,缺一样流程都会卡住。
公司营业执照(必须)。必须是有效的、处于存续状态的公司营业执照,个体户执照在不少地区也能走通,但苹果审核时会更严格,建议如果是个人独资企业或个体工商户,先咨询一下苹果客服再操作。
邓白氏编码(必须)。这是整条链路里最麻烦、最容易出问题的一环。邓白氏编码是 Dun & Bradstreet 公司为企业分配的唯一全球企业标识,类似企业的身份证号。苹果通过这个编码来核对你的公司主体是否真实存在、地址和电话是否对得上。这个编码不是苹果颁发的,需要向邓白氏官方申请,正常周期是3到10个工作日,赶上节假日可能拖到两周以上。
企业邮箱(强烈建议)。升级后的公司账号建议使用以公司域名结尾的企业邮箱作为主要联系方式,比如 。如果你用QQ邮箱或163邮箱,虽然也能过,但苹果后台的邮件往来和后续安全验证都会显得很业余,部分国家的审核员也会对个人邮箱发来的公司变更申请多打几个问号。
公司产品(建议有)。产品不是硬性要求,但苹果审核时经常通过你提交的公司域名来验证业务真实性。如果没有产品,用公司介绍页、公众号、小程序页面也能凑合,但产品是成本最低的信任凭证。
工作日可接听的审核联系电话(必须)。注意,这一步是整个流程中最容易翻车的地方。苹果在审核公司主体时,会打电话给你在后台填写的电话,通过电话来核实公司名称、地址、邓白氏编码等关键信息。这个电话是工作日打来的,一定要保证电话能接通,且接电话的人知道有这回事。
2.2 邓白氏编码的查询与申请渠道
很多人在申请邓白氏编码时,第一反应是去中国区D&B产品填表,结果填了半天没有下文。我先说结论:D&B产品有自己的申请入口,苹果也给你提供了一个间接申请通道,后者往往更快,因为苹果合作的审批链路是独立的。
另一个常见场景是:你在后台提交升级申请时,苹果会让你填邓白氏编码,但如果你还没有,系统会提供“Request D-U-N-S Number”的选项,相当于苹果会帮你把申请请求转到邓白氏那边。这个方式的好处是,你的申请会带标签(Apple Store Connect关联),审核优先级通常比自行在D&B产品递交要高。
我自己实测下来的建议是:升级流程的第一步先别去苹果后台,直接在D&B产品提交申请,拿到九位数的邓白氏编码后再去苹果后台填。别问我为什么,问就是苹果转发的申请有“沙箱”概率,你需要耐心等更新周期,不如自己主动把编码先拿到手。
3. 邓白氏编码申请实操流程
3.1 提交申请前的信息核对
邓白氏编码申请过程中最耗时的不是审核,而是反复修改信息。最常见的问题就是公司名称、地址、电话和注册地不一致,导致系统匹配失败。所以,在你打开申请页面之前,先花15分钟把下面几项信息统一到完全一致。
企业名称要用营业执照上的法定名称,中英文都要有。英文名建议用营业执照拼音直译或公司注册的正式英文名,比如“上海某某网络科技有限公司”对应“Shanghai Some Network Technology Co., Ltd.”。这个英文名之后会显示在App Store详情页,尽量核对好。
公司地址尽量精确到门牌和楼层,并且与营业执照上的地址一致。如果你在实际运营地址办公,可不可以填运营地址?
申请时预留的联系邮箱建议使用企业邮箱,电话填写能正常接听的座机或手机号码。如果预留手机号,也不要关闭防骚扰拦截,D&B经常从某一个较冷门的号码打过来,一旦被拦截就半天没有动静了。
3.2 申请环节的操作细节
表单里会要求填写公司中英文名、营业执照号码、统一社会信用代码、公司地址、联系方式、申请人信息等。填写时需要注意:
公司名称务必与营业执照完全一致,包括括号及括号中间的内容。中文名和英文名都不要省略任何词。
统一社会信用代码是18位,别填错,这是D&B核对工商信息的核心依据。
联系电话建议同时填写座机和手机。座机号最好是对外公布的,因为D&B会按公开数据库信息来核对。
提交完成后,D&B会让你选择行业分类,一般选“软件开发”或“互联网服务”即可。完成后会给你一个申请编号,建议截图保存,后期查询进度会用到。
这里要强调一下:D&B的中文产品上有个“快速查询”功能和“申请编码”功能,很多人会混淆。查询功能是看你的公司是否已有编码,如果不确定公司之前是否申请过邓白氏编码,先用查询入口查一下,不要盲目重复申请。重复申请会导致多条邓白氏记录,反而拖慢审核。
3.3 邓白氏审核周期与加速技巧
D&B审核周期通常在3到10个工作日之间,但实际会被各种因素拉长。我在操作过程中总结了几条缩短完成时间的经验:
第一,提交时把公司的产品地址写清楚。D&B审核人员会根据产品中展示的公司地址、联系方式来人工比对,如果你的产品信息与申请信息完全一致,审核基本是一次过,周期往往能压在5个工作日内。
第二,提交后第2个工作日主动联系中文客服或英文客服索要申请进度。D&B是有客服电话和邮件工单通道的,你主动询问的同时,对方也会查看你的待处理工单,把卡住的问题暴露出来。我试过两次,每次催完都能在隔天收到回复。
第三,如果7个工作日后还没有结果,直接给D&B的全球客服发邮件,写清楚公司全称、申请编号、提交时间,并说明是申请Apple Developer账号需要。带上“Apple”关键词通常会提高处理优先级,这不是玄学,是这条申请链路是D&B专门为苹果生态服务的一部分,有单独的标注。
一旦拿到邓白氏编码,建议先记录下来,再回到D&B产品的查询页面,把编码对应的公司名称、地址、电话截图留存,因为后面的苹果审核会用到这些信息,且号码必须与后台填写的信息一模一样。
4. 苹果开发者后台升级操作全流程
4.1 登录后台发起升级
邓白氏编码到手后,进入App Store Connect后台,当前账号是个人开发者类型,页面上会显示“Individual”标识。
登录后点击“用户和访问”,在顶部菜单栏的“协议、税务和银行业务”区域,或者在账号设置的首页,应该能看到一个按钮“升级为组织”或“Enroll as Organization”。这个入口偶尔会因为苹果改版而移位,但核心逻辑没变:个人账号会常驻一个切换主体类型的入口。
点击升级入口后,系统会重新引导你走一遍公司注册页面,让你选择“Organization”,然后填写公司名称、邓白氏编码、公司地址和产品等信息。这里填写的公司名称和你邓白氏编码对应的名称必须完全一致,大小写无所谓,但顺序和用词不能改。
这里有个容易错的点:苹果后台的“公司名称”填的是营业执照上的中文名还是英文名?答案是英文名。苹果开发者后台全英文操作,填英文公司名才是后面App Store详情页显示的法人名,营业执照中文名并不会直接出现在前台页面。如果你公司有对外正式英文名,就直接用;如果没有,用中文名拼音直译即可。
4.2 提交公司信息与法律实体资料
在这个阶段,苹果会让你确认法律实体类型,一般选“Corporation”,少数选“Partnership”或“Sole Proprietorship”,对应的就是有限公司、合伙企业和个体户。
其中有一点要特别注意:苹果审核人员有时会要求你提供营业执照扫描件、法人身份证扫描件、地址证明文件(如水电费账单),甚至在极少数情况下会要求提供公司公章盖章文件。这些文件的格式要求是PDF或JPG,大小能控制在5MB以内即可。虽然升级流程在正常情况下不强制上传营业执照,但提前备好扫描件,能省去后续补材料的来回邮件时间。
再往后是填“SIC Code”(标准行业分类码)。这个码不一定每个地区都会要求填,但有时候会出现在表单里。软件开发对应的常用码是7371(Computer Programming Services),互联网相关服务可以用7372,如果你做的是硬件,就查一下对应码填上。
4.3 电话验证环节怎么应对
提交公司信息后,苹果不会马上通过,而是进入人工审核阶段。这个阶段的核心动作是电话验证。
苹果的电话验证通常有两种触发方式:一种是苹果审核团队直接打给你在后台留的审核联系电话,另一种是审核团队发邮件要求你预约某个时间拨打审核电话。无论哪种,电话那头问的消息基本都是固定套路:公司全名、公司地址、邓白氏编码、是否在App Store Connect提交升级申请、公司主营业务、是否使用第三方仓库等。
应对技巧就三条:第一,接电话的人对上述信息必须烂熟于心,建议把公司名称、地址、邓白氏编码、注册资本这些信息打印在桌上;第二,如果接电话的人不是法人,而是技术人员,也务必把你公司的主营业务说清楚,别回答“我不太清楚,我是做技术的”——我见过有人就是这么被延后的;第三,保持耐心,语气平静,回答简洁,不过度展开。
电话验证通过后,苹果后台会显示“正在处理”,同时你会收到一封邮件,说明审核团队已收到申请,正在核实公司信息。接下来就是等。
4.4 缴费与等待审核
升级公司账号不会再从你的账户里额外扣一次99美元年费,因为你的个人账号本身已经在生效周期内,苹果会直接把剩余周期迁到公司账号上。如果你是续费日临近的时段操作,升级成功后系统会按公司主体的身份到续费日重新计费,个人版的费用不会退回。这点要提前想好:尽量在个人版刚续费完毕后马上升级,这样你花一份年费,公司账号能用满一年;如果马上要续费了,先续费再升级更划算。
提交后一般3天内会收到结果通知,快的当天就能通过,慢的可能拖两周,极端情况需要四到六周,主要卡在邓白氏匹配不成功、电话打不通或公司信息与工商信息不符这三类情况。
审核通过后,你在App Store Connect首页看到的主体类型会从“Individual”变成“Organization”,App Store详情页的开发者名称也会逐渐同步成公司英文名。这个同步有延迟,通常需要两到三天,别刚升级完发现没变化就着急重新提交。
5. 常见问题与排查技巧实录
5.1 高频问题速查表
我把这几年操作中读者和客户最常问到的问题整理成了一张表,你可以直接按图索骥。
| 问题 | 原因 |
|---|
解决方案
| | 升级提交后五六天没消息 | 人工审核排队,或后台信息待补充 |
|---|
登录后台检查有没有邮件通知,主动发邮件到 App Store Connect 技术支持询问处理进度
| | 电话验证总打不通 | 预留电话被拦截、关机或无人接听 |
|---|
工作日保持电话畅通,关闭陌生号码拦截,重新进后台修改联系电话并追加邮箱说明
| | 邓白氏编码已在别处用过 | 同一公司有多个邓白氏编码记录 |
|---|
|
| 公司名称在App Store显示成个人名 | 升级未完成,或后台主体仍为Individual |
|---|
确认升级通过后等待两到三天,详情页名称会按公司主体刷新
| | 升级期间还能提交审核吗 | 不影响,苹果冻结的是主体变更而非App审核 |
|---|
可以在后台正常上传App、提交审核,保持操作正常即可
| | 要不要先取消个人版再注册公司版 | 不建议 |
|---|
直接升级最快,取消再注册会丢失原有App、证书和下载记录
| | 老App的Bundle ID会受影响吗 | 不受影响 |
|---|
App ID、Bundle ID、推送证书、Keys全部保留
| | 税务和银行信息要重新填吗 | 需要 |
|---|
升级成功后重新进入“协议、税务和银行业务”填写公司银行账号与税务信息,否则会影响内购结算
|
5.2 我踩过的坑与独家建议
先说我第一次帮客户升级时踩的坑。当时客户公司信息很全,营业执照、产品、邮箱都齐了,但邓白氏编码填完提交后,苹果给拒了,原因是地址不匹配。
第二个坑是电话验证回答的细节。有一次验证,对方问我“公司主营业务是什么”,我这边接电话的人说“我们做互联网”,对方继续问“具体是哪类互联网服务”,接电话的人卡壳了。我不在现场,但电话那头明显停顿了几秒。最后还是我事后给苹果发了邮件补充了业务说明,才算平稳过关。
正确做法是在电话验证前,把公司主营业务的描述准备成一句话:比如“我们是一家专注于移动支付解决方案的软件开发公司”。点到为止,不要自我发挥,更不要扯“我们什么都做”。审核员怕的是信息不精确,不是低调。
第三个建议是,升级过程中不要同时在开发者后台做太频繁的账号改动。有些人一边升级,一边改邮箱、改安全设置、改手机号,这会导致苹果触发电邮验证和安全暂停。升级期间只改必要项,其他改动等主体切换完再操作。
再有,就是耐心的问题。整个流程顺利的话,算上邓白氏的等待时间,总体周期大概两到三周。如果算上电话打不通、资料补交、节假日,拖到一个月也不用慌。苹果审核不是挑刺,但流程节点确实多,给自己留足时间余量,别卡着上传App的节点才想起来升级。
5.3 邓白氏编码迟迟不下发怎么办
邓白氏编码是个人升级公司这条链路里最大的变量,这里单独讲一下异常处理的预案。
如果你的申请提交后超过10个工作日还没动静,先不要重复提交,因为重复提交会产生多条记录,反而让审核员更加迷惑。正确的操作顺序是:先查D&B产品的查询入口,输入营业执照上的公司全称,看看是否能查到记录。
不要只说“我很久以前申请了编码但没结果”,人工客服需要明确的关键词是:申请编号、公司全称、提交日期。
还有一个边境方案,就是直接跳过中文客服,给D&B美国总部发英文邮件,标题写“Request for D-U-N-S Number for Apple Developer Account”,正文写清楚公司全称和统一社会信用代码。我见过不少案例,美国总部介入后几个工作日就处理完了,效率反而比本地客服高。这个不是常规推荐路径,但确实能解决部分疑难问题。
6. 升级完成后的收尾工作
主体切换成功后,开发者的工作才算真正完成一大半,因为还有几项收尾工作不能漏。
第一件事是前往“协议、税务和银行业务”页面,更新税务信息和银行账户。个人账号的结算账户通常是个人银行卡,升级成公司后需要换成公司的对公账户,并补充公司税号。如果不更新,后期苹果的内购收入会被扣或多发,发到你个人卡上还会牵扯到做账问题。
第二件事是重新署名开发者名称。把个人名称换成公司名称后,如果App本身需要调整版本说明或者更新隐私政策,可以顺带把App Store的各种联系邮箱、隐私政策链接全部换成公司域名下的渠道,保持信息一致。
第三件事是如果后续还要做微信开放平台、支付宝开放平台、抖音开放平台等第三方服务的企业认证,此时凭公司在App Store上的公司开发者名称、公司营业执照就能顺利提交,很多平台对企业开发者的资质认可度比个人高很多,审核速度也快很多。
第四件事是团队权限。注册完公司账号后,App Store Connect里面可以添加团队成员,分配不同的角色。把财务、运营、技术分到不同角色下面,以后就算有人离职,也能精确回收权限,不会影响App的整体控制权。
这几步搞定,个人升公司这件事就算真正画上句号了。
根据我个人经验,整个升级过程最难熬的其实不是操作,而是等待期的焦虑。等邓白氏、等苹果回邮件、等电话响,每一环都像是黑洞。但只要你知道整个流程长什么样、需要什么材料、电话会问什么,这个事就变成了一个确定性很强的等待,而不是心里没底的拖沓。如果你正在准备升级,就把这篇文章里的清单打印出来按步走。顺利的话,你会在两到三周内看到自己App详情页上的开发者名称变成公司名,到那一步,你会发现前期这一通折腾都是值得的。
收起阅读 »
举报涉嫌冒充 HBuilderX 官方下载渠道 分发捆绑恶意远控的安装包
涉事网址:https://hbuilderx.app/cn/index.html
这个网站在搜索排名极度靠前 比官网还靠前
.10 月 10 日本人从上述页面下载 hbuilderx-win.zip。本机 Chrome 下载记录显示,下载链经过 1.startss-downloading.icu,最终文件地址为:
https://pub-6a90252f6d70443d960d6ac029dbd446.r2.dev/hbuilderx-win.zip
解压运行该安装包后,系统于当日 安装了 ScreenConnect 远程控制服务,服务名为 14.38.33135.0,程序隐藏在 C:\Program Files (x86)\Microsoft Visual C++ 2022\ScreenConnect.ClientService.exe,连接地址为 442.open-fast-ports.com:8041,启动参数带有 c=hbuilderx 标记。安装过程中也安装了正常的 HBuilderX,使捆绑远控不易被察觉。
.2026 年 10 月 14 日 09:07:29,该远控的事件日志记录执行远程命令;9 秒后,系统中出现恶意加载器 C:\ProgramData\Microsoft\Windows\Caches\4259B89A\RuntimeHost.exe。随后出现后台挖矿、恶意启动项、杀毒排除项,以及窃取浏览器 Cookie 和 Cursor 登录令牌的记录。显卡曾持续接近 100% 负载,温度达到约 82~83℃。
已保留的木马原始日志包含以下文字:
2026-10-14 09:09:55 | CursorHarvester: STEAL_CURSOR: 6 token(s) uploaded.
2026-10-14 09:14:26 | CookieHarvester [immediate]: 113 cookies uploaded=True
2026-10-14 09:44:01 | CookieHarvester [chrome (delayed)]: 3767 cookies uploaded=True
本人已保留浏览器下载来源记录、服务安装及远控执行事件日志、恶意程序日志和文件哈希。请求核查该网站及关联下载地址,阻断恶意安装包传播
涉事网址:https://hbuilderx.app/cn/index.html
这个网站在搜索排名极度靠前 比官网还靠前
.10 月 10 日本人从上述页面下载 hbuilderx-win.zip。本机 Chrome 下载记录显示,下载链经过 1.startss-downloading.icu,最终文件地址为:
https://pub-6a90252f6d70443d960d6ac029dbd446.r2.dev/hbuilderx-win.zip
解压运行该安装包后,系统于当日 安装了 ScreenConnect 远程控制服务,服务名为 14.38.33135.0,程序隐藏在 C:\Program Files (x86)\Microsoft Visual C++ 2022\ScreenConnect.ClientService.exe,连接地址为 442.open-fast-ports.com:8041,启动参数带有 c=hbuilderx 标记。安装过程中也安装了正常的 HBuilderX,使捆绑远控不易被察觉。
.2026 年 10 月 14 日 09:07:29,该远控的事件日志记录执行远程命令;9 秒后,系统中出现恶意加载器 C:\ProgramData\Microsoft\Windows\Caches\4259B89A\RuntimeHost.exe。随后出现后台挖矿、恶意启动项、杀毒排除项,以及窃取浏览器 Cookie 和 Cursor 登录令牌的记录。显卡曾持续接近 100% 负载,温度达到约 82~83℃。
已保留的木马原始日志包含以下文字:
2026-10-14 09:09:55 | CursorHarvester: STEAL_CURSOR: 6 token(s) uploaded.
2026-10-14 09:14:26 | CookieHarvester [immediate]: 113 cookies uploaded=True
2026-10-14 09:44:01 | CookieHarvester [chrome (delayed)]: 3767 cookies uploaded=True
本人已保留浏览器下载来源记录、服务安装及远控执行事件日志、恶意程序日志和文件哈希。请求核查该网站及关联下载地址,阻断恶意安装包传播
收起阅读 »
自动化测试,可能与不可用
HBuilderX 官方自动化测试 CLI 连接与运行指南
文档定位
本文档总结 HBuilderX 官方自动化测试 CLI 在 Web 测试中的完整连接链路,重点说明以下问题:
- CLI 在什么条件下可以连接正在运行的 HBuilderX;
- HBuilderX 官方测试在什么条件下可以连接项目运行时;
- 已运行的 Web 服务在什么条件下可以被复用;
- 什么情况属于 CLI 连接失败、运行时连接失败、编译失败、测试失败或环境阻塞;
- 如何用日志和官方 JSON 报告判断测试结果是否有效。
本文不依赖某个具体业务项目,不包含项目名称、业务页面、项目目录和本机用户信息。
结论摘要
官方 Web 自动化测试不是单一连接,而是连续的多阶段流程:
官方 CLI
  │
  ├── 连接 HBuilderX GUI 和官方 CLI 能力
  │
  ├── 打开或识别测试项目
  │
  ├── 启动或连接 Web 页面服务
  │
  ├── 连接页面对应的 Automator WebSocket 运行时
  │
  └── 执行测试并生成官方 JSON 报告
只有最后一阶段也得到有效报告,才能说明一次官方测试完整完成。
“CLI 能找到 HBuilderX”不等于“官方测试通过”;“页面能在浏览器中打开”也不等于“Automator 运行时可以连接”。
文档目录
01-连接链路与正式状态
说明 CLI、HBuilderX、Web 服务、Automator 和测试报告之间的关系,并定义“可正常执行”“失败”“阻塞”等正式状态。
02-验证环境与场景矩阵
记录本次实际验证环境,以及已经执行过的正向、负向和边界场景。
03-排查手册
提供从 CLI 连接到测试报告的逐步排查流程、日志关键词和常见误区。
04-验证记录模板
提供可以复制到其他机器或其他版本环境中的验证记录模板。
正式术语
本文尽量不使用“顺利”“不顺利”这类含义不明确的说法,统一使用以下术语:
| 术语 | 含义 |
|---|---|
| CLI 连接成功 | CLI 找到并成功调用目标 HBuilderX 的官方 CLI 能力 |
| 项目打开成功 | CLI 的项目打开操作返回成功,HBuilderX 能识别目标项目 |
| Web 服务启动成功 | 页面 HTTP 服务能够启动并返回页面资源 |
| Automator 连接成功 | 测试运行时与页面内置的 Automator WebSocket 完成连接 |
| 测试执行通过 | 测试套件和测试用例实际运行,并且指定断言通过 |
| 测试环境阻塞 | 因工具、服务、端口、设备或权限问题,测试没有有效执行 |
| 测试脚本无效 | 测试文件没有正确解析、没有有效断言,或证据不能证明目标行为 |
如何使用本文档
遇到问题时建议按以下顺序阅读:
- 先阅读 01-连接链路与正式状态,确定问题处在哪一层;
- 再对照 02-验证环境与场景矩阵,确认当前环境属于哪种场景;
- 按 03-排查手册 检查日志、端口和报告;
- 使用 04-验证记录模板 记录版本、配置、证据和边界。
适用范围
本文主要针对:
- HBuilderX 官方 Web 自动化测试;
uniapp.test web-chrome测试入口;- uni-app x Web 编译服务;
- Playwright Chromium 和 Automator WebSocket 运行时;
- CLI 连接 HBuilderX、连接项目和判断官方测试结果。
本文不替代以下内容:
- 业务页面测试用例设计;
- Android 真机键盘、焦点和生命周期验收;
- Tauri WebView、Rust 宿主和 SQLite 验收;
- 生产环境部署或发布构建说明。
版本边界
本次验证使用的环境和结论见 02-验证环境与场景矩阵。HBuilderX、uni-app x 编译器或官方测试插件升级后,应重新记录版本并复测关键正向、负向场景。
官方参考资料
01. 连接链路与正式状态
1. 完整连接链路
官方 Web 自动化测试应拆成三个阶段。三个阶段的通过标准不同,不能用前一个阶段的结果替代后一个阶段的结果。
阶段一:CLI → HBuilderX
阶段二:HBuilderX 官方测试 → Web/Automator 运行时
阶段三:测试套件 → 有效测试报告
阶段一:CLI 连接 HBuilderX
该阶段确认测试入口能够找到并调用 HBuilderX。
主要检查:
- HBuilderX GUI 是否正在运行;
- CLI 是否找到可用的
cli.exe; - CLI 和 GUI 是否来自同一套 HBuilderX 安装;
- CLI 是否能执行项目打开操作;
- HBuilderX 官方测试插件是否被正确加载;
- 官方测试命令是否真正开始运行。
阶段一通过,只能说明控制入口可用,不能说明页面运行时已经连接。
阶段二:官方测试连接 Web/Automator 运行时
该阶段确认浏览器页面和自动化运行时可以被测试执行器使用。
需要同时检查两条通道:
HTTP 通道:       CLI → h5.url → Web 页面
Automator 通道:  CLI → WebSocket → 页面运行时
HTTP 通道负责页面和资源访问。Automator 通道负责页面对象查询、点击、输入、路由和断言等自动化操作。
页面能打开而 Automator 不能连接时,仍然不能执行有效的官方自动化测试。
阶段三:测试套件执行并生成有效报告
该阶段确认测试文件确实被解析、执行并产生可信证据。
至少需要确认:
- 测试套件数量大于零;
- 测试用例数量大于零;
- 测试文件没有语法错误;
- 没有运行时连接异常;
- 断言结果符合预期;
- 官方 JSON 报告已经生成。
如果 CLI 找到了 HBuilderX,但测试套件没有执行,不能报告为完整通过。
2. 三种连接结果必须分开描述
2.1 CLI 连接 HBuilderX 成功
表示:
- HBuilderX GUI 已被检测到;
- CLI 找到了对应的官方 CLI 程序;
- 项目打开命令返回成功;
- 官方测试插件开始处理测试命令。
这只是控制层连接成功。
2.2 Automator 运行时连接成功
表示:
- 浏览器已经打开
h5.url指向的页面; - 页面编译结果包含 Automator 连接配置;
- CLI 使用的主机和端口能够访问页面运行时;
- 日志出现
connected或program ready。
这才说明页面具备被官方自动化操作的条件。
2.3 测试报告有效
表示:
- 测试文件已经被 Jest 正确解析;
- 至少一个测试套件和一个测试用例实际执行;
- 报告中的失败和运行异常数量符合预期;
- 通过结果与测试动作和断言一致。
这才可以报告一次完整的官方测试通过。
3. 正常使用条件
3.1 CLI 连接 HBuilderX 的条件
要使 CLI 能够连接 HBuilderX,通常需要满足:
- HBuilderX GUI 正在运行;
- 使用的 CLI 与当前 HBuilderX 属于同一版本体系或同一安装目录;
- CLI 能够找到官方 CLI 程序;
- 项目路径有效,并且包含可被 HBuilderX 识别的 uni-app x 工程文件;
- HBuilderX 的测试插件已经安装并且没有被禁用;
- CLI 项目打开操作没有超时或异常退出。
3.2 官方测试连接运行时的条件
要使页面运行时可被官方测试连接,通常需要满足:
- 页面 HTTP 服务已经启动;
h5.url指向正确的页面地址;- 页面编译时已经配置 Automator WebSocket;
- Automator 主机地址可以从测试进程访问;
- 页面使用的 Automator 端口与 CLI 使用的端口一致;
- 页面服务和 Automator 服务在测试期间保持运行。
3.3 测试结果有效的条件
要把结果报告为通过,还需要满足:
- 测试文件可以解析;
- 测试套件实际启动;
- 测试用例数量大于零;
- 测试动作确实通过官方自动化 API 执行;
- 官方 JSON 报告已经生成;
- 没有把环境阻塞或脚本无效误判为通过。
4. 不正常使用的典型情况
4.1 HBuilderX 没有运行
CLI 无法连接 GUI 控制入口。此时不应把问题归类为业务页面测试失败,应记录为环境阻塞。
4.2 CLI 找到的 HBuilderX 与当前 GUI 不一致
可能出现以下问题:
- CLI 使用了另一套 HBuilderX 的
cli.exe; - 编译器版本与测试插件版本不匹配;
- CLI 打开的项目和 GUI 当前项目不是同一个实例;
- 测试配置被不同版本的插件以不同方式修改。
排查时应记录 GUI 版本、CLI 路径、CLI 输出版本和编译器版本。
4.3 CLI 可以连接 HBuilderX,但项目打不开
这表示控制入口可用,但项目识别或项目路径存在问题。应单独记录项目打开失败,不要直接归类为 Automator 失败。
4.4 CLI 可以连接 HBuilderX,但 Automator 连接失败
这通常表示阶段一通过、阶段二失败。常见原因包括:
h5.url指向普通 HTTP 服务;- 页面没有注入 Automator 地址;
- 页面和 CLI 使用不同的 Automator 端口;
- Automator 主机地址不可达;
- 页面服务已经重启,CLI 仍连接旧端点。
4.5 Automator 已连接,但测试脚本没有有效执行
这通常是阶段三问题,常见原因包括:
- 测试文件语法错误;
- 测试范围没有包含目标文件;
- 测试文件没有有效用例;
- 断言或页面入口本身有问题;
- 报告生成失败。
5. Web 服务复用在完整链路中的位置
“复用已经运行的 Web 服务”只是阶段二的一种运行方式,不是 CLI 连接 HBuilderX 的全部定义。
5.1 CLI 自行编译
CLI 负责启动 Web 编译服务和 Automator 运行时。这种方式中,CLI 的服务生命周期最清晰,适合先验证工具链本身。
5.2 复用带 Automator 的已有服务
已有服务必须同时提供:
- 页面 HTTP 地址;
- 页面编译时注入的 Automator WebSocket 地址;
- CLI 可以访问的主机和端口。
5.3 复用普通 GUI Web 服务
普通 GUI Web 服务可以成功返回页面,但如果没有 Automator 端点,不能直接作为官方自动化测试服务复用。
6. 正式状态定义
建议统一使用以下状态,避免“可用”“不顺利”等表达产生歧义。
| 状态 | 正式含义 | 是否可以报告为通过 |
|---|---|---|
passed |
指定连接检查和测试用例均已实际执行并通过 | 可以,但仅限已覆盖范围 |
failed |
测试已经执行,但连接、代码或断言实际失败 | 不可以 |
blocked |
因 HBuilderX、服务、端口、权限或工具链问题,测试没有有效执行 | 不可以 |
incomplete |
测试能够运行,但覆盖范围或必要验证尚未完成 | 不可以作为完整通过 |
test-invalid |
测试脚本没有有效执行,或证据不能证明目标行为 | 不可以 |
7. 结论表达示例
正确表达
CLI 已成功连接 HBuilderX,项目打开操作返回成功;但 Automator 运行时未完成连接,因此本次 Web 自动化测试记录为
failed,不能报告为完整通过。页面 HTTP 服务访问正常,Automator WebSocket 端口与 CLI 配置一致,测试报告包含一个通过套件和一个通过用例,因此该复用场景在本次环境中验证通过。
HBuilderX GUI 未运行,CLI 测试入口未能建立,测试没有有效执行,因此记录为
blocked。
不建议表达
- “HBuilderX 可以用,所以测试可以用”;
- “页面能打开,所以自动化通过”;
- “CLI 启动了,所以测试已经完成”;
- “没有看到错误,所以应该通过”;
- “compile:false 就会自动复用开发服务”。
02. 验证环境与场景矩阵
1. 本次验证环境
本节记录实际验证环境,帮助读者判断版本差异。文档不记录具体业务项目名称、项目目录和用户信息。
1.1 工具链
- 操作系统:Windows 桌面环境;
- 命令行环境:PowerShell;
- HBuilderX 安装目录:
D:\App\HBuilderX;对外分享时可替换为<HBuilderX-root>; - HBuilderX 官方 CLI:
<HBuilderX-root>\cli.exe;本次验证对应D:\App\HBuilderX\cli.exe; - HBuilderX 内置 Node.js:由
<HBuilderX-root>\plugins\node\node.exe提供; - HBuilderX:
5.31.2026093020-alpha; - HBuilderX 官方自动化测试 CLI:命令行输出版本
5.4.0; - uni-app x 编译器:
5.31,VDOM 模式; - 测试平台:
web-chrome; - 浏览器驱动:Playwright Chromium;
- 浏览器模式:无头模式;
- 页面测试视口:官方运行时默认移动端视口。
1.2 HBuilderX 和 CLI 状态
本次运行入口要求 HBuilderX GUI 已经启动。测试脚本先检查 HBuilderX 进程,再解析与当前安装对应的 cli.exe。
CLI 执行项目打开操作后,再调用官方 Web 自动化测试命令。已实际观察到项目打开命令返回成功,说明控制入口阶段可以建立。
1.3 Web 服务状态
本次验证使用了两类服务:
普通 GUI Web 服务
- 页面地址示例:
http://127.0.0.1:5173/; - HTTP 请求可以得到成功响应;
- 进程参数为普通 uni-app x Web 启动方式;
- 未发现
--auto-port或--auto-host; /main响应中未发现可供测试运行时使用的 Automator 端点。
带 Automator 地址的独立 Web 服务
- 页面地址示例:
http://127.0.0.1:5174/; - Automator 主机:
127.0.0.1; - Automator 端口示例:
9538; - 服务启动时明确注入 Automator 地址;
- 用于验证“官方 CLI 复用带 Automator 端点的已有服务”。
1.4 环境边界
本次矩阵只验证 Web 自动化测试连接链路,不包含:
- Android 真机或模拟器自动化;
- Tauri WebView 和 Rust 宿主;
- 数据库读写和业务数据验收;
- 完整业务页面覆盖;
- 远程机器、局域网和跨主机防火墙验证。
2. 场景矩阵
下表覆盖了判断核心连接条件所需的关键正向和负向场景。它不是所有配置组合的穷举。
| 编号 | 场景 | 阶段一:CLI → HBuilderX | 阶段二:Web/Automator | 阶段三:测试报告 | 结果 |
|---|---|---|---|---|---|
| A | CLI 自行编译并启动 Web 服务 | 成功 | 成功 | 有效通过报告 | 可正常执行 |
| B | 复用带 Automator 的已有服务 | 成功 | 页面地址和端口匹配,连接成功 | 1 个冒烟用例通过 | 可以复用 |
| C | 复用普通 GUI Web 服务 | 成功 | 页面可访问,但 Automator 连接失败 | 运行时异常或无有效用例 | 不能复用 |
| D | 已有服务端口与 CLI 端口不一致 | 成功 | Failed to connect to runtime |
测试未有效开始 | 连接失败 |
| E | compile:false、无 h5.url、绑定地址无效 |
成功 | CLI 自行编译时 EADDRNOTAVAIL |
未生成有效报告 | 环境阻塞 |
| F | compile:false、无 h5.url、本机地址有效 |
成功 | CLI 仍尝试自行编译,未复用 GUI 服务 | 超时或无有效报告 | 环境阻塞 |
| G | 检查 GUI 服务是否自带 Automator | 成功 | 当前 GUI 服务未发现端点 | 不适用 | 普通 Web 服务 |
3. 各场景说明
3.1 场景 A:CLI 自行编译并启动
该场景中,官方 CLI 自己启动编译器和 Automator 运行时。
验证重点:
- 主机地址可以被当前机器绑定;
- 编译服务可以启动;
- CLI 能够打开页面;
- Automator 运行时能够连接;
- 测试报告中存在实际执行的测试用例。
该场景可以证明官方 CLI 自己管理整条链路时能够工作,但不能证明普通 GUI 服务可以被复用。
3.2 场景 B:复用带 Automator 的已有服务
该场景中,先启动页面服务,并在编译时注入 Automator 地址,再让官方 CLI 使用相同的页面地址和 Automator 端口。
成功条件:
页面地址:       http://127.0.0.1:5174/
页面 Automator: 127.0.0.1:9538
CLI Automator:   127.0.0.1:9538
本次验证中,运行日志出现了 Automator 连接和 program ready,并且冒烟用例通过。这证明“已有服务复用”本身是可行的,但前提是服务已经具备 Automator 能力。
3.3 场景 C:复用普通 GUI Web 服务
该场景中,页面地址可以访问,但服务只提供普通 HTTP/Vite 能力,没有对应 Automator 端点。
实际表现:
- 浏览器上下文可以创建;
- 页面 URL 可以被访问;
- 运行时连接阶段失败;
- 出现
Failed to connect to runtime; - 测试套件可能没有真正执行。
这说明页面服务可访问和官方自动化可用是两个独立条件。
3.4 场景 D:端口不一致
已有页面服务在编译时使用 Automator 端口 9538,而 CLI 运行时使用动态分配的 9539。
两个进程可能都处于运行状态,但它们不会自动建立同一个 Automator 会话,最终表现为运行时连接失败。
3.5 场景 E:无效绑定地址
在 compile:false 且没有 h5.url 的配置下,CLI 仍尝试启动自己的编译服务。如果 Automator 主机被设置为当前机器不存在的地址,编译器会在监听阶段报:
EADDRNOTAVAIL: address not available这属于服务启动失败,不属于测试用例断言失败。
3.6 场景 F:compile:false 但没有 h5.url
将绑定地址改为 127.0.0.1 后,CLI 仍尝试启动自己的编译服务。由于 GUI 已占用默认页面端口,CLI 改用其他页面端口,但没有自动复用 GUI 服务,最终测试没有有效完成。
该结果说明:
compile:false不是“自动查找并复用已有 Web 服务”的充分条件。
3.7 场景 G:检查 GUI 服务是否自带 Automator
本次检查包括:
- 查看 Web 服务进程启动参数;
- 查看页面入口响应;
- 检查页面和日志中是否存在 Automator 地址;
- 检查对应 Automator 端口是否监听。
当前 GUI 服务是普通 Web 编译服务,没有发现官方自动化复用所需的 Automator 端点。
4. 环境与结论的边界
4.1 已确认的事实
- 当前版本的官方 CLI 可以连接正在运行的 HBuilderX;
- CLI 可以执行项目打开操作;
- CLI 可以自行编译并运行 Web 自动化测试;
- 带匹配 Automator 地址的已有服务可以被复用;
- 普通 HTTP/Vite 服务不能仅凭页面地址被复用;
- Automator 端口不一致会导致运行时连接失败;
compile:false不足以单独决定复用哪一个已有服务;- 无效主机地址会导致编译服务启动失败。
4.2 尚未穷举的组合
以下内容没有在本次矩阵中全部穷举:
- 其他 HBuilderX 版本的 CLI 与 GUI 组合;
- 不同操作系统下的网络绑定行为;
- 局域网地址和远程测试机之间的连接;
- GUI 中可能新增的 Automator 服务启动选项;
- 所有
compile、h5.url、主机、端口排列组合; - 完整业务页面和多页面测试。
因此,本文应使用“在本次验证环境中确认”这样的表述,不应宣称已经验证了所有版本和所有配置。
5. 复现记录最少应包含的环境信息
- 操作系统和命令行环境;
- HBuilderX 版本;
- 官方 CLI 输出版本;
- uni-app x 编译器版本和渲染模式;
- 测试平台和浏览器驱动;
- HBuilderX GUI 是否正在运行;
- CLI 实际使用的路径;
- 项目打开结果;
- 页面 HTTP 地址和端口;
- Automator 主机和端口;
compile、h5.url和自定义环境变量;- 测试报告路径和套件/用例统计;
- 未覆盖的场景和环境限制。
03. 排查手册
1. 排查原则
排查时不要直接从业务断言开始。应按官方测试的实际连接顺序逐层确认:
HBuilderX GUI
  ↓
CLI 程序
  ↓
项目打开
  ↓
Web 页面服务
  ↓
Automator WebSocket
  ↓
测试套件
  ↓
官方 JSON 报告
前一层没有通过时,不要用后一层的现象解释问题。
2. 第一步:确认 HBuilderX GUI
需要确认:
- HBuilderX 窗口或进程确实正在运行;
- 没有停留在启动失败、更新未完成或插件加载失败状态;
- 当前 HBuilderX 是期望使用的版本;
- 目标项目已经被 HBuilderX 识别。
如果 HBuilderX 没有运行,CLI 通常不能依靠测试命令自行替代 GUI 控制入口。应记录为 blocked,不要报告为业务测试失败。
3. 第二步:确认 CLI 来源
记录 CLI 实际使用的完整路径和输出版本。
重点检查:
- CLI 是否来自当前 HBuilderX 安装目录;
- 是否存在多个 HBuilderX 安装;
- 环境变量是否把 CLI 指向了旧安装;
- CLI 调用的内置 Node、编译器和测试插件是否属于同一套安装。
如果 GUI 和 CLI 不是同一版本体系,首先应排除工具链混用问题。
4. 第三步:确认项目打开
CLI 项目打开操作成功,只能证明项目控制入口可用。
需要记录:
- 项目路径是否存在;
- 项目是否包含有效的 uni-app x 工程文件;
- CLI 项目打开命令的退出码;
- 是否出现“项目未打开”“项目不存在”或超时;
- HBuilderX 是否切换到目标项目。
项目打开失败时,不要继续修改页面测试断言。应先解决工程识别或 CLI 连接问题。
5. 第四步:确认测试配置
至少检查以下配置:
5.1 compile
确认是否让官方 CLI 自己编译,还是准备复用已有服务。
不要把以下两种含义混为一谈:
compile:false:不应简单解释为“自动连接任意已运行服务”;h5.url:只指定页面访问地址,不自动为页面添加 Automator 能力。
5.2 h5.url
如果要复用已有 Web 服务,应确认:
- 地址指向当前实际运行的页面服务;
- 协议、主机、端口和路径都正确;
- 该页面服务在测试期间不会被切换或重启。
5.3 Automator 主机和端口
确认页面编译时使用的 Automator 主机、页面实际连接的端口,以及 CLI 测试运行时使用的端口。
推荐把三者记录在同一张表中:
| 位置 | 主机 | 端口 |
|---|---|---|
| 页面编译配置 | 127.0.0.1 |
9538 |
| 页面实际运行时 | 127.0.0.1 |
9538 |
| CLI 测试运行时 | 127.0.0.1 |
9538 |
页面端口和 Automator 端口可以不同,但页面和 CLI 的 Automator 端点必须指向同一个运行时。
6. 第五步:确认 HTTP 页面服务
先验证页面 HTTP 地址,再验证 Automator。
PowerShell 示例:
Invoke-WebRequest -UseBasicParsing -Uri 'http://127.0.0.1:<web-port>/'页面请求失败时,检查:
- Web 服务是否已经启动;
- 页面端口是否被其他进程占用;
- 服务是否绑定到正确主机;
- 服务是否在测试过程中退出;
- CLI 日志是否显示了实际使用的 URL。
页面 HTTP 检查成功后,仍必须继续检查 Automator 端点。
7. 第六步:确认 Automator 运行时
重点查看官方测试日志中的以下信息:
automator:launcher
automator:runtime
connected
program ready
Failed to connect to runtime
7.1 出现 connected 或 program ready
说明 Automator 运行时已经建立连接,可以继续判断测试脚本和页面行为。
7.2 出现 Failed to connect to runtime
优先检查:
- 页面是否只是普通 HTTP 服务;
- 页面是否注入了 Automator 地址;
- 页面和 CLI 的 Automator 端口是否一致;
- Automator 主机是否可访问;
- 页面服务是否在测试前已经重启;
- CLI 是否连接到了旧端口或动态分配的新端口。
该错误通常不是业务用例断言失败。
7.3 出现 EADDRNOTAVAIL
说明服务尝试绑定当前机器无法使用的主机地址。应先检查主机配置和网络接口,不要先修改测试脚本。
7.4 页面端口被占用
如果日志显示 Web 服务自动换到其他页面端口,应确认:
h5.url是否仍然指向旧端口;- 页面编译结果中的 Automator 地址是否仍然有效;
- CLI 是否真的连接了新服务;
- 是否因此误把端口变化当成页面测试失败。
8. 第七步:确认测试套件真正执行
Automator 连接成功后,还要确认 Jest 测试本身有效。
重点检查:
- 测试文件是否被纳入
testMatch; - 测试文件是否可以被 Babel/Jest 解析;
- 测试套件数量是否大于零;
- 测试用例数量是否大于零;
- 测试是否在
beforeAll或页面启动阶段失败; - 页面断言是否真正执行。
如果日志显示:
Tests: 0 total则不能把这次运行报告为功能通过。
如果出现 JavaScript 语法错误,应记录为 test-invalid 或测试脚本失败,而不是 Automator 连接成功。
9. 第八步:确认官方 JSON 报告
官方 JSON 报告是判断测试是否有效的重要证据。至少检查:
- 报告文件是否生成;
numTotalTestSuites是否大于零;numTotalTests是否大于零;numRuntimeErrorTestSuites是否为零;numFailedTestSuites是否为零;numFailedTests是否为零;success字段与详细统计是否一致。
建议不要只看终端最后一行,也不要只看退出码。退出码、日志和 JSON 报告需要相互印证。
10. 错误现象与处理方向
| 错误现象 | 优先判断 | 不应直接判断为 |
|---|---|---|
| 未检测到 HBuilderX | GUI 或 CLI 环境阻塞 | 页面业务失败 |
| 项目打开失败 | 项目路径或 HBuilderX 识别问题 | Automator 断言失败 |
EADDRNOTAVAIL |
绑定主机地址无效 | 测试用例失败 |
Failed to connect to runtime |
Automator 地址、端口或注入缺失 | 页面 HTTP 不可访问 |
| 页面可打开但测试为 0 | 测试范围、脚本或运行时问题 | 功能通过 |
| JavaScript 语法错误 | 测试脚本无效 | Web 服务连接失败 |
| 生成报告但包含运行异常 | 测试没有完整通过 | 仅凭 success 字段通过 |
| 超时且没有有效报告 | 环境阻塞或进程未完成握手 | 业务断言失败 |
11. 常见误区
11.1 CLI 已启动,不代表 HBuilderX 已连接
CLI 进程启动只能说明命令被调用。还需要确认 HBuilderX 检测、项目打开和官方测试插件初始化结果。
11.2 HBuilderX 已连接,不代表页面运行时已连接
控制层和运行时是两个阶段。必须继续查看 Automator 日志。
11.3 页面可访问,不代表页面可自动化
普通 HTTP/Vite 服务可能没有 Automator WebSocket。
11.4 compile:false 不保证复用服务
没有 h5.url 或没有匹配的 Automator 端点时,CLI 可能自行启动编译服务,或者最终无法完成运行时连接。
11.5 动态端口不应未经确认直接使用
页面编译时注入的端口、CLI 运行时端口和页面实际连接端口必须一致。只看到 CLI 分配了端口,不代表页面已经同步使用该端口。
11.6 一个冒烟用例通过不等于完整验收通过
冒烟用例只能证明连接链路和该用例覆盖的行为。完整应用验收仍需独立的测试矩阵和必要的平台验证。
12. 推荐的最小排查命令
以下命令仅用于说明检查顺序,实际路径和端口应替换为当前环境值:
# 检查页面 HTTP 服务
Invoke-WebRequest -UseBasicParsing -Uri 'http://127.0.0.1:<web-port>/'

# 检查 Automator 端口
Test-NetConnection -ComputerName 127.0.0.1 -Port <automator-port>

# 使用 HBuilderX 官方 CLI 打开项目
<hbuilderx-cli> project open --path <project-root>

# 执行官方 Web 自动化测试
<hbuilderx-cli> uniapp.test web-chrome --project <project-root>
如果当前 PowerShell 或 HBuilderX 版本不支持某个检查命令,应记录替代命令和实际输出,不要把未执行的检查写成通过。
13. 清理和恢复
测试工具可能临时修改测试范围、环境配置或生成报告文件。测试结束后应确认:
- 仅保留用户明确需要的配置变化;
- 临时测试文件已经清理;
- 临时编译进程已经退出;
- HBuilderX 原有 Web 服务没有被误停;
- 失败证据、日志和 JSON 报告按需要保留;
- 配置文件差异经过审查。
14. 排查结论模板
可以使用以下格式记录一次结果:
HBuilderX GUI:已运行 / 未运行
CLI 连接:成功 / 失败
项目打开:成功 / 失败
页面 HTTP 服务:可访问 / 不可访问
Automator 运行时:已连接 / 未连接
测试套件:已执行 / 未执行
官方 JSON 报告:有效 / 缺失 / 内容不完整
最终状态:passed / failed / blocked / incomplete / test-invalid
根因:
证据:
未覆盖范围:HBuilderX 官方自动化测试 CLI 连接与运行指南
文档定位
本文档总结 HBuilderX 官方自动化测试 CLI 在 Web 测试中的完整连接链路,重点说明以下问题:
- CLI 在什么条件下可以连接正在运行的 HBuilderX;
- HBuilderX 官方测试在什么条件下可以连接项目运行时;
- 已运行的 Web 服务在什么条件下可以被复用;
- 什么情况属于 CLI 连接失败、运行时连接失败、编译失败、测试失败或环境阻塞;
- 如何用日志和官方 JSON 报告判断测试结果是否有效。
本文不依赖某个具体业务项目,不包含项目名称、业务页面、项目目录和本机用户信息。
结论摘要
官方 Web 自动化测试不是单一连接,而是连续的多阶段流程:
官方 CLI
  │
  ├── 连接 HBuilderX GUI 和官方 CLI 能力
  │
  ├── 打开或识别测试项目
  │
  ├── 启动或连接 Web 页面服务
  │
  ├── 连接页面对应的 Automator WebSocket 运行时
  │
  └── 执行测试并生成官方 JSON 报告
只有最后一阶段也得到有效报告,才能说明一次官方测试完整完成。
“CLI 能找到 HBuilderX”不等于“官方测试通过”;“页面能在浏览器中打开”也不等于“Automator 运行时可以连接”。
文档目录
01-连接链路与正式状态
说明 CLI、HBuilderX、Web 服务、Automator 和测试报告之间的关系,并定义“可正常执行”“失败”“阻塞”等正式状态。
02-验证环境与场景矩阵
记录本次实际验证环境,以及已经执行过的正向、负向和边界场景。
03-排查手册
提供从 CLI 连接到测试报告的逐步排查流程、日志关键词和常见误区。
04-验证记录模板
提供可以复制到其他机器或其他版本环境中的验证记录模板。
正式术语
本文尽量不使用“顺利”“不顺利”这类含义不明确的说法,统一使用以下术语:
| 术语 | 含义 |
|---|---|
| CLI 连接成功 | CLI 找到并成功调用目标 HBuilderX 的官方 CLI 能力 |
| 项目打开成功 | CLI 的项目打开操作返回成功,HBuilderX 能识别目标项目 |
| Web 服务启动成功 | 页面 HTTP 服务能够启动并返回页面资源 |
| Automator 连接成功 | 测试运行时与页面内置的 Automator WebSocket 完成连接 |
| 测试执行通过 | 测试套件和测试用例实际运行,并且指定断言通过 |
| 测试环境阻塞 | 因工具、服务、端口、设备或权限问题,测试没有有效执行 |
| 测试脚本无效 | 测试文件没有正确解析、没有有效断言,或证据不能证明目标行为 |
如何使用本文档
遇到问题时建议按以下顺序阅读:
- 先阅读 01-连接链路与正式状态,确定问题处在哪一层;
- 再对照 02-验证环境与场景矩阵,确认当前环境属于哪种场景;
- 按 03-排查手册 检查日志、端口和报告;
- 使用 04-验证记录模板 记录版本、配置、证据和边界。
适用范围
本文主要针对:
- HBuilderX 官方 Web 自动化测试;
uniapp.test web-chrome测试入口;- uni-app x Web 编译服务;
- Playwright Chromium 和 Automator WebSocket 运行时;
- CLI 连接 HBuilderX、连接项目和判断官方测试结果。
本文不替代以下内容:
- 业务页面测试用例设计;
- Android 真机键盘、焦点和生命周期验收;
- Tauri WebView、Rust 宿主和 SQLite 验收;
- 生产环境部署或发布构建说明。
版本边界
本次验证使用的环境和结论见 02-验证环境与场景矩阵。HBuilderX、uni-app x 编译器或官方测试插件升级后,应重新记录版本并复测关键正向、负向场景。
官方参考资料
01. 连接链路与正式状态
1. 完整连接链路
官方 Web 自动化测试应拆成三个阶段。三个阶段的通过标准不同,不能用前一个阶段的结果替代后一个阶段的结果。
阶段一:CLI → HBuilderX
阶段二:HBuilderX 官方测试 → Web/Automator 运行时
阶段三:测试套件 → 有效测试报告
阶段一:CLI 连接 HBuilderX
该阶段确认测试入口能够找到并调用 HBuilderX。
主要检查:
- HBuilderX GUI 是否正在运行;
- CLI 是否找到可用的
cli.exe; - CLI 和 GUI 是否来自同一套 HBuilderX 安装;
- CLI 是否能执行项目打开操作;
- HBuilderX 官方测试插件是否被正确加载;
- 官方测试命令是否真正开始运行。
阶段一通过,只能说明控制入口可用,不能说明页面运行时已经连接。
阶段二:官方测试连接 Web/Automator 运行时
该阶段确认浏览器页面和自动化运行时可以被测试执行器使用。
需要同时检查两条通道:
HTTP 通道:       CLI → h5.url → Web 页面
Automator 通道:  CLI → WebSocket → 页面运行时
HTTP 通道负责页面和资源访问。Automator 通道负责页面对象查询、点击、输入、路由和断言等自动化操作。
页面能打开而 Automator 不能连接时,仍然不能执行有效的官方自动化测试。
阶段三:测试套件执行并生成有效报告
该阶段确认测试文件确实被解析、执行并产生可信证据。
至少需要确认:
- 测试套件数量大于零;
- 测试用例数量大于零;
- 测试文件没有语法错误;
- 没有运行时连接异常;
- 断言结果符合预期;
- 官方 JSON 报告已经生成。
如果 CLI 找到了 HBuilderX,但测试套件没有执行,不能报告为完整通过。
2. 三种连接结果必须分开描述
2.1 CLI 连接 HBuilderX 成功
表示:
- HBuilderX GUI 已被检测到;
- CLI 找到了对应的官方 CLI 程序;
- 项目打开命令返回成功;
- 官方测试插件开始处理测试命令。
这只是控制层连接成功。
2.2 Automator 运行时连接成功
表示:
- 浏览器已经打开
h5.url指向的页面; - 页面编译结果包含 Automator 连接配置;
- CLI 使用的主机和端口能够访问页面运行时;
- 日志出现
connected或program ready。
这才说明页面具备被官方自动化操作的条件。
2.3 测试报告有效
表示:
- 测试文件已经被 Jest 正确解析;
- 至少一个测试套件和一个测试用例实际执行;
- 报告中的失败和运行异常数量符合预期;
- 通过结果与测试动作和断言一致。
这才可以报告一次完整的官方测试通过。
3. 正常使用条件
3.1 CLI 连接 HBuilderX 的条件
要使 CLI 能够连接 HBuilderX,通常需要满足:
- HBuilderX GUI 正在运行;
- 使用的 CLI 与当前 HBuilderX 属于同一版本体系或同一安装目录;
- CLI 能够找到官方 CLI 程序;
- 项目路径有效,并且包含可被 HBuilderX 识别的 uni-app x 工程文件;
- HBuilderX 的测试插件已经安装并且没有被禁用;
- CLI 项目打开操作没有超时或异常退出。
3.2 官方测试连接运行时的条件
要使页面运行时可被官方测试连接,通常需要满足:
- 页面 HTTP 服务已经启动;
h5.url指向正确的页面地址;- 页面编译时已经配置 Automator WebSocket;
- Automator 主机地址可以从测试进程访问;
- 页面使用的 Automator 端口与 CLI 使用的端口一致;
- 页面服务和 Automator 服务在测试期间保持运行。
3.3 测试结果有效的条件
要把结果报告为通过,还需要满足:
- 测试文件可以解析;
- 测试套件实际启动;
- 测试用例数量大于零;
- 测试动作确实通过官方自动化 API 执行;
- 官方 JSON 报告已经生成;
- 没有把环境阻塞或脚本无效误判为通过。
4. 不正常使用的典型情况
4.1 HBuilderX 没有运行
CLI 无法连接 GUI 控制入口。此时不应把问题归类为业务页面测试失败,应记录为环境阻塞。
4.2 CLI 找到的 HBuilderX 与当前 GUI 不一致
可能出现以下问题:
- CLI 使用了另一套 HBuilderX 的
cli.exe; - 编译器版本与测试插件版本不匹配;
- CLI 打开的项目和 GUI 当前项目不是同一个实例;
- 测试配置被不同版本的插件以不同方式修改。
排查时应记录 GUI 版本、CLI 路径、CLI 输出版本和编译器版本。
4.3 CLI 可以连接 HBuilderX,但项目打不开
这表示控制入口可用,但项目识别或项目路径存在问题。应单独记录项目打开失败,不要直接归类为 Automator 失败。
4.4 CLI 可以连接 HBuilderX,但 Automator 连接失败
这通常表示阶段一通过、阶段二失败。常见原因包括:
h5.url指向普通 HTTP 服务;- 页面没有注入 Automator 地址;
- 页面和 CLI 使用不同的 Automator 端口;
- Automator 主机地址不可达;
- 页面服务已经重启,CLI 仍连接旧端点。
4.5 Automator 已连接,但测试脚本没有有效执行
这通常是阶段三问题,常见原因包括:
- 测试文件语法错误;
- 测试范围没有包含目标文件;
- 测试文件没有有效用例;
- 断言或页面入口本身有问题;
- 报告生成失败。
5. Web 服务复用在完整链路中的位置
“复用已经运行的 Web 服务”只是阶段二的一种运行方式,不是 CLI 连接 HBuilderX 的全部定义。
5.1 CLI 自行编译
CLI 负责启动 Web 编译服务和 Automator 运行时。这种方式中,CLI 的服务生命周期最清晰,适合先验证工具链本身。
5.2 复用带 Automator 的已有服务
已有服务必须同时提供:
- 页面 HTTP 地址;
- 页面编译时注入的 Automator WebSocket 地址;
- CLI 可以访问的主机和端口。
5.3 复用普通 GUI Web 服务
普通 GUI Web 服务可以成功返回页面,但如果没有 Automator 端点,不能直接作为官方自动化测试服务复用。
6. 正式状态定义
建议统一使用以下状态,避免“可用”“不顺利”等表达产生歧义。
| 状态 | 正式含义 | 是否可以报告为通过 |
|---|---|---|
passed |
指定连接检查和测试用例均已实际执行并通过 | 可以,但仅限已覆盖范围 |
failed |
测试已经执行,但连接、代码或断言实际失败 | 不可以 |
blocked |
因 HBuilderX、服务、端口、权限或工具链问题,测试没有有效执行 | 不可以 |
incomplete |
测试能够运行,但覆盖范围或必要验证尚未完成 | 不可以作为完整通过 |
test-invalid |
测试脚本没有有效执行,或证据不能证明目标行为 | 不可以 |
7. 结论表达示例
正确表达
CLI 已成功连接 HBuilderX,项目打开操作返回成功;但 Automator 运行时未完成连接,因此本次 Web 自动化测试记录为
failed,不能报告为完整通过。页面 HTTP 服务访问正常,Automator WebSocket 端口与 CLI 配置一致,测试报告包含一个通过套件和一个通过用例,因此该复用场景在本次环境中验证通过。
HBuilderX GUI 未运行,CLI 测试入口未能建立,测试没有有效执行,因此记录为
blocked。
不建议表达
- “HBuilderX 可以用,所以测试可以用”;
- “页面能打开,所以自动化通过”;
- “CLI 启动了,所以测试已经完成”;
- “没有看到错误,所以应该通过”;
- “compile:false 就会自动复用开发服务”。
02. 验证环境与场景矩阵
1. 本次验证环境
本节记录实际验证环境,帮助读者判断版本差异。文档不记录具体业务项目名称、项目目录和用户信息。
1.1 工具链
- 操作系统:Windows 桌面环境;
- 命令行环境:PowerShell;
- HBuilderX 安装目录:
D:\App\HBuilderX;对外分享时可替换为<HBuilderX-root>; - HBuilderX 官方 CLI:
<HBuilderX-root>\cli.exe;本次验证对应D:\App\HBuilderX\cli.exe; - HBuilderX 内置 Node.js:由
<HBuilderX-root>\plugins\node\node.exe提供; - HBuilderX:
5.31.2026093020-alpha; - HBuilderX 官方自动化测试 CLI:命令行输出版本
5.4.0; - uni-app x 编译器:
5.31,VDOM 模式; - 测试平台:
web-chrome; - 浏览器驱动:Playwright Chromium;
- 浏览器模式:无头模式;
- 页面测试视口:官方运行时默认移动端视口。
1.2 HBuilderX 和 CLI 状态
本次运行入口要求 HBuilderX GUI 已经启动。测试脚本先检查 HBuilderX 进程,再解析与当前安装对应的 cli.exe。
CLI 执行项目打开操作后,再调用官方 Web 自动化测试命令。已实际观察到项目打开命令返回成功,说明控制入口阶段可以建立。
1.3 Web 服务状态
本次验证使用了两类服务:
普通 GUI Web 服务
- 页面地址示例:
http://127.0.0.1:5173/; - HTTP 请求可以得到成功响应;
- 进程参数为普通 uni-app x Web 启动方式;
- 未发现
--auto-port或--auto-host; /main响应中未发现可供测试运行时使用的 Automator 端点。
带 Automator 地址的独立 Web 服务
- 页面地址示例:
http://127.0.0.1:5174/; - Automator 主机:
127.0.0.1; - Automator 端口示例:
9538; - 服务启动时明确注入 Automator 地址;
- 用于验证“官方 CLI 复用带 Automator 端点的已有服务”。
1.4 环境边界
本次矩阵只验证 Web 自动化测试连接链路,不包含:
- Android 真机或模拟器自动化;
- Tauri WebView 和 Rust 宿主;
- 数据库读写和业务数据验收;
- 完整业务页面覆盖;
- 远程机器、局域网和跨主机防火墙验证。
2. 场景矩阵
下表覆盖了判断核心连接条件所需的关键正向和负向场景。它不是所有配置组合的穷举。
| 编号 | 场景 | 阶段一:CLI → HBuilderX | 阶段二:Web/Automator | 阶段三:测试报告 | 结果 |
|---|---|---|---|---|---|
| A | CLI 自行编译并启动 Web 服务 | 成功 | 成功 | 有效通过报告 | 可正常执行 |
| B | 复用带 Automator 的已有服务 | 成功 | 页面地址和端口匹配,连接成功 | 1 个冒烟用例通过 | 可以复用 |
| C | 复用普通 GUI Web 服务 | 成功 | 页面可访问,但 Automator 连接失败 | 运行时异常或无有效用例 | 不能复用 |
| D | 已有服务端口与 CLI 端口不一致 | 成功 | Failed to connect to runtime |
测试未有效开始 | 连接失败 |
| E | compile:false、无 h5.url、绑定地址无效 |
成功 | CLI 自行编译时 EADDRNOTAVAIL |
未生成有效报告 | 环境阻塞 |
| F | compile:false、无 h5.url、本机地址有效 |
成功 | CLI 仍尝试自行编译,未复用 GUI 服务 | 超时或无有效报告 | 环境阻塞 |
| G | 检查 GUI 服务是否自带 Automator | 成功 | 当前 GUI 服务未发现端点 | 不适用 | 普通 Web 服务 |
3. 各场景说明
3.1 场景 A:CLI 自行编译并启动
该场景中,官方 CLI 自己启动编译器和 Automator 运行时。
验证重点:
- 主机地址可以被当前机器绑定;
- 编译服务可以启动;
- CLI 能够打开页面;
- Automator 运行时能够连接;
- 测试报告中存在实际执行的测试用例。
该场景可以证明官方 CLI 自己管理整条链路时能够工作,但不能证明普通 GUI 服务可以被复用。
3.2 场景 B:复用带 Automator 的已有服务
该场景中,先启动页面服务,并在编译时注入 Automator 地址,再让官方 CLI 使用相同的页面地址和 Automator 端口。
成功条件:
页面地址:       http://127.0.0.1:5174/
页面 Automator: 127.0.0.1:9538
CLI Automator:   127.0.0.1:9538
本次验证中,运行日志出现了 Automator 连接和 program ready,并且冒烟用例通过。这证明“已有服务复用”本身是可行的,但前提是服务已经具备 Automator 能力。
3.3 场景 C:复用普通 GUI Web 服务
该场景中,页面地址可以访问,但服务只提供普通 HTTP/Vite 能力,没有对应 Automator 端点。
实际表现:
- 浏览器上下文可以创建;
- 页面 URL 可以被访问;
- 运行时连接阶段失败;
- 出现
Failed to connect to runtime; - 测试套件可能没有真正执行。
这说明页面服务可访问和官方自动化可用是两个独立条件。
3.4 场景 D:端口不一致
已有页面服务在编译时使用 Automator 端口 9538,而 CLI 运行时使用动态分配的 9539。
两个进程可能都处于运行状态,但它们不会自动建立同一个 Automator 会话,最终表现为运行时连接失败。
3.5 场景 E:无效绑定地址
在 compile:false 且没有 h5.url 的配置下,CLI 仍尝试启动自己的编译服务。如果 Automator 主机被设置为当前机器不存在的地址,编译器会在监听阶段报:
EADDRNOTAVAIL: address not available这属于服务启动失败,不属于测试用例断言失败。
3.6 场景 F:compile:false 但没有 h5.url
将绑定地址改为 127.0.0.1 后,CLI 仍尝试启动自己的编译服务。由于 GUI 已占用默认页面端口,CLI 改用其他页面端口,但没有自动复用 GUI 服务,最终测试没有有效完成。
该结果说明:
compile:false不是“自动查找并复用已有 Web 服务”的充分条件。
3.7 场景 G:检查 GUI 服务是否自带 Automator
本次检查包括:
- 查看 Web 服务进程启动参数;
- 查看页面入口响应;
- 检查页面和日志中是否存在 Automator 地址;
- 检查对应 Automator 端口是否监听。
当前 GUI 服务是普通 Web 编译服务,没有发现官方自动化复用所需的 Automator 端点。
4. 环境与结论的边界
4.1 已确认的事实
- 当前版本的官方 CLI 可以连接正在运行的 HBuilderX;
- CLI 可以执行项目打开操作;
- CLI 可以自行编译并运行 Web 自动化测试;
- 带匹配 Automator 地址的已有服务可以被复用;
- 普通 HTTP/Vite 服务不能仅凭页面地址被复用;
- Automator 端口不一致会导致运行时连接失败;
compile:false不足以单独决定复用哪一个已有服务;- 无效主机地址会导致编译服务启动失败。
4.2 尚未穷举的组合
以下内容没有在本次矩阵中全部穷举:
- 其他 HBuilderX 版本的 CLI 与 GUI 组合;
- 不同操作系统下的网络绑定行为;
- 局域网地址和远程测试机之间的连接;
- GUI 中可能新增的 Automator 服务启动选项;
- 所有
compile、h5.url、主机、端口排列组合; - 完整业务页面和多页面测试。
因此,本文应使用“在本次验证环境中确认”这样的表述,不应宣称已经验证了所有版本和所有配置。
5. 复现记录最少应包含的环境信息
- 操作系统和命令行环境;
- HBuilderX 版本;
- 官方 CLI 输出版本;
- uni-app x 编译器版本和渲染模式;
- 测试平台和浏览器驱动;
- HBuilderX GUI 是否正在运行;
- CLI 实际使用的路径;
- 项目打开结果;
- 页面 HTTP 地址和端口;
- Automator 主机和端口;
compile、h5.url和自定义环境变量;- 测试报告路径和套件/用例统计;
- 未覆盖的场景和环境限制。
03. 排查手册
1. 排查原则
排查时不要直接从业务断言开始。应按官方测试的实际连接顺序逐层确认:
HBuilderX GUI
  ↓
CLI 程序
  ↓
项目打开
  ↓
Web 页面服务
  ↓
Automator WebSocket
  ↓
测试套件
  ↓
官方 JSON 报告
前一层没有通过时,不要用后一层的现象解释问题。
2. 第一步:确认 HBuilderX GUI
需要确认:
- HBuilderX 窗口或进程确实正在运行;
- 没有停留在启动失败、更新未完成或插件加载失败状态;
- 当前 HBuilderX 是期望使用的版本;
- 目标项目已经被 HBuilderX 识别。
如果 HBuilderX 没有运行,CLI 通常不能依靠测试命令自行替代 GUI 控制入口。应记录为 blocked,不要报告为业务测试失败。
3. 第二步:确认 CLI 来源
记录 CLI 实际使用的完整路径和输出版本。
重点检查:
- CLI 是否来自当前 HBuilderX 安装目录;
- 是否存在多个 HBuilderX 安装;
- 环境变量是否把 CLI 指向了旧安装;
- CLI 调用的内置 Node、编译器和测试插件是否属于同一套安装。
如果 GUI 和 CLI 不是同一版本体系,首先应排除工具链混用问题。
4. 第三步:确认项目打开
CLI 项目打开操作成功,只能证明项目控制入口可用。
需要记录:
- 项目路径是否存在;
- 项目是否包含有效的 uni-app x 工程文件;
- CLI 项目打开命令的退出码;
- 是否出现“项目未打开”“项目不存在”或超时;
- HBuilderX 是否切换到目标项目。
项目打开失败时,不要继续修改页面测试断言。应先解决工程识别或 CLI 连接问题。
5. 第四步:确认测试配置
至少检查以下配置:
5.1 compile
确认是否让官方 CLI 自己编译,还是准备复用已有服务。
不要把以下两种含义混为一谈:
compile:false:不应简单解释为“自动连接任意已运行服务”;h5.url:只指定页面访问地址,不自动为页面添加 Automator 能力。
5.2 h5.url
如果要复用已有 Web 服务,应确认:
- 地址指向当前实际运行的页面服务;
- 协议、主机、端口和路径都正确;
- 该页面服务在测试期间不会被切换或重启。
5.3 Automator 主机和端口
确认页面编译时使用的 Automator 主机、页面实际连接的端口,以及 CLI 测试运行时使用的端口。
推荐把三者记录在同一张表中:
| 位置 | 主机 | 端口 |
|---|---|---|
| 页面编译配置 | 127.0.0.1 |
9538 |
| 页面实际运行时 | 127.0.0.1 |
9538 |
| CLI 测试运行时 | 127.0.0.1 |
9538 |
页面端口和 Automator 端口可以不同,但页面和 CLI 的 Automator 端点必须指向同一个运行时。
6. 第五步:确认 HTTP 页面服务
先验证页面 HTTP 地址,再验证 Automator。
PowerShell 示例:
Invoke-WebRequest -UseBasicParsing -Uri 'http://127.0.0.1:<web-port>/'页面请求失败时,检查:
- Web 服务是否已经启动;
- 页面端口是否被其他进程占用;
- 服务是否绑定到正确主机;
- 服务是否在测试过程中退出;
- CLI 日志是否显示了实际使用的 URL。
页面 HTTP 检查成功后,仍必须继续检查 Automator 端点。
7. 第六步:确认 Automator 运行时
重点查看官方测试日志中的以下信息:
automator:launcher
automator:runtime
connected
program ready
Failed to connect to runtime
7.1 出现 connected 或 program ready
说明 Automator 运行时已经建立连接,可以继续判断测试脚本和页面行为。
7.2 出现 Failed to connect to runtime
优先检查:
- 页面是否只是普通 HTTP 服务;
- 页面是否注入了 Automator 地址;
- 页面和 CLI 的 Automator 端口是否一致;
- Automator 主机是否可访问;
- 页面服务是否在测试前已经重启;
- CLI 是否连接到了旧端口或动态分配的新端口。
该错误通常不是业务用例断言失败。
7.3 出现 EADDRNOTAVAIL
说明服务尝试绑定当前机器无法使用的主机地址。应先检查主机配置和网络接口,不要先修改测试脚本。
7.4 页面端口被占用
如果日志显示 Web 服务自动换到其他页面端口,应确认:
h5.url是否仍然指向旧端口;- 页面编译结果中的 Automator 地址是否仍然有效;
- CLI 是否真的连接了新服务;
- 是否因此误把端口变化当成页面测试失败。
8. 第七步:确认测试套件真正执行
Automator 连接成功后,还要确认 Jest 测试本身有效。
重点检查:
- 测试文件是否被纳入
testMatch; - 测试文件是否可以被 Babel/Jest 解析;
- 测试套件数量是否大于零;
- 测试用例数量是否大于零;
- 测试是否在
beforeAll或页面启动阶段失败; - 页面断言是否真正执行。
如果日志显示:
Tests: 0 total则不能把这次运行报告为功能通过。
如果出现 JavaScript 语法错误,应记录为 test-invalid 或测试脚本失败,而不是 Automator 连接成功。
9. 第八步:确认官方 JSON 报告
官方 JSON 报告是判断测试是否有效的重要证据。至少检查:
- 报告文件是否生成;
numTotalTestSuites是否大于零;numTotalTests是否大于零;numRuntimeErrorTestSuites是否为零;numFailedTestSuites是否为零;numFailedTests是否为零;success字段与详细统计是否一致。
建议不要只看终端最后一行,也不要只看退出码。退出码、日志和 JSON 报告需要相互印证。
10. 错误现象与处理方向
| 错误现象 | 优先判断 | 不应直接判断为 |
|---|---|---|
| 未检测到 HBuilderX | GUI 或 CLI 环境阻塞 | 页面业务失败 |
| 项目打开失败 | 项目路径或 HBuilderX 识别问题 | Automator 断言失败 |
EADDRNOTAVAIL |
绑定主机地址无效 | 测试用例失败 |
Failed to connect to runtime |
Automator 地址、端口或注入缺失 | 页面 HTTP 不可访问 |
| 页面可打开但测试为 0 | 测试范围、脚本或运行时问题 | 功能通过 |
| JavaScript 语法错误 | 测试脚本无效 | Web 服务连接失败 |
| 生成报告但包含运行异常 | 测试没有完整通过 | 仅凭 success 字段通过 |
| 超时且没有有效报告 | 环境阻塞或进程未完成握手 | 业务断言失败 |
11. 常见误区
11.1 CLI 已启动,不代表 HBuilderX 已连接
CLI 进程启动只能说明命令被调用。还需要确认 HBuilderX 检测、项目打开和官方测试插件初始化结果。
11.2 HBuilderX 已连接,不代表页面运行时已连接
控制层和运行时是两个阶段。必须继续查看 Automator 日志。
11.3 页面可访问,不代表页面可自动化
普通 HTTP/Vite 服务可能没有 Automator WebSocket。
11.4 compile:false 不保证复用服务
没有 h5.url 或没有匹配的 Automator 端点时,CLI 可能自行启动编译服务,或者最终无法完成运行时连接。
11.5 动态端口不应未经确认直接使用
页面编译时注入的端口、CLI 运行时端口和页面实际连接端口必须一致。只看到 CLI 分配了端口,不代表页面已经同步使用该端口。
11.6 一个冒烟用例通过不等于完整验收通过
冒烟用例只能证明连接链路和该用例覆盖的行为。完整应用验收仍需独立的测试矩阵和必要的平台验证。
12. 推荐的最小排查命令
以下命令仅用于说明检查顺序,实际路径和端口应替换为当前环境值:
# 检查页面 HTTP 服务
Invoke-WebRequest -UseBasicParsing -Uri 'http://127.0.0.1:<web-port>/'

# 检查 Automator 端口
Test-NetConnection -ComputerName 127.0.0.1 -Port <automator-port>

# 使用 HBuilderX 官方 CLI 打开项目
<hbuilderx-cli> project open --path <project-root>

# 执行官方 Web 自动化测试
<hbuilderx-cli> uniapp.test web-chrome --project <project-root>
如果当前 PowerShell 或 HBuilderX 版本不支持某个检查命令,应记录替代命令和实际输出,不要把未执行的检查写成通过。
13. 清理和恢复
测试工具可能临时修改测试范围、环境配置或生成报告文件。测试结束后应确认:
- 仅保留用户明确需要的配置变化;
- 临时测试文件已经清理;
- 临时编译进程已经退出;
- HBuilderX 原有 Web 服务没有被误停;
- 失败证据、日志和 JSON 报告按需要保留;
- 配置文件差异经过审查。
14. 排查结论模板
可以使用以下格式记录一次结果:
HBuilderX GUI:已运行 / 未运行
CLI 连接:成功 / 失败
项目打开:成功 / 失败
页面 HTTP 服务:可访问 / 不可访问
Automator 运行时:已连接 / 未连接
测试套件:已执行 / 未执行
官方 JSON 报告:有效 / 缺失 / 内容不完整
最终状态:passed / failed / blocked / incomplete / test-invalid
根因:
证据:
未覆盖范围:iOS审核被拒4.3a怎么办?从指纹来源到重签名的二进制加固实操
做 iOS 开发的人,对 App Store 审核被拒这件事都不会陌生。各种 Guideline 代码见得多了,但 4.3a 绝对是最让人头疼的那几个之一。尤其是做工具类、内容类、或者所谓“马甲包”策略的产品,几乎都会撞上这堵墙。最近我连续处理了几个 4.3a 的项目,核心手段都绕不开“二进制加固”这四个字,所以干脆把这段时间的实践整理出来,聊聊我理解的 4.3a 到底是什么,二进制加固能解决哪些问题,以及具体操作时有哪些值得注意的细节。
这篇文章的目标读者是正在准备上架的 iOS 开发者,尤其是被 4.3a 拒过、想系统了解怎么应对的团队。内容不聊玄学,只讲实操。我会从苹果审核机制讲起,把二进制加固的四个层面、具体操作流程、常见问题排查和长期策略全部拆开说清楚。文中的所有方案都是我和同行在实际提审过程中验证过的常见做法,但每个 App 情况不同,请务必结合你自己的产品形态和生产环境做调整。

1. 内容整体设计与思路拆解
1.1 4.3a 到底是什么:被拒代码背后的含义
先把这个代码拆开看。4.3a 是苹果审核反馈里的一组分类编号,4.3 大类叫 “Spam”(垃圾信息),4.3.0 是其中的一个通用子类,a 可以理解为该子类下的具体情形或者审核记录里附加的参考标记。很多开发者习惯直接说“4.3a”,其实完整的文案通常是:
Guideline 4.3(a) - Design - Spam
苹果会给被拒 App 附上一段说明,大意是“你的 App 与市场上已有 App 存在显著相似的内容、功能、界面或元数据,或者缺少原创价值,会被视为垃圾信息”。
说白了,4.3a 就是苹果在告诉你:
你这 App 看起来像是“套壳”的,或者和别的产品太像了,不给你过。
这里的“像”不只是代码像,还包括:界面结构像、功能模块像、文案像、甚至上架账号之间的关联信息像。苹果的审核团队有一套自动和人工结合的检测机制,专门用来识别重复内容、模板化上架、马甲包和批量做号行为。它并不是单纯扫描代码字符串,而是综合判断产品形态。
1.2 为什么说“二进制加固”是必然选择
既然 4.3a 是针对“相似性”和“原创性”的判断,那最常见的两条路就是:
换皮改界面、改功能。
想办法让审核看到的产品“不太一样”,同时在技术层面提高识别难度。
换皮从产品层面没错,但你架不住竞品也在换皮,三方都在同一个市场里互抄,界面越改越像。而且如果一个功能逻辑本身是刚需,大家做出来的交互结构天然就会相似。这时候,从技术层面对 App 的二进制文件、元数据、资源结构做一次“深度差异化改造”,就是很多团队的实际选择。这就是大家口中说的“二进制加固”。
我理解的 iOS 二进制加固并不是加密或者防逆向,而是
在提审前对 App 的产物(IPA 包内的二进制、资源文件、签名信息)进行结构化调整和改造,让自动审核系统难以基于二进制层面的指纹特征直接判定你和其他 App 重复。
用生活类比解释一下:你去一栋写字楼办事,楼下保安每天看几百号人。你天天穿着同一件帽衫,帽衫上还有专属 logo,保安扫一眼就知道“又是你”。二进制加固做的事情,就是让你换件普通但不重样的衣服、换条路线、换个门禁卡,让保安没法一眼认出你就是昨天那批人里的一个。但如果你楼里的房间摆设、办公桌上放的东西全跟隔壁一模一样,保安上到 28 楼一巡,照样能盘问你。所以加固绝不是唯一的解药,产品层的差异是前提。
1.3 一次典型提审流程中,加固处在哪个环节
从开发完毕到拿到审核结果,一次完整流程是:
代码开发完成,本地调试。
配置签名、打包 Archive,导出 IPA。
对 IPA 执行二进制加固操作。
重新签名并验证安装。
上传 App Store Connect,填写元数据。
等待审核。
如被拒,根据反馈调整后重提。
二进制加固卡在“导出 IPA”和“上传”之间。如果你在开发阶段就想好了要加固,你还可以在工程配置里提前预留一些手段,比如优化编译选项、调整资源结构、改造启动逻辑,这样后续处理会更顺。千万不要等被拒了再思考怎么加固,那样往往只能临时抱佛脚,处理质量一般。
这一节我想强调的核心思路是:
4.3a 是产品相似性问题,二进制加固只是手段之一。手段要配合产品差异化、元数据差异化一起用,否则就是治标不治本。
2. 核心细节解析与实操要点
2.1 二进制指纹到底是怎么来的
为什么功能、界面都已经按自己的思路做了,苹果还是能判定相似?因为自动审核系统可以在不反编译源码的前提下,从 IPA 里提取出大量“指纹特征”。常见的有以下几类:
代码逻辑指纹:对二进制反汇编后,提取函数调用关系、字符串常量、方法名、类名。
资源指纹:对图片、图标、启动页、音频等资源进行哈希或感知哈希比对。
元数据指纹:Bundle ID、Display Name、版本号、蓝牙权限描述文案、麦克风权限描述文案等。
网络服务指纹:App 启动后请求的域名、接口路径、统计 SDK 的特征字段。
这些指纹本身不代表代码好坏,但它们组合起来就是一个“App 身份画像”。画像越接近,被判定为相似 App 的可能性就越大。
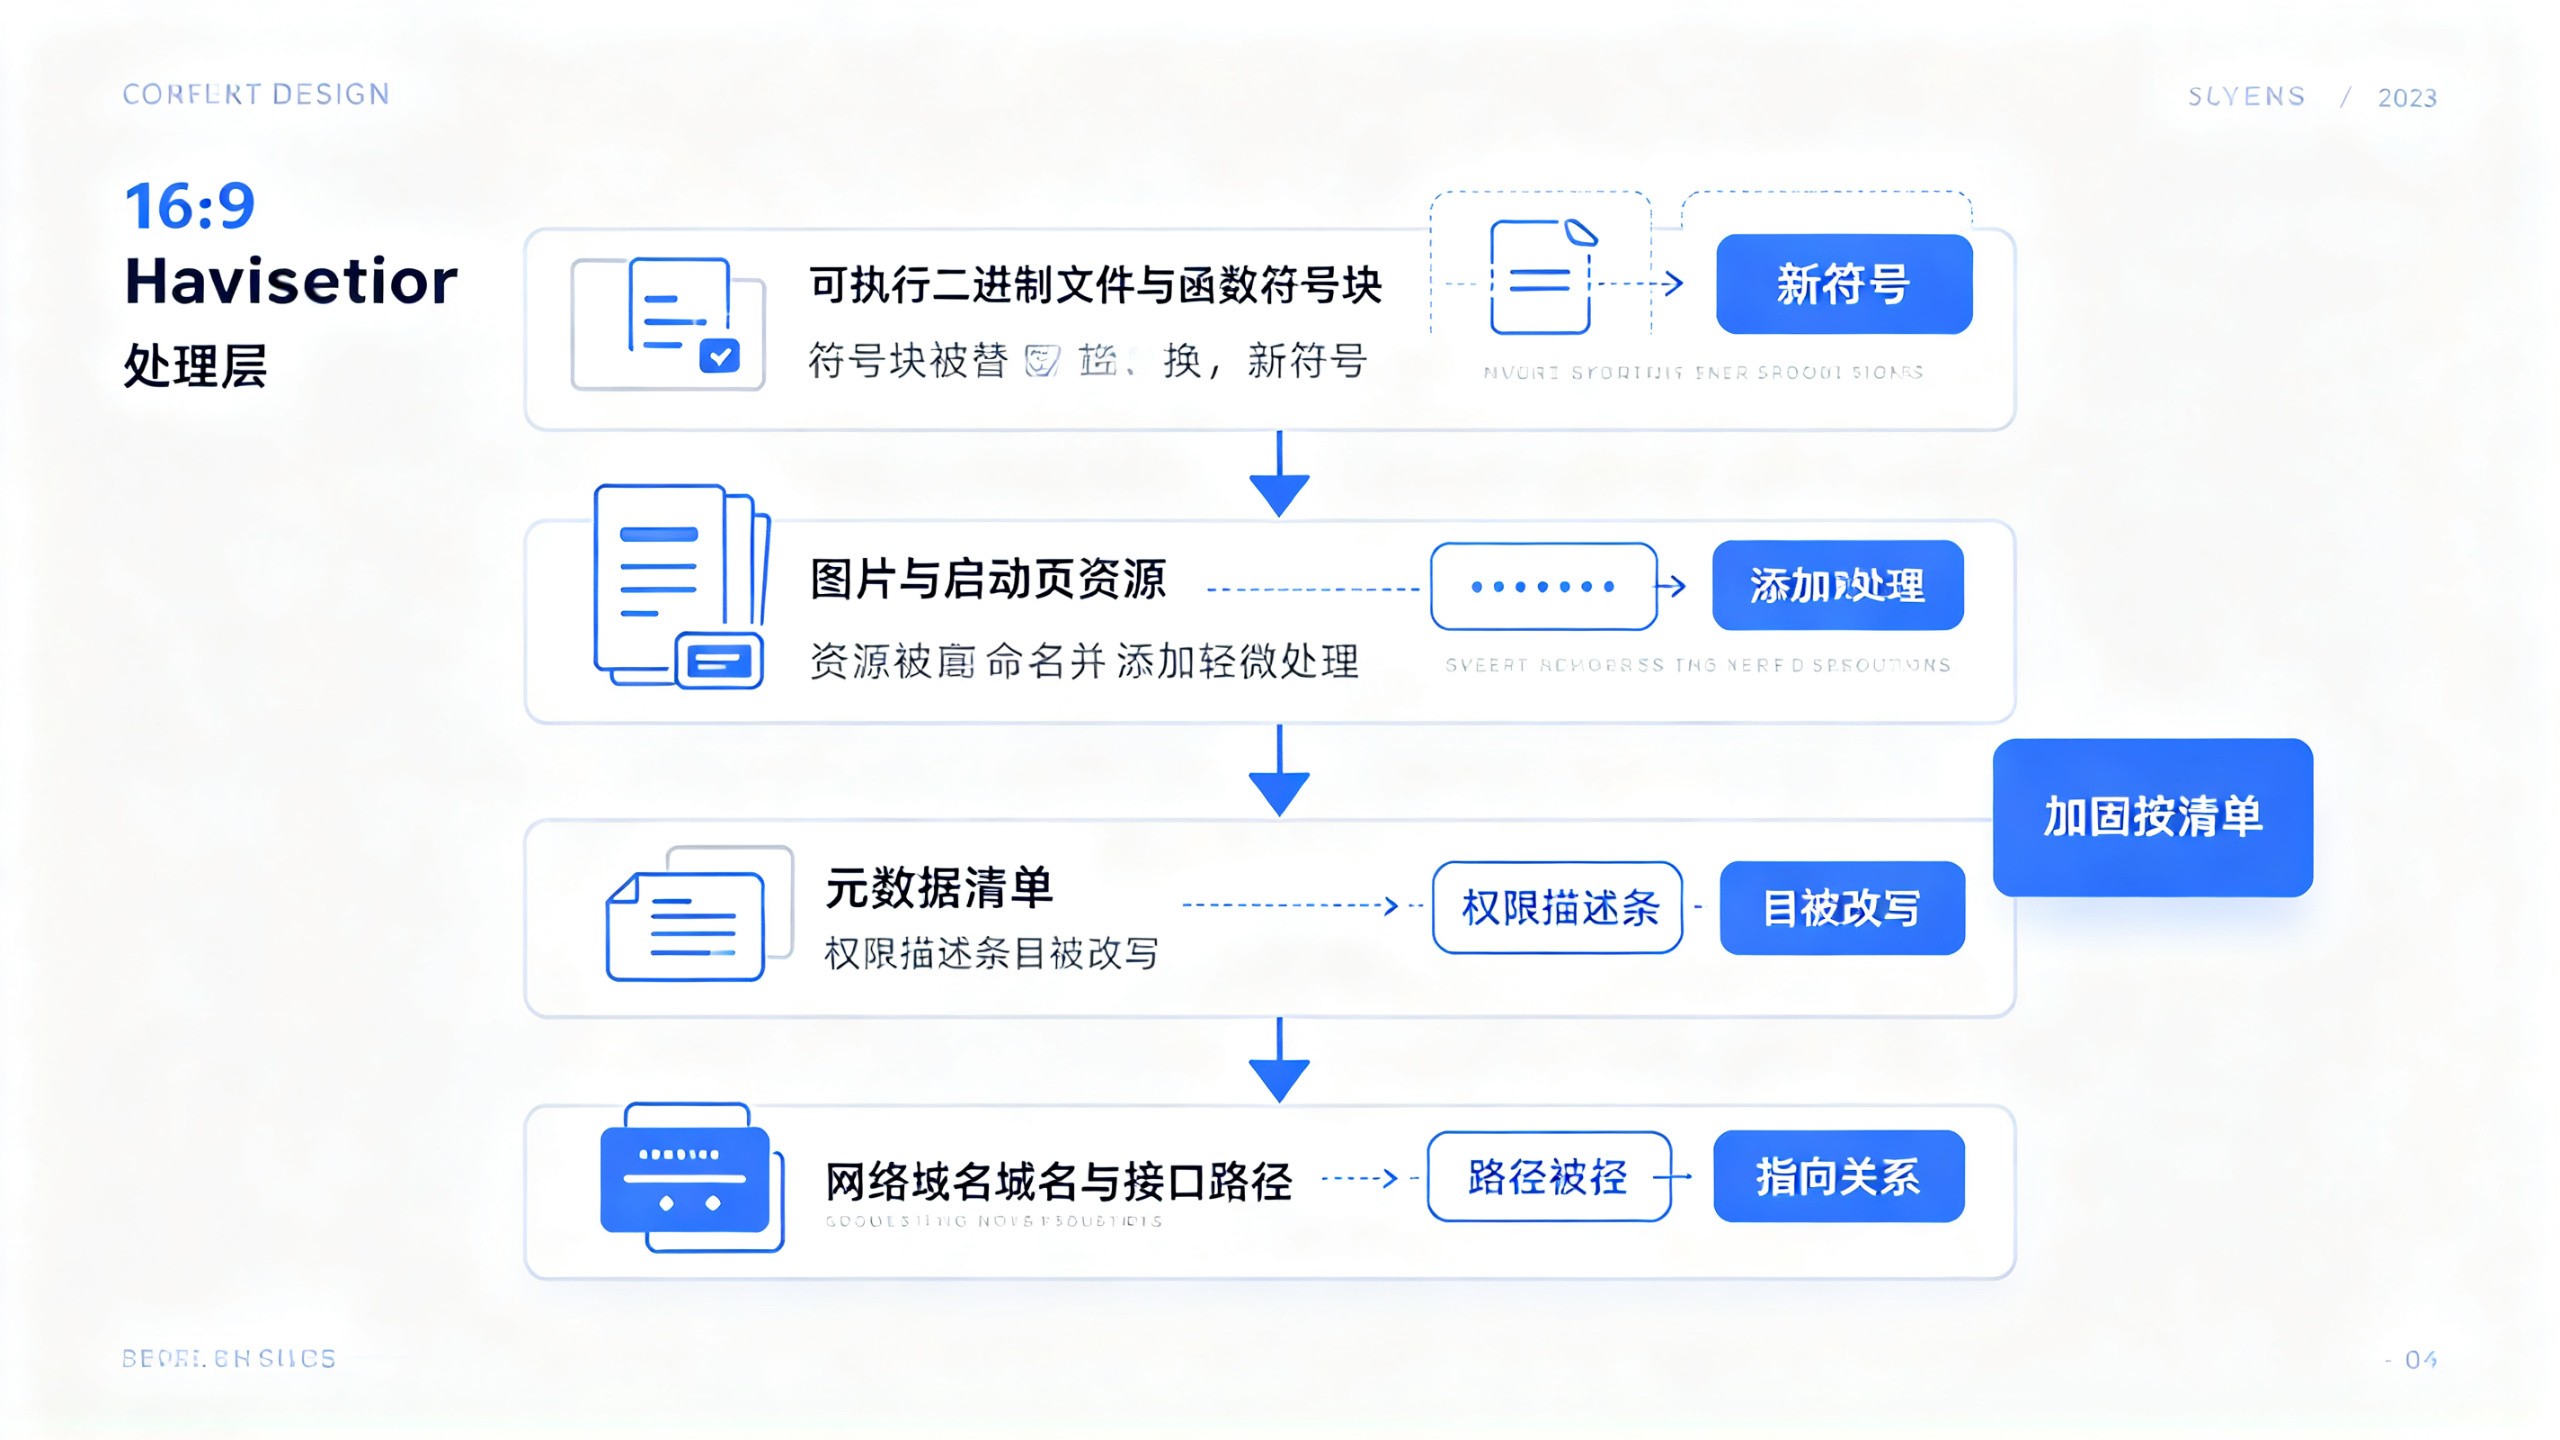
2.2 二进制加固的四个层面
我习惯把 iOS 二进制加固拆成四个层面,每一层解决不同的问题:
第一层:二进制文件结构层
对 Mach-O 可执行文件本身做处理,包括但不限于:
类名和方法名混淆(Symbol 混淆)。
字符串加密,避免在二进制中明文暴露关键路径和文案。
控制流平坦化,干扰自动比对工具对函数结构的分析。
插入无效代码块,改变函数布局特征。
这一层的目标,是让“代码逻辑指纹”发生显著变化。实际操作中,字符串加密和符号混淆对指纹的影响最大。
第二层:资源与文件结构层
更换资源文件的命名与目录结构,消除可逆的对应关系。
对图片添加不可见噪点或轻微压缩,改变哈希值,同时不影响肉眼观感。
对配置 plist 进行字段拆分或加密。
调整文件夹顺序、后缀名,但需保证 iOS 系统仍能正常读取。
这一层直接对抗的是“资源指纹”和部分元数据指纹。
第三层:元数据层
调整权限文案,避免出现相同的“定位权限描述”“相机权限描述”。
更换技术支持URL、隐私政策URL,保持真实可用,别用假页面。
合理设置版本号和构建号,但要遵循 App Store 的版本规则。
Bundle ID 需要独立,不要和已上架产品的 Bundle ID 有任何关联。
第四层:启动与动态行为层
让 App 首次启动时呈现不同的引导流程或加载顺序。
调整首屏数据请求时机,改为部分启动之后再发起请求。
替换或移除高辨识度的第三方 SDK 默认日志特征。
这一层偏向动态行为,对抗的是人工审核抽查。前几层是让“机器认不出”,这一层是让“人不好认”。
2.3 应该使用哪些加固工具和策略
iOS 生态和 Android 不太一样,Android 可以很方便地做资源混淆、字节码混淆,但 iOS 的代码是编译成原生机器码的,常规的代码混淆工具普及度不高。很多团队用的是这几类方案:
开源的 iOS 混淆工具(如部分基于 LLVM 的 Pass 实现),通过在编译阶段插入自定义 pass,对符号名进行处理。
商业加固服务(需要自行评估稳定性和合规性)。
自研脚本:结合 class-dump、Hopper、otool 等工具,在编译完成后对产物做后处理。
我自己常用的方式是:
编译阶段混淆 + 提审前脚本处理
。编译阶段做符号混淆、字符串加密,提审前用脚本改资源、权限文案、重新签名。这个组合实操性最强,也最可控。
这里要提醒一句:不要过度依赖网上的“一键加固”脚本。很多脚本确实能改符号名,但它们生成的特征高度一致,如果大家都在用同一套规则,反而可能被批量标记。加固方案要有自己的随机种子和独有规则。
3. 实操过程与核心环节实现
3.1 开始前需要准备哪些东西
工具清单如下:
macOS 系统,Xcode 已安装。
一个有效的开发者账号,签名证书和描述文件已配置。
Apple Transporter 或 Xcode Organizer,用于上传 IPA。
终端环境,用于执行脚本。
class-dump(用于检查 Class 信息导出情况)。
Hopper 或 IDA(用于人工查看二进制结构,验证混淆效果)。
一个用于解包和重签名的签名工具(如 ios-app-signer、fastlane sigh,或者自研脚本)。
还有一个容易被忽略的准备:
把你的 App 原始安装包和加固后的安装包分别保存好
,后续定位问题要用。
3.2 编译阶段做符号混淆与字符串加密
以目前主流的 Objective-C 和 Swift 混合项目为例,编译阶段的处理思路是:
对 Objective-C 代码,使用 LLVM Pass 对自定义类名、方法名做混淆。
对 Swift 代码,尽量依靠编译器的 Internal 可见性优化,同时避免在 public API 上暴露敏感方法。
对字符串做加密,分两种:一种是敏感字符串(网络接口地址、密钥、固定文案)运行时解密;另一种是全部字符串加密,但这会影响启动性能,需要谨慎。
实操中,字符串加密我通常只针对黑名单里的敏感信息做处理,不搞全量加密。全量加密听着安全,其实容易出现富文本显示异常、本地化失效、通知文案乱码等问题。
// 伪代码:字符串加密思路
// 在编译前将字符串替换为加密后的字节数组,并在运行时解密
static NSString * decryptString(uint8_t *data, int len, uint8_t key) {
    NSMutableData *out = [NSMutableData dataWithCapacity:len];
    for (int i = 0; i < len; i++) {
        uint8_t b = data[i] ^ key;
        [out appendBytes:&b length:1];
    }
    return [[NSString alloc] initWithData:out encoding:NSUTF8StringEncoding];
}
编译阶段处理完后,先正常出包一次,确认 App 能跑起来,再做后续的提审前处理。
3.3 提审前对 IPA 做资源与元数据改造
这一步我按固定的顺序执行,顺序很重要,因为每一步处理都依赖前一步的结果:
解压 IPA,获取 Payload 目录。
使用工具遍历资源,对图片做轻微压缩或加噪。
重命名部分资源文件和目录名。
修改 Info.plist 中的权限文案、技术支持页面、隐私链接。
对二进制做可选的额外符号处理。
重新签名。
重打包,使用本地模拟器或真机验证安装。
使用 class-dump 抽查,确认类名方法名已经改变。
上传前再跑一次启动测试,确认没有白屏和崩溃。
完整命令链路没必要硬背,关键是理解每一步的目的。比如图片重压缩,可以用 sips 脚本对 PNG 做轻微采样。注意:不要对启动图、App 图标做过度压缩,会直接影响审核观感。图标清晰度是有隐形要求的,模糊图标容易引来其他审核问题。
3.4 重新签名与验证安装
修改过 IPA 后,签名信息必然失效,必须重新签名。流程如下:
准备好 Distribution 证书和描述文件。
使用签名工具选择对应证书,对 Payload 里的 .app 进行签名。
将 .app 压缩为新的 IPA。
签名完成不代表万事大吉,还需要验证:
在 iOS 真机上通过本地安装方式,确认 App 可以打开。
检查签名:在终端执行 codesign -d,查看签名信息是否正确。
查看 Permission 是否完整,尤其是推送、位置、相机、麦克风等 entitlement 文件。
很多新手在这一步容易犯的错是:只改了二进制,没处理 entitlements,导致推送功能在审核设备上失效,或者启动直接闪退。这属于操作失误,而不是策略问题。
3.5 上传审核与等待反馈
上传前,App Store Connect 里还需要做好元数据层面的配合:
App 名称不要与大厂或热门产品过度相似。
截图要反映 App 真实的界面,不要拿模板警示图。
审核备注可以简单说明产品用途和核心功能。
上传完成后,等待审核。期间不要反复提交相同包。如果发现同一个 Bundle ID 在短时间内重复上传相同内容的包,苹果的后台系统会有记录,反而增加 4.3a 嫌疑。
4. 常见问题与排查技巧实录
4.1 加固后启动闪退
这类问题出现频率最高。常见原因有:
字符串解密时机不对,在类初始化前就引用了解密后的字符串。
符号混淆后,KVC、KVO、NSCoding 等动态调用没有正确适配(因为运行时找不到对应的方法名)。
第三方 SDK 内部使用了硬编码的类名,混淆后引发崩溃。
重签名时证书与描述文件不匹配。
排查工具我推荐使用 Xcode 的崩溃日志和 Device Log。先查看崩溃堆栈,再逐步确认是哪个环节引起的。如果堆栈指向某个知名 SDK 内部,那就说明混淆规则需要排除该 SDK 的类名。
4.2 加固后功能正常但审核仍然 4.3a
这个情况最让人挫败,但原因往往不在二进制:
你的产品在功能设计层面与已上架产品依然高度重合。
图标、截图、宣传文案和现有产品过于相似。
使用的第三方 SDK 布局相似,审核人员一眼就能看出同源。
遇到这种反馈,不要急着继续加固。先把审核返回的截图和描述反复看几遍,通常在邮件或 App Store Connect 的 Resolution Center 里会有更细的说明。如果对方说“界面与某 App 相似”,那就先把界面差异化做够再说。
调整完后,如果仍然 4.3a,可以提交申诉(App Review 申诉),在申诉里解释你的产品和其他产品的核心区别。申诉话术要言简意赅,不要长篇大论,重点写清楚“产品定位、核心功能、目标用户”三个点。
4.3 加固后上架成功,但后续更新又被 4.3a
有不少团队会碰到“第一版过了,第二版 4.3a”的情况。两个原因比较常见:
后续版本中引入了与市面上热门 App 相同的功能模块,且界面照搬。
加固方案没有延续,开发者后续直接用普通包提交,导致二进制指纹前后出现差异。
这里需要说明:苹果的审核,本质上是一种综合判断。你第一版通过,并不意味着你的马甲方案获得了永久认可。每次提审都相当于一次新的身份核查。所以,如果你做了加固,务必在每个后续版本中延续相同的加固规则和随机种子,否则前后指纹不一致,反而会让审核系统觉得这个产品存在问题。
4.4 常见问题速查表
| 现象 | 可能原因 |
|---|
解决方案
| | 启动闪退 | 字符串解密时机问题 |
|---|
将解密提前到最早入口,或改为懒加载
| | 启动闪退 | 混淆后 KVC/KVO 失效 |
|---|
添加排除名单,保留动态调用所需方法
| | 功能模块缺失 | 资源重命名后引用错误 |
|---|
重新检查资源加载路径,运行时验证
| | 推送失效 | entitlements 丢失 |
|---|
重签名时保留原始 entitlement 文件
| | 审核仍然 4.3a | 产品界面和竞品过于相似 |
|---|
优先调整界面、拍摄截图、说明差异
| | 上传后 1-2 个小时被拒 | 元数据或图标异常 |
|---|
检查图标尺寸、关键字和截图
|
4.5 一些需要留意的坑
关于方法名混淆,最常见的问题是把系统回调方法也混淆掉,比如 viewWillAppear、didReceiveMemoryWarning。它们必须保持原样,否则 UIKit 找不到回调。所以混淆规则的排除名单一定要包含所有系统 API 和需要动态绑定的方法。
关于第三方 SDK,我建议在混淆配置里直接排除所有 pod 目录或 framework 目录里的类,只处理你自己的代码。这样做虽然加固范围变小,但稳定性大大提高。毕竟审核判定相似性,看的不是你 SDK 部分的代码逻辑,而是你 App 整体结构、资源、元数据的组合特征。
关于网络请求域名,如果你的 App 内部请求了和母包一致的域名和路径,那二进制再怎么改,网络层面的指纹还是暴露的。建议对新包使用独立的 API 域名,或者至少使用不同的路径前缀和参数结构。
5. 避坑经验与长期策略
5.1 不要只看“技术加固”,要配合产品差异
我见过太多团队,拿着同一套产品代码,改个配色、换几张图、跑一遍加固脚本就重新提审。结果第二天被拒,回复几乎一模一样。根本原因就是产品层差异等于零。苹果的审核团队每天看大量 App,一个 App 是真原创还是套壳,其实在对话截图和功能操作里很容易判断出来。
所以我的建议是:产品层至少要有 20% 以上的功能差异化。可以体现在交互流程、信息架构、核心卖点上,也可以体现在落地页内容里。不求完全创新,但要让审核人员和真实用户都能一眼看出,你和那个“相似产品”不是同一个东西。
5.2 建立自己的加固标准流程
与其每次被拒后临时处理,不如在项目启动时就把加固流程标准化。我把这个流程固定成三份文档:
代码规范文档:规定哪些类名、方法名需要开启混淆,哪些必须保留。
提审操作手册:从编译、加固、签名、上传到填写元数据,每一步的命令和工具都写清楚。
版本更新记录:记录每次提审用的加固随机种子、工具版本、资源处理参数。
持续维护这套流程,看起来费功夫,但长期下来能节省大量与审核来回拉扯的时间。特别是当你维护多个产品和多个开发者账号时,标准流程能避免操作遗漏。
5.3 关于账号隔离和关联风险
如果涉及多产品矩阵,最好让每个产品的 Bundle ID、证书、开发者账号归属保持独立,不要混用。苹果的账号关联判定一直是敏感点。多个 App 共用一个开发者账号、共用相同的隐私政策页面链接、共用同一批测试设备,这些都可能被认为是关联信号。做这些处理时,想清楚每一个关联点再做,不要盲目堆量。
这里说的关联风险不是让你去违规搞小动作,而是提醒你:如果确实是在经营多款独立产品,尽量让它们在技术和运营层面呈现出真实的独立性。这才是合法合规、可持续的做法。
5.4 后续版本如何防止复发
维护阶段最容易松懈。后续版本更新时,经常会有人直接在工程里改两行代码就提审,忘了跑加固流程。我的做法是:把加固脚本挂到持续集成(CI)流程中,每次打 release 包时自动执行。
CI 里至少包含这几步:
拉取代码,按版本号生成随机种子。
执行符号混淆和字符串加密。
修改资源与元数据。
自动重签名。
跑一次最小启动测试。
上传到内部服务器,或直接上传 App Store Connect。
把加固做成自动化流程的一部分,就不必依赖某位同学靠不靠谱了。机器执行永远不会忘记跑脚本。
6. 写在最后的实操心得
做 iOS 4.3a 二进制加固这件事,本质是一个“风险控制”话题。你要控制的是产品被判重、被判低质的风险。技术手段能让你的包在机器眼里的身份画像发生明显变化,但真正能让产品走远的,还是产品的独特性和用户价值。如果你只是单纯想靠加固蒙混过关,这条路大概率走不长。
我个人的体会是:每次被 4.3a 拒一次,其实都是一次重新审视产品的机会。先看产品层有哪些差异,再看技术层有没有做到位,最后才去考虑是不是审核有误、需要申诉。按照这个顺序排查,大多数问题都能落地解决。
最后分享一个小技巧:提审前用一台备用 iPhone,在 App Store 里搜几个同领域的 Top 级 App,把你的包和它们分别安装到两台手机上,并排截图对比。自己的 App 如果和竞品在功能主页上放着一看就神似,那就别急着提审,先改界面。这个习惯我坚持了很久,帮我避开了很多无效提审。
如果你正在被 4.3a 重复折磨,建议把这篇文章里的四个层面逐一对照检查。不要指望哪一步能单独救命,组合起来才能形成一个真正有效的提审方案。
做 iOS 开发的人,对 App Store 审核被拒这件事都不会陌生。各种 Guideline 代码见得多了,但 4.3a 绝对是最让人头疼的那几个之一。尤其是做工具类、内容类、或者所谓“马甲包”策略的产品,几乎都会撞上这堵墙。最近我连续处理了几个 4.3a 的项目,核心手段都绕不开“二进制加固”这四个字,所以干脆把这段时间的实践整理出来,聊聊我理解的 4.3a 到底是什么,二进制加固能解决哪些问题,以及具体操作时有哪些值得注意的细节。
这篇文章的目标读者是正在准备上架的 iOS 开发者,尤其是被 4.3a 拒过、想系统了解怎么应对的团队。内容不聊玄学,只讲实操。我会从苹果审核机制讲起,把二进制加固的四个层面、具体操作流程、常见问题排查和长期策略全部拆开说清楚。文中的所有方案都是我和同行在实际提审过程中验证过的常见做法,但每个 App 情况不同,请务必结合你自己的产品形态和生产环境做调整。
1. 内容整体设计与思路拆解
1.1 4.3a 到底是什么:被拒代码背后的含义
先把这个代码拆开看。4.3a 是苹果审核反馈里的一组分类编号,4.3 大类叫 “Spam”(垃圾信息),4.3.0 是其中的一个通用子类,a 可以理解为该子类下的具体情形或者审核记录里附加的参考标记。很多开发者习惯直接说“4.3a”,其实完整的文案通常是:
Guideline 4.3(a) - Design - Spam
苹果会给被拒 App 附上一段说明,大意是“你的 App 与市场上已有 App 存在显著相似的内容、功能、界面或元数据,或者缺少原创价值,会被视为垃圾信息”。
说白了,4.3a 就是苹果在告诉你:
你这 App 看起来像是“套壳”的,或者和别的产品太像了,不给你过。
这里的“像”不只是代码像,还包括:界面结构像、功能模块像、文案像、甚至上架账号之间的关联信息像。苹果的审核团队有一套自动和人工结合的检测机制,专门用来识别重复内容、模板化上架、马甲包和批量做号行为。它并不是单纯扫描代码字符串,而是综合判断产品形态。
1.2 为什么说“二进制加固”是必然选择
既然 4.3a 是针对“相似性”和“原创性”的判断,那最常见的两条路就是:
换皮改界面、改功能。
想办法让审核看到的产品“不太一样”,同时在技术层面提高识别难度。
换皮从产品层面没错,但你架不住竞品也在换皮,三方都在同一个市场里互抄,界面越改越像。而且如果一个功能逻辑本身是刚需,大家做出来的交互结构天然就会相似。这时候,从技术层面对 App 的二进制文件、元数据、资源结构做一次“深度差异化改造”,就是很多团队的实际选择。这就是大家口中说的“二进制加固”。
我理解的 iOS 二进制加固并不是加密或者防逆向,而是
在提审前对 App 的产物(IPA 包内的二进制、资源文件、签名信息)进行结构化调整和改造,让自动审核系统难以基于二进制层面的指纹特征直接判定你和其他 App 重复。
用生活类比解释一下:你去一栋写字楼办事,楼下保安每天看几百号人。你天天穿着同一件帽衫,帽衫上还有专属 logo,保安扫一眼就知道“又是你”。二进制加固做的事情,就是让你换件普通但不重样的衣服、换条路线、换个门禁卡,让保安没法一眼认出你就是昨天那批人里的一个。但如果你楼里的房间摆设、办公桌上放的东西全跟隔壁一模一样,保安上到 28 楼一巡,照样能盘问你。所以加固绝不是唯一的解药,产品层的差异是前提。
1.3 一次典型提审流程中,加固处在哪个环节
从开发完毕到拿到审核结果,一次完整流程是:
代码开发完成,本地调试。
配置签名、打包 Archive,导出 IPA。
对 IPA 执行二进制加固操作。
重新签名并验证安装。
上传 App Store Connect,填写元数据。
等待审核。
如被拒,根据反馈调整后重提。
二进制加固卡在“导出 IPA”和“上传”之间。如果你在开发阶段就想好了要加固,你还可以在工程配置里提前预留一些手段,比如优化编译选项、调整资源结构、改造启动逻辑,这样后续处理会更顺。千万不要等被拒了再思考怎么加固,那样往往只能临时抱佛脚,处理质量一般。
这一节我想强调的核心思路是:
4.3a 是产品相似性问题,二进制加固只是手段之一。手段要配合产品差异化、元数据差异化一起用,否则就是治标不治本。
2. 核心细节解析与实操要点
2.1 二进制指纹到底是怎么来的
为什么功能、界面都已经按自己的思路做了,苹果还是能判定相似?因为自动审核系统可以在不反编译源码的前提下,从 IPA 里提取出大量“指纹特征”。常见的有以下几类:
代码逻辑指纹:对二进制反汇编后,提取函数调用关系、字符串常量、方法名、类名。
资源指纹:对图片、图标、启动页、音频等资源进行哈希或感知哈希比对。
元数据指纹:Bundle ID、Display Name、版本号、蓝牙权限描述文案、麦克风权限描述文案等。
网络服务指纹:App 启动后请求的域名、接口路径、统计 SDK 的特征字段。
这些指纹本身不代表代码好坏,但它们组合起来就是一个“App 身份画像”。画像越接近,被判定为相似 App 的可能性就越大。
2.2 二进制加固的四个层面
我习惯把 iOS 二进制加固拆成四个层面,每一层解决不同的问题:
第一层:二进制文件结构层
对 Mach-O 可执行文件本身做处理,包括但不限于:
类名和方法名混淆(Symbol 混淆)。
字符串加密,避免在二进制中明文暴露关键路径和文案。
控制流平坦化,干扰自动比对工具对函数结构的分析。
插入无效代码块,改变函数布局特征。
这一层的目标,是让“代码逻辑指纹”发生显著变化。实际操作中,字符串加密和符号混淆对指纹的影响最大。
第二层:资源与文件结构层
更换资源文件的命名与目录结构,消除可逆的对应关系。
对图片添加不可见噪点或轻微压缩,改变哈希值,同时不影响肉眼观感。
对配置 plist 进行字段拆分或加密。
调整文件夹顺序、后缀名,但需保证 iOS 系统仍能正常读取。
这一层直接对抗的是“资源指纹”和部分元数据指纹。
第三层:元数据层
调整权限文案,避免出现相同的“定位权限描述”“相机权限描述”。
更换技术支持URL、隐私政策URL,保持真实可用,别用假页面。
合理设置版本号和构建号,但要遵循 App Store 的版本规则。
Bundle ID 需要独立,不要和已上架产品的 Bundle ID 有任何关联。
第四层:启动与动态行为层
让 App 首次启动时呈现不同的引导流程或加载顺序。
调整首屏数据请求时机,改为部分启动之后再发起请求。
替换或移除高辨识度的第三方 SDK 默认日志特征。
这一层偏向动态行为,对抗的是人工审核抽查。前几层是让“机器认不出”,这一层是让“人不好认”。
2.3 应该使用哪些加固工具和策略
iOS 生态和 Android 不太一样,Android 可以很方便地做资源混淆、字节码混淆,但 iOS 的代码是编译成原生机器码的,常规的代码混淆工具普及度不高。很多团队用的是这几类方案:
开源的 iOS 混淆工具(如部分基于 LLVM 的 Pass 实现),通过在编译阶段插入自定义 pass,对符号名进行处理。
商业加固服务(需要自行评估稳定性和合规性)。
自研脚本:结合 class-dump、Hopper、otool 等工具,在编译完成后对产物做后处理。
我自己常用的方式是:
编译阶段混淆 + 提审前脚本处理
。编译阶段做符号混淆、字符串加密,提审前用脚本改资源、权限文案、重新签名。这个组合实操性最强,也最可控。
这里要提醒一句:不要过度依赖网上的“一键加固”脚本。很多脚本确实能改符号名,但它们生成的特征高度一致,如果大家都在用同一套规则,反而可能被批量标记。加固方案要有自己的随机种子和独有规则。
3. 实操过程与核心环节实现
3.1 开始前需要准备哪些东西
工具清单如下:
macOS 系统,Xcode 已安装。
一个有效的开发者账号,签名证书和描述文件已配置。
Apple Transporter 或 Xcode Organizer,用于上传 IPA。
终端环境,用于执行脚本。
class-dump(用于检查 Class 信息导出情况)。
Hopper 或 IDA(用于人工查看二进制结构,验证混淆效果)。
一个用于解包和重签名的签名工具(如 ios-app-signer、fastlane sigh,或者自研脚本)。
还有一个容易被忽略的准备:
把你的 App 原始安装包和加固后的安装包分别保存好
,后续定位问题要用。
3.2 编译阶段做符号混淆与字符串加密
以目前主流的 Objective-C 和 Swift 混合项目为例,编译阶段的处理思路是:
对 Objective-C 代码,使用 LLVM Pass 对自定义类名、方法名做混淆。
对 Swift 代码,尽量依靠编译器的 Internal 可见性优化,同时避免在 public API 上暴露敏感方法。
对字符串做加密,分两种:一种是敏感字符串(网络接口地址、密钥、固定文案)运行时解密;另一种是全部字符串加密,但这会影响启动性能,需要谨慎。
实操中,字符串加密我通常只针对黑名单里的敏感信息做处理,不搞全量加密。全量加密听着安全,其实容易出现富文本显示异常、本地化失效、通知文案乱码等问题。
// 伪代码:字符串加密思路
// 在编译前将字符串替换为加密后的字节数组,并在运行时解密
static NSString * decryptString(uint8_t *data, int len, uint8_t key) {
    NSMutableData *out = [NSMutableData dataWithCapacity:len];
    for (int i = 0; i < len; i++) {
        uint8_t b = data[i] ^ key;
        [out appendBytes:&b length:1];
    }
    return [[NSString alloc] initWithData:out encoding:NSUTF8StringEncoding];
}
编译阶段处理完后,先正常出包一次,确认 App 能跑起来,再做后续的提审前处理。
3.3 提审前对 IPA 做资源与元数据改造
这一步我按固定的顺序执行,顺序很重要,因为每一步处理都依赖前一步的结果:
解压 IPA,获取 Payload 目录。
使用工具遍历资源,对图片做轻微压缩或加噪。
重命名部分资源文件和目录名。
修改 Info.plist 中的权限文案、技术支持页面、隐私链接。
对二进制做可选的额外符号处理。
重新签名。
重打包,使用本地模拟器或真机验证安装。
使用 class-dump 抽查,确认类名方法名已经改变。
上传前再跑一次启动测试,确认没有白屏和崩溃。
完整命令链路没必要硬背,关键是理解每一步的目的。比如图片重压缩,可以用 sips 脚本对 PNG 做轻微采样。注意:不要对启动图、App 图标做过度压缩,会直接影响审核观感。图标清晰度是有隐形要求的,模糊图标容易引来其他审核问题。
3.4 重新签名与验证安装
修改过 IPA 后,签名信息必然失效,必须重新签名。流程如下:
准备好 Distribution 证书和描述文件。
使用签名工具选择对应证书,对 Payload 里的 .app 进行签名。
将 .app 压缩为新的 IPA。
签名完成不代表万事大吉,还需要验证:
在 iOS 真机上通过本地安装方式,确认 App 可以打开。
检查签名:在终端执行 codesign -d,查看签名信息是否正确。
查看 Permission 是否完整,尤其是推送、位置、相机、麦克风等 entitlement 文件。
很多新手在这一步容易犯的错是:只改了二进制,没处理 entitlements,导致推送功能在审核设备上失效,或者启动直接闪退。这属于操作失误,而不是策略问题。
3.5 上传审核与等待反馈
上传前,App Store Connect 里还需要做好元数据层面的配合:
App 名称不要与大厂或热门产品过度相似。
截图要反映 App 真实的界面,不要拿模板警示图。
审核备注可以简单说明产品用途和核心功能。
上传完成后,等待审核。期间不要反复提交相同包。如果发现同一个 Bundle ID 在短时间内重复上传相同内容的包,苹果的后台系统会有记录,反而增加 4.3a 嫌疑。
4. 常见问题与排查技巧实录
4.1 加固后启动闪退
这类问题出现频率最高。常见原因有:
字符串解密时机不对,在类初始化前就引用了解密后的字符串。
符号混淆后,KVC、KVO、NSCoding 等动态调用没有正确适配(因为运行时找不到对应的方法名)。
第三方 SDK 内部使用了硬编码的类名,混淆后引发崩溃。
重签名时证书与描述文件不匹配。
排查工具我推荐使用 Xcode 的崩溃日志和 Device Log。先查看崩溃堆栈,再逐步确认是哪个环节引起的。如果堆栈指向某个知名 SDK 内部,那就说明混淆规则需要排除该 SDK 的类名。
4.2 加固后功能正常但审核仍然 4.3a
这个情况最让人挫败,但原因往往不在二进制:
你的产品在功能设计层面与已上架产品依然高度重合。
图标、截图、宣传文案和现有产品过于相似。
使用的第三方 SDK 布局相似,审核人员一眼就能看出同源。
遇到这种反馈,不要急着继续加固。先把审核返回的截图和描述反复看几遍,通常在邮件或 App Store Connect 的 Resolution Center 里会有更细的说明。如果对方说“界面与某 App 相似”,那就先把界面差异化做够再说。
调整完后,如果仍然 4.3a,可以提交申诉(App Review 申诉),在申诉里解释你的产品和其他产品的核心区别。申诉话术要言简意赅,不要长篇大论,重点写清楚“产品定位、核心功能、目标用户”三个点。
4.3 加固后上架成功,但后续更新又被 4.3a
有不少团队会碰到“第一版过了,第二版 4.3a”的情况。两个原因比较常见:
后续版本中引入了与市面上热门 App 相同的功能模块,且界面照搬。
加固方案没有延续,开发者后续直接用普通包提交,导致二进制指纹前后出现差异。
这里需要说明:苹果的审核,本质上是一种综合判断。你第一版通过,并不意味着你的马甲方案获得了永久认可。每次提审都相当于一次新的身份核查。所以,如果你做了加固,务必在每个后续版本中延续相同的加固规则和随机种子,否则前后指纹不一致,反而会让审核系统觉得这个产品存在问题。
4.4 常见问题速查表
| 现象 | 可能原因 |
|---|
解决方案
| | 启动闪退 | 字符串解密时机问题 |
|---|
将解密提前到最早入口,或改为懒加载
| | 启动闪退 | 混淆后 KVC/KVO 失效 |
|---|
添加排除名单,保留动态调用所需方法
| | 功能模块缺失 | 资源重命名后引用错误 |
|---|
重新检查资源加载路径,运行时验证
| | 推送失效 | entitlements 丢失 |
|---|
重签名时保留原始 entitlement 文件
| | 审核仍然 4.3a | 产品界面和竞品过于相似 |
|---|
优先调整界面、拍摄截图、说明差异
| | 上传后 1-2 个小时被拒 | 元数据或图标异常 |
|---|
检查图标尺寸、关键字和截图
|
4.5 一些需要留意的坑
关于方法名混淆,最常见的问题是把系统回调方法也混淆掉,比如 viewWillAppear、didReceiveMemoryWarning。它们必须保持原样,否则 UIKit 找不到回调。所以混淆规则的排除名单一定要包含所有系统 API 和需要动态绑定的方法。
关于第三方 SDK,我建议在混淆配置里直接排除所有 pod 目录或 framework 目录里的类,只处理你自己的代码。这样做虽然加固范围变小,但稳定性大大提高。毕竟审核判定相似性,看的不是你 SDK 部分的代码逻辑,而是你 App 整体结构、资源、元数据的组合特征。
关于网络请求域名,如果你的 App 内部请求了和母包一致的域名和路径,那二进制再怎么改,网络层面的指纹还是暴露的。建议对新包使用独立的 API 域名,或者至少使用不同的路径前缀和参数结构。
5. 避坑经验与长期策略
5.1 不要只看“技术加固”,要配合产品差异
我见过太多团队,拿着同一套产品代码,改个配色、换几张图、跑一遍加固脚本就重新提审。结果第二天被拒,回复几乎一模一样。根本原因就是产品层差异等于零。苹果的审核团队每天看大量 App,一个 App 是真原创还是套壳,其实在对话截图和功能操作里很容易判断出来。
所以我的建议是:产品层至少要有 20% 以上的功能差异化。可以体现在交互流程、信息架构、核心卖点上,也可以体现在落地页内容里。不求完全创新,但要让审核人员和真实用户都能一眼看出,你和那个“相似产品”不是同一个东西。
5.2 建立自己的加固标准流程
与其每次被拒后临时处理,不如在项目启动时就把加固流程标准化。我把这个流程固定成三份文档:
代码规范文档:规定哪些类名、方法名需要开启混淆,哪些必须保留。
提审操作手册:从编译、加固、签名、上传到填写元数据,每一步的命令和工具都写清楚。
版本更新记录:记录每次提审用的加固随机种子、工具版本、资源处理参数。
持续维护这套流程,看起来费功夫,但长期下来能节省大量与审核来回拉扯的时间。特别是当你维护多个产品和多个开发者账号时,标准流程能避免操作遗漏。
5.3 关于账号隔离和关联风险
如果涉及多产品矩阵,最好让每个产品的 Bundle ID、证书、开发者账号归属保持独立,不要混用。苹果的账号关联判定一直是敏感点。多个 App 共用一个开发者账号、共用相同的隐私政策页面链接、共用同一批测试设备,这些都可能被认为是关联信号。做这些处理时,想清楚每一个关联点再做,不要盲目堆量。
这里说的关联风险不是让你去违规搞小动作,而是提醒你:如果确实是在经营多款独立产品,尽量让它们在技术和运营层面呈现出真实的独立性。这才是合法合规、可持续的做法。
5.4 后续版本如何防止复发
维护阶段最容易松懈。后续版本更新时,经常会有人直接在工程里改两行代码就提审,忘了跑加固流程。我的做法是:把加固脚本挂到持续集成(CI)流程中,每次打 release 包时自动执行。
CI 里至少包含这几步:
拉取代码,按版本号生成随机种子。
执行符号混淆和字符串加密。
修改资源与元数据。
自动重签名。
跑一次最小启动测试。
上传到内部服务器,或直接上传 App Store Connect。
把加固做成自动化流程的一部分,就不必依赖某位同学靠不靠谱了。机器执行永远不会忘记跑脚本。
6. 写在最后的实操心得
做 iOS 4.3a 二进制加固这件事,本质是一个“风险控制”话题。你要控制的是产品被判重、被判低质的风险。技术手段能让你的包在机器眼里的身份画像发生明显变化,但真正能让产品走远的,还是产品的独特性和用户价值。如果你只是单纯想靠加固蒙混过关,这条路大概率走不长。
我个人的体会是:每次被 4.3a 拒一次,其实都是一次重新审视产品的机会。先看产品层有哪些差异,再看技术层有没有做到位,最后才去考虑是不是审核有误、需要申诉。按照这个顺序排查,大多数问题都能落地解决。
最后分享一个小技巧:提审前用一台备用 iPhone,在 App Store 里搜几个同领域的 Top 级 App,把你的包和它们分别安装到两台手机上,并排截图对比。自己的 App 如果和竞品在功能主页上放着一看就神似,那就别急着提审,先改界面。这个习惯我坚持了很久,帮我避开了很多无效提审。
如果你正在被 4.3a 重复折磨,建议把这篇文章里的四个层面逐一对照检查。不要指望哪一步能单独救命,组合起来才能形成一个真正有效的提审方案。
收起阅读 »
用Codex CLI构建苹果库存监控:从库存JSON接口抓包到异步轮询与通知的实战避坑
iPhone新品首发那段时间,我相信很多人都经历过一种焦虑:页面刷了又刷,购物车加了又加,结果一到结算就是“已售完”。更气人的是,过半小时再点进去,某个门店又冒出两台现货,等你切过去早就没了。这种“明明有货,却总是错过”的感觉,才是抢购真正的痛点。
后来我干脆想,与其靠人肉刷新,不如让程序盯着苹果产品的库存接口。但这个想法刚冒出来,又被自己劝退了:写爬虫、解析 JSON、处理异步请求、接通知服务,这套流程一个人从零开始搞,怎么也得一个周末。那几天我正好在试 OpenAI 的 Codex,一个能在终端里自主写代码、跑命令、看报错、自己改代码的 AI 编程 Agent。我突发奇想:这种“目标明确、逻辑相对独立”的小工具,不正是让 AI 来做最好的场景吗?于是就有了这个项目:用 Codex 做一个苹果库存监控工具。
这篇文章我不打算写成教程式的说明书,而是想认真聊聊整个过程中最值得记录的几件事:为什么我会选 Codex 而不是自己手写,监控工具的架构是怎么一步步被 AI 搭起来的,以及在实战里踩过的那些坑。无论你是对 AI 编程感兴趣,还是想用技术解决“抢不到货”这种小烦恼,这篇文章应该都能给你一些启发。

1. 需求拆解:为什么“抢不到”本质上是个信息差问题
1.1 库存不是一次性放出的,而是动态流动的
很多人以为 iPhone 新品开售是“一次性放出全部库存”,实际上并不是这样。苹果线上商店的库存,尤其是热门型号和颜色,经常会以非常不规律的方式分批释放。可能是有人取消订单后回流,可能是某个仓库临时调配,也可能是区域配送计划的间隙。这些库存往往只存在几分钟,甚至几十秒。
这就是信息差:你看到的“无货”,只是某个瞬间的无货,并不代表接下来五分钟不会补货。而人工刷新页面的频率,再快也就是几分钟一次,中间的大量窗口期全部浪费掉了。所以库存监控工具的核心价值,不是“抢”,而是“第一时间感知变化”。它用程序替你把“盯着页面”这个动作做到极致,一旦检测到状态变化就立刻提醒你。
1.2 监控工具的三个基本职责
一个合格的库存监控工具,至少要做三件事:
轮询
:定期去请求苹果产品的库存接口,获取某个产品编码在附近门店的实时库存状态。
判断
:把当前结果与上一次结果做对比,只有在状态发生变化时才触发后续动作,避免重复通知。
通知
:通过手机推送、即时通讯机器人等渠道,把“某门店出现现货”这个消息以最快速度送到你手上。
听起来不复杂,但真正落地时你会发现,这三件事分别对应了网络请求、状态管理和异常处理,每一项都有不少细节。比如轮询频率太高会被风控,判断逻辑不严谨会漏报或误报,通知服务没配好会导致消息延迟。这些细节,正是 AI 辅助编程最容易“翻车”的地方,也是后面 Codex 让我惊喜又头疼的原因。
2. 为什么选 Codex?AI Agent 和传统补全工具完全是两个物种
2.1 Codex 到底是什么
Codex 是 OpenAI 推出的编程 Agent,准确说,它能直接在终端里“干活”。跟你在 IDE 里用 Copilot 补全代码不一样,Codex 不是等你敲几个字符再帮你接一句,而是你给它一个目标,它自己去读项目文件、写代码、执行命令、看运行结果、根据报错自动修复。整个过程是循环的:执行、观察、修正、再执行。
我用的是 Codex CLI,在终端里跑
codex
命令启动交互式会话。它可以在你指定的目录下自由操作文件系统,相当于一个能自己动手写代码的“实习生”。这件事的震撼感在于,你不再需要把每一行代码都想好,只需要把需求描述清楚,它就能把整个功能骨架搭起来。
2.2 Agent 式开发与传统 AI 编程的差别
传统 AI 编程工具,比如 IDE 里的代码补全,本质是“在你已经搭好的框架里填内容”。人还是主导者,你得自己规划模块、自己建文件、自己处理依赖关系。
Codex 这种 Agent 式工具则完全不同。它更像一个拥有“工程能力”的初级开发人员:你告诉它“帮我写一个异步轮询苹果库存接口的脚本”,它会自己决定用哪个库、建几个文件、怎么组织函数、怎么处理异常。你后期做的是“验收”和“纠偏”,而不是“零开始编码”。
这个差别对做小工具来说意义很大。库存监控这种项目,逻辑不算复杂,但要写的样板代码不少:异步客户端、重试机制、参数解析、通知封装……如果人手写,至少磨蹭半天。Codex 在一个小时之内就能把整套东西跑起来。我只需要在关键节点上检查它的思路,防止它跑偏。
2.3 选型思考:Python 还是 Node.js?
我一开始没指定语言,Codex 默认用了 Python,理由是生态成熟:
httpx
做异步请求、
apscheduler
做定时调度、
json
处理解析,都是现成方案。我认可这个选择,因为 Python 的工具链对“写监控脚本”这类任务是最省事的。就算你不熟悉 Python,读它的代码也相对容易理解。
不过这里有个很重要的原则:你可以让 AI 选技术栈,但你自己必须清楚验收标准。Codex 选了 Python,我就按 Python 项目的惯例去检查它;如果它选了 Node.js,我也会用 Node 的方式去验收。AI 可以决定“怎么做”,但“做成什么样才合格”,必须由人来定义。
3. 核心实现拆解:库存监控工具的完整技术链路
3.1 数据源:苹果产品的库存JSON接口
要监控库存,首先得知道数据从哪来。苹果产品的商品详情页并不是纯静态页面,当你进入“选购”流程、选择型号后,页面上会显示附近门店的取货可用性,这部分数据是通过异步请求加载的。浏览器开发者工具里能看到一个返回 JSON 的接口,里面包含每个店铺的库存状态、可用数量、取货时间等信息。
这个接口需要带几类参数:
产品编码,也就是你盯的那款 iPhone 的零件号,页面数据里能找到。
地域信息,通常是经纬度,用来计算附近门店。
请求头,至少要带正常的 User-Agent,否则很容易被识别成异常请求。
我没有在文章里直接贴具体接口地址,因为这类接口的细节会随着产品改版而变化。更重要的是思路:找数据接口、看返回结构、定位字段、封装请求。这个思路通用性极强,换任何网站都成立。
3.2 技术架构:异步并发 + 状态对比 + 多路通知
确认数据源之后,我给 Codex 描述的目标是:写一个 Python 脚本,每隔一段时间查询附近门店的库存,发现状态变化就发送通知。Codex 给出的结构大概是这样的:
config.py
:集中管理产品编码、门店列表、轮询间隔和通知方式。
fetcher.py
:负责请求库存接口,解析每个门店的库存状态。
compare.py
:保存上一次的查询结果,用于差异检测。
notifier.py
:封装通知渠道,包括微信机器人、Telegram、Server酱等。
main.py
:主循环,负责按时间间隔执行抓取、比较和通知。
这个分层很合理。我唯一调整的是把“对比”单独拎出来成一个模块。原因是状态变化检测是这整个工具的大脑:如果每次都无脑通知,手机一会儿就会被轰炸;如果变化检测逻辑写错了,该通知的时候又没反应。所以对比逻辑必须独立、清晰、可测试。
3.3 关键代码:核心轮询逻辑是怎么实现的
下面这段是 Codex 写的核心抓取逻辑简化版,我加了一些注释。要注意,接口地址和字段名我是按当时抓包的示例写的,上线前你需要以实际抓包结果为准。
import asyncio
import httpx
import random

STORE_LIST = [
    {"id": "R001", "name": "示例门店A", "lat": 31.2304, "lng": 121.4737},
    {"id": "R002", "name": "示例门店B", "lat": 39.9042, "lng": 116.4074},
]

async def fetch_store_availability(client, store, product_code):
    """查询单个门店的库存状态"""
    params = {
        "product": product_code,
        "location": f"{store['lat']},{store['lng']}",
    }
    headers = {
        "User-Agent": "Mozilla/5.0 (iPhone; CPU iPhone OS 17_0 like Mac OS X)",
        "Accept": "application/json",
    }
    try:
        resp = await client.get(
            "[地址已省略]",
            params=params,
            headers=headers,
            timeout=10,
        )
        resp.raise_for_status()
        data = resp.json()
        # 实际字段需根据接口结构调整
        return data["store"]["availability"]
    except Exception as e:
        return {"error": str(e)}

async def main():
    async with httpx.AsyncClient() as client:
        # 使用信号量限制并发,比如同一时间最多发 3 个请求
        sem = asyncio.Semaphore(3)
        async def guarded(store):
            async with sem:
                return store["id"], await fetch_store_availability(client, store, PRODUCT_CODE)
        results = await asyncio.gather(*(guarded(s) for s in STORE_LIST))
        for store_id, availability in results:
            print(store_id, availability)

if __name__ == "__main__":
    asyncio.run(main())
这段代码的关键点是用了
Semaphore(3)
。这是我特意让 Codex 加的,因为如果不限制并发量,几十家门店同时发请求,很快就会被服务器拒之门外。
3.4 轮询策略与风控意识
监控工具本质上是一个自动化请求程序,所以必须对目标服务器保持基本的尊重。我的策略是:
把轮询间隔设置为 15 到 30 秒随机化,避免像定时炸弹一样在同一秒发出请求。
每次请求之间引入 0.5 到 2 秒的随机延迟,打散请求节奏。
单轮查询完所有门店后必须休息一轮,不做持续高频请求。
失败时采用指数退避重试,比如首次等待 2 秒、第二次 4 秒、第三次 8 秒,最多重试 3 次。
注意:任何网站的接口都不是给你无限刷的。监控工具的价值在于“知道何时有货”,而不是“把服务器干趴下”。保持低频、随机、克制,是对自己账号安全也是对服务商基本的尊重。
这个部分是整个项目里最需要你坚守原则的地方。AI 不会主动告诉你“你这个频率太高了”,但它写出来的代码会默默把你推向风险边缘。作为项目负责人,把握节奏的必须是你。
4. 实操过程:我是怎么用 Codex 一步步把工具搭起来的
4.1 第一次对话的关键提示词
用 Codex 写项目,最重要的不是它的能力,而是你“怎么描述需求”。我第一次给的提示词就踩了坑,只写了一句“帮我写个苹果库存监控”,结果是代码跑倒是能跑,但什么都没监控到——因为我不知道具体产品编码,也没告诉它怎么获取数据源。
后来我重构了提示词,把目标拆成了几层:
我要做一个苹果官网库存监控工具。

目标:
1. 根据我提供的产品编码,查询附近门店的可用库存。
2. 每 20 秒轮询一次,如果某个门店的库存状态发生变化,就发送通知。
3. 通知方式先接企业微信机器人,后续再加 Telegram。

已知信息:
- 我在 config.py 里提供一个 STORE_LIST,包含门店 id、名称、经纬度。
- 库存接口可以抓包获取,先按这种 URL 格式写:`[地址已省略]。
- 返回的 JSON 结构我待会儿会贴给你。

请在项目目录里初始化 Python 项目,并保证代码可直接运行。
这个提示词的关键在于:我给了 Codex 明确的“验收标准”和“已知条件”,而不是让它在真空中猜测。它对业务的理解完全来自我的话,我给得越具体,它做出来的东西就越贴近真实需求。
4.2 Codex 的完整工作流程实录
Codex 的交互方式很像在终端里“远程指挥”一名工程师。我观察下来,它会自己执行这么几步:
扫描当前目录,确认有没有现成的项目结构。
创建虚拟环境和依赖文件,安装
httpx
、
apscheduler
等库。
按我描述的目标分模块写代码,先写核心抓取,再写通知。
运行测试脚本,观察输出。
遇到报错时,自己读 traceback,定位问题,修改代码,重新运行。
让我比较惊艳的一个场景是:第一版代码跑起来后,出现了
json.decoder.JSONDecodeError
,原因是我给的接口地址是示意性的,返回的是 HTML 而不是 JSON。Codex 没有干等,它自己去分析响应内容,尝试从 HTML 里找到库存字段,然后调整了解析逻辑。这种“发现问题—分析原因—自动修复”的闭环,是传统 AI 补全工具完全做不到的。
当然,它也有让我无语的时候。比如它会把我的示意接口地址当成真实地址,努力尝试“修正”它。这时候我就得提醒它:接口地址我是占位的,真实地址需要抓包拿到,你先别在这个上面死磕。这里也体现了人类的必要性:AI 缺乏外部世界的真实信息,需要你给它提供“现实数据”。
4.3 人工验收:AI 写的代码不能直接信任
Codex 写完全部代码后,我做了一次系统的验收,主要查几个点:
请求频率是否合理
:看主循环里有没有写死的短间隔,有没有随机延迟。
异常处理是否健壮
:网络请求失败时会不会导致整个程序崩溃。
通知内容是否清晰
:推送消息有没有包含门店名、产品名、当前状态。
对比逻辑是否准确
:状态变化时,是“有货 => 无货”和“无货 => 有货”都能触发,还是只触发其中一种。
我检查后发现 Codex 的一个典型问题:它把“有货”判定写成了一个固定布尔值,但真实接口返回的状态字段可能是“available today”“unavailable”之类的字符串,甚至包含数量。这种“AI 对字段理解的偏差”如果不在验收阶段发现,上线后就会变成漏报。
我给它补充了字段样例后,它很快调整了判断逻辑。这个过程中我的角色是“测试工程师”,而非“编码工程师”。这也说明了一个趋势:AI 编程时代,人的核心能力正从“怎么写代码”转向“怎么定义好问题,以及怎么验收答案”。
5. 实战避坑:测试和上线过程中踩过的那些坑
5.1 代码没问题,但接口被风控了
第一版工具上线后,我美滋滋地等着通知。结果跑了不到 20 分钟,发现所有请求都返回空数据,像是被“静静屏蔽”了。排查了半天,不是代码逻辑问题,而是请求频率太高,触发了服务端的风控。
解决办法是调整策略:把轮询间隔从 10 秒拉到 30 秒,并且每次请求都带上短暂的随机延迟。另外我给每个请求加上了更完整的请求头,包括
Accept-Language
和
Referer
,让请求看起来更像从浏览器页面发起的。调完之后,跑了整整一天,再没出现过被屏蔽的情况。
这个坑给我最大的教训是:
监控工具真正的敌人不是“接口不存在”,而是“你的请求姿势不正确”。
如果每次访问都像一个无感情的刷量机器人,服务商当然会给你上“冷静期”。
5.2 Codex 终端工具的经典报错:“local proxy failed while handling codex endpoint”
用 Codex CLI 的过程中,最常见的报错之一就是类似
cc switch local proxy failed while handling codex endpoint /responses.
这样的信息。它的大意是:Codex 在调用本地后端服务时,网络代理这一环出了问题,导致请求没能送到 Codex 的接口服务上。
我遇到这个问题的场景很典型:频繁切换网络环境后,Codex 突然开始报错,代码写一半根本没法继续。解决思路如下:
先检查本地代理配置是否和当前网络环境匹配。很多开发者会配置本地 HTTP 代理工具来调试接口,如果代理规则没更新,所有请求都可能被卡住。
清理 Codex 的配置缓存,重新登录确认会话状态。
升级 Codex CLI 到最新版本,新版本对网络异常的容错通常更好。
这个报错本身不是代码问题,而是运行环境问题。我的习惯是遇到这类网络层问题,先不急着改代码,而是理清调试工具、系统代理、应用配置这三层关系,再逐层排查。
5.3 模型不支持的报错:“model is not supported”
有一次我更新 Codex 后,运行时报了类似
the 'gpt-5.6-sol' model is not supported when using codex
的错误。原因是我的配置文件中指定了一个当前版本 CLI 不支持的模型名,或者本地版本太旧,不认识新模型。
解决方式很简单:检查
config.toml
里的
model
配置,改成你当前可用、受支持的模型名;或者升级 CLI 版本,让配置项和实际运行环境匹配。这类问题都需要你先冷静看一下报错信息里的关键词,“not supported”指向的就是配置和版本不匹配。
5.4 配置文件告警:“unrecognized configuration setting”
Codex 对配置文件的解析是很严格的。有一次我在配置文件里加了一行自定义参数,结果启动时给了个警告:
codex is ignoring 1 unrecognized configuration setting. Check for typos or deprecated keys.
翻译过来就是“有个配置项我没认出来,我给忽略了”。
这类问题一定要重视。配置被忽略,意味着某些行为不会按你预期工作。可能你自以为设置了某个开关,实际却用的是默认值。解决办法是逐个检查配置项,删除已经废弃的键,或者查文档确认最新写法。
5.5 通知渠道对比与选型
监控工具最后一步是把结果送到你手上,通知渠道的选择也很重要。我实际用过三类:
| 渠道 | 优点 |
|---|
缺点
|
适合场景
| | Server酱 | 配置简单,微信公众号推送 |
|---|
需要申请 Key,依赖第三方平台
|
个人自用,快速上手
| | 企业微信机器人 | 推送速度快,可以发普通文本和 Markdown |
|---|
需要创建企业微信群
|
手头有现成群,通知比较稳定
| | Telegram Bot | 全球可达,API 开放,机器人配置简单 |
|---|
部分网络环境下访问不稳定
|
已有 Telegram 使用习惯的用户
|
我最后选的是企业微信机器人 + Server酱双路通知。原因是可靠性优先:万一其中一个通道服务波动,另一个还能兜底。通知消息里我会带上门店名称、具体型号、库存状态和查看链接,减少收到通知后还要自己去产品反复确认的时间。
6. 常见问题与排查技巧实录
用 AI 做项目,最磨人的其实不是 AI 本身,而是它出错时你怎么定位。我整理了一份自己真实的排查记录,按“症状—原因—处理”的格式放在下面,方便你对照。
| 症状 | 可能原因 |
|---|
处理方式
| | 程序运行后没有拿到任何数据 | 接口地址是占位符,或者返回结构解析失败 |
|---|
打开浏览器开发者工具,重新抓包确认真实接口和字段
| | 请求返回 429 或空数据 | 请求频率太高触发风控 |
|---|
调大轮询间隔,加随机延迟,补全请求头
| | 有货时不通知,无货时乱通知 | 对比逻辑只判断了单一方向的状态 |
|---|
检查 compare 模块,确保“从无到有”和“从有到无”都触发
| | 推送偶尔延迟超过 5 分钟 | 通知服务本身不稳定,或者网络链路有问题 |
|---|
配置双路通知,用备用通道兜底
| | Codex 半天不动,像是在“死循环” | 任务目标不清晰,或它在一个分支里绕不出来 |
|---|
中断会话,重新描述需求,给出现有的代码文件和明确的下一步
| | 代码能跑,但换一个产品编码就失效 | 硬编码了产品编码或门店信息 |
|---|
把可变参数全部抽到 config.py,代码里禁止出现业务常量
| | 程序崩溃后没有自动恢复 | 缺少异常捕获和重启机制 |
|---|
给主循环加 try/except,配合 systemd 或 supervisor 常驻运行
|
这里我想特别强调“硬编码”这个问题。Codex 第一版写出来的东西特别倾向于把产品编码、门店列表直接写在函数参数里,看起来方便,但换一个型号就要改代码。我后来专门花了一轮会话让它把配置全部外置,过程和结果都清爽了很多。
还有一个容易被忽视的细节:监控工具跑的时间长了,会产生大量日志。如果不做日志轮换,磁盘很快会被撑满。我给 Codex 加了一个按天滚动写入日志文件的需求,它写得很干净,这样即使工具连续跑几个月,也不会把机器拖垮。
7. 扩展思路:这个项目还能玩出什么花
等库存监控跑稳定之后,你会发现整个架构可以迁移到各种“信息差”场景。核心模式都是一样的:
低频轮询公共接口 + 状态变化检测 + 即时通知
。比如:
监控某个购物网站的商品降价,把“库存状态”替换成“价格字段”,对比逻辑从“是否有货”改成“价格是否低于阈值”。
监控场馆票务平台的余票,逻辑几乎一模一样。
监控某个查询接口返回的特定关键字,比如新版本固件发布公告。
更有意思的是,你可以让多个 AI Agent 参与这个项目,一个负责写代码,一个负责审查代码,一个负责写测试用例。多 AI 协作的意义在于互相当“质检员”,能够显著降低单个模型产生的盲区。我在这个项目的后期测试脚本就是让另一个 AI 会话帮忙写的,它确实找出了一些边界问题。
这个经验也再次说明了一件事:在 AI 编程时代,你的工作重心会从“亲手写每一行代码”迁移到“设计系统、定义验收标准、整合多个 AI 的产出”。这就像一个制片人,不再需要自己扛摄影机,但必须知道每个镜头要拍什么,以及怎么判断拍得好不好。
我个人的体会是,Codex 这类工具最大的价值不是“帮你省时间”,而是“帮你找回做小项目的主动权”。以前很多念头因为“工程量太大”而被搁置,现在只需要把目标描述清楚,AI 就能在半小时内把骨架搭起来。你依然需要理解代码逻辑、理解业务边界、理解风控规则,但这种“理解”的成本,已经比“从零手写”低太多了。
如果你手头也有一个“要是能自动盯着就好”的小需求,我建议你直接打开 Codex,用这篇文章里的提示词结构试一试。第一次跑通之后你会感受到,真正困难的从来不是写代码,而是想清楚你到底想要什么。
iPhone新品首发那段时间,我相信很多人都经历过一种焦虑:页面刷了又刷,购物车加了又加,结果一到结算就是“已售完”。更气人的是,过半小时再点进去,某个门店又冒出两台现货,等你切过去早就没了。这种“明明有货,却总是错过”的感觉,才是抢购真正的痛点。
后来我干脆想,与其靠人肉刷新,不如让程序盯着苹果产品的库存接口。但这个想法刚冒出来,又被自己劝退了:写爬虫、解析 JSON、处理异步请求、接通知服务,这套流程一个人从零开始搞,怎么也得一个周末。那几天我正好在试 OpenAI 的 Codex,一个能在终端里自主写代码、跑命令、看报错、自己改代码的 AI 编程 Agent。我突发奇想:这种“目标明确、逻辑相对独立”的小工具,不正是让 AI 来做最好的场景吗?于是就有了这个项目:用 Codex 做一个苹果库存监控工具。
这篇文章我不打算写成教程式的说明书,而是想认真聊聊整个过程中最值得记录的几件事:为什么我会选 Codex 而不是自己手写,监控工具的架构是怎么一步步被 AI 搭起来的,以及在实战里踩过的那些坑。无论你是对 AI 编程感兴趣,还是想用技术解决“抢不到货”这种小烦恼,这篇文章应该都能给你一些启发。
1. 需求拆解:为什么“抢不到”本质上是个信息差问题
1.1 库存不是一次性放出的,而是动态流动的
很多人以为 iPhone 新品开售是“一次性放出全部库存”,实际上并不是这样。苹果线上商店的库存,尤其是热门型号和颜色,经常会以非常不规律的方式分批释放。可能是有人取消订单后回流,可能是某个仓库临时调配,也可能是区域配送计划的间隙。这些库存往往只存在几分钟,甚至几十秒。
这就是信息差:你看到的“无货”,只是某个瞬间的无货,并不代表接下来五分钟不会补货。而人工刷新页面的频率,再快也就是几分钟一次,中间的大量窗口期全部浪费掉了。所以库存监控工具的核心价值,不是“抢”,而是“第一时间感知变化”。它用程序替你把“盯着页面”这个动作做到极致,一旦检测到状态变化就立刻提醒你。
1.2 监控工具的三个基本职责
一个合格的库存监控工具,至少要做三件事:
轮询
:定期去请求苹果产品的库存接口,获取某个产品编码在附近门店的实时库存状态。
判断
:把当前结果与上一次结果做对比,只有在状态发生变化时才触发后续动作,避免重复通知。
通知
:通过手机推送、即时通讯机器人等渠道,把“某门店出现现货”这个消息以最快速度送到你手上。
听起来不复杂,但真正落地时你会发现,这三件事分别对应了网络请求、状态管理和异常处理,每一项都有不少细节。比如轮询频率太高会被风控,判断逻辑不严谨会漏报或误报,通知服务没配好会导致消息延迟。这些细节,正是 AI 辅助编程最容易“翻车”的地方,也是后面 Codex 让我惊喜又头疼的原因。
2. 为什么选 Codex?AI Agent 和传统补全工具完全是两个物种
2.1 Codex 到底是什么
Codex 是 OpenAI 推出的编程 Agent,准确说,它能直接在终端里“干活”。跟你在 IDE 里用 Copilot 补全代码不一样,Codex 不是等你敲几个字符再帮你接一句,而是你给它一个目标,它自己去读项目文件、写代码、执行命令、看运行结果、根据报错自动修复。整个过程是循环的:执行、观察、修正、再执行。
我用的是 Codex CLI,在终端里跑
codex
命令启动交互式会话。它可以在你指定的目录下自由操作文件系统,相当于一个能自己动手写代码的“实习生”。这件事的震撼感在于,你不再需要把每一行代码都想好,只需要把需求描述清楚,它就能把整个功能骨架搭起来。
2.2 Agent 式开发与传统 AI 编程的差别
传统 AI 编程工具,比如 IDE 里的代码补全,本质是“在你已经搭好的框架里填内容”。人还是主导者,你得自己规划模块、自己建文件、自己处理依赖关系。
Codex 这种 Agent 式工具则完全不同。它更像一个拥有“工程能力”的初级开发人员:你告诉它“帮我写一个异步轮询苹果库存接口的脚本”,它会自己决定用哪个库、建几个文件、怎么组织函数、怎么处理异常。你后期做的是“验收”和“纠偏”,而不是“零开始编码”。
这个差别对做小工具来说意义很大。库存监控这种项目,逻辑不算复杂,但要写的样板代码不少:异步客户端、重试机制、参数解析、通知封装……如果人手写,至少磨蹭半天。Codex 在一个小时之内就能把整套东西跑起来。我只需要在关键节点上检查它的思路,防止它跑偏。
2.3 选型思考:Python 还是 Node.js?
我一开始没指定语言,Codex 默认用了 Python,理由是生态成熟:
httpx
做异步请求、
apscheduler
做定时调度、
json
处理解析,都是现成方案。我认可这个选择,因为 Python 的工具链对“写监控脚本”这类任务是最省事的。就算你不熟悉 Python,读它的代码也相对容易理解。
不过这里有个很重要的原则:你可以让 AI 选技术栈,但你自己必须清楚验收标准。Codex 选了 Python,我就按 Python 项目的惯例去检查它;如果它选了 Node.js,我也会用 Node 的方式去验收。AI 可以决定“怎么做”,但“做成什么样才合格”,必须由人来定义。
3. 核心实现拆解:库存监控工具的完整技术链路
3.1 数据源:苹果产品的库存JSON接口
要监控库存,首先得知道数据从哪来。苹果产品的商品详情页并不是纯静态页面,当你进入“选购”流程、选择型号后,页面上会显示附近门店的取货可用性,这部分数据是通过异步请求加载的。浏览器开发者工具里能看到一个返回 JSON 的接口,里面包含每个店铺的库存状态、可用数量、取货时间等信息。
这个接口需要带几类参数:
产品编码,也就是你盯的那款 iPhone 的零件号,页面数据里能找到。
地域信息,通常是经纬度,用来计算附近门店。
请求头,至少要带正常的 User-Agent,否则很容易被识别成异常请求。
我没有在文章里直接贴具体接口地址,因为这类接口的细节会随着产品改版而变化。更重要的是思路:找数据接口、看返回结构、定位字段、封装请求。这个思路通用性极强,换任何网站都成立。
3.2 技术架构:异步并发 + 状态对比 + 多路通知
确认数据源之后,我给 Codex 描述的目标是:写一个 Python 脚本,每隔一段时间查询附近门店的库存,发现状态变化就发送通知。Codex 给出的结构大概是这样的:
config.py
:集中管理产品编码、门店列表、轮询间隔和通知方式。
fetcher.py
:负责请求库存接口,解析每个门店的库存状态。
compare.py
:保存上一次的查询结果,用于差异检测。
notifier.py
:封装通知渠道,包括微信机器人、Telegram、Server酱等。
main.py
:主循环,负责按时间间隔执行抓取、比较和通知。
这个分层很合理。我唯一调整的是把“对比”单独拎出来成一个模块。原因是状态变化检测是这整个工具的大脑:如果每次都无脑通知,手机一会儿就会被轰炸;如果变化检测逻辑写错了,该通知的时候又没反应。所以对比逻辑必须独立、清晰、可测试。
3.3 关键代码:核心轮询逻辑是怎么实现的
下面这段是 Codex 写的核心抓取逻辑简化版,我加了一些注释。要注意,接口地址和字段名我是按当时抓包的示例写的,上线前你需要以实际抓包结果为准。
import asyncio
import httpx
import random

STORE_LIST = [
    {"id": "R001", "name": "示例门店A", "lat": 31.2304, "lng": 121.4737},
    {"id": "R002", "name": "示例门店B", "lat": 39.9042, "lng": 116.4074},
]

async def fetch_store_availability(client, store, product_code):
    """查询单个门店的库存状态"""
    params = {
        "product": product_code,
        "location": f"{store['lat']},{store['lng']}",
    }
    headers = {
        "User-Agent": "Mozilla/5.0 (iPhone; CPU iPhone OS 17_0 like Mac OS X)",
        "Accept": "application/json",
    }
    try:
        resp = await client.get(
            "[地址已省略]",
            params=params,
            headers=headers,
            timeout=10,
        )
        resp.raise_for_status()
        data = resp.json()
        # 实际字段需根据接口结构调整
        return data["store"]["availability"]
    except Exception as e:
        return {"error": str(e)}

async def main():
    async with httpx.AsyncClient() as client:
        # 使用信号量限制并发,比如同一时间最多发 3 个请求
        sem = asyncio.Semaphore(3)
        async def guarded(store):
            async with sem:
                return store["id"], await fetch_store_availability(client, store, PRODUCT_CODE)
        results = await asyncio.gather(*(guarded(s) for s in STORE_LIST))
        for store_id, availability in results:
            print(store_id, availability)

if __name__ == "__main__":
    asyncio.run(main())
这段代码的关键点是用了
Semaphore(3)
。这是我特意让 Codex 加的,因为如果不限制并发量,几十家门店同时发请求,很快就会被服务器拒之门外。
3.4 轮询策略与风控意识
监控工具本质上是一个自动化请求程序,所以必须对目标服务器保持基本的尊重。我的策略是:
把轮询间隔设置为 15 到 30 秒随机化,避免像定时炸弹一样在同一秒发出请求。
每次请求之间引入 0.5 到 2 秒的随机延迟,打散请求节奏。
单轮查询完所有门店后必须休息一轮,不做持续高频请求。
失败时采用指数退避重试,比如首次等待 2 秒、第二次 4 秒、第三次 8 秒,最多重试 3 次。
注意:任何网站的接口都不是给你无限刷的。监控工具的价值在于“知道何时有货”,而不是“把服务器干趴下”。保持低频、随机、克制,是对自己账号安全也是对服务商基本的尊重。
这个部分是整个项目里最需要你坚守原则的地方。AI 不会主动告诉你“你这个频率太高了”,但它写出来的代码会默默把你推向风险边缘。作为项目负责人,把握节奏的必须是你。
4. 实操过程:我是怎么用 Codex 一步步把工具搭起来的
4.1 第一次对话的关键提示词
用 Codex 写项目,最重要的不是它的能力,而是你“怎么描述需求”。我第一次给的提示词就踩了坑,只写了一句“帮我写个苹果库存监控”,结果是代码跑倒是能跑,但什么都没监控到——因为我不知道具体产品编码,也没告诉它怎么获取数据源。
后来我重构了提示词,把目标拆成了几层:
我要做一个苹果官网库存监控工具。

目标:
1. 根据我提供的产品编码,查询附近门店的可用库存。
2. 每 20 秒轮询一次,如果某个门店的库存状态发生变化,就发送通知。
3. 通知方式先接企业微信机器人,后续再加 Telegram。

已知信息:
- 我在 config.py 里提供一个 STORE_LIST,包含门店 id、名称、经纬度。
- 库存接口可以抓包获取,先按这种 URL 格式写:`[地址已省略]。
- 返回的 JSON 结构我待会儿会贴给你。

请在项目目录里初始化 Python 项目,并保证代码可直接运行。
这个提示词的关键在于:我给了 Codex 明确的“验收标准”和“已知条件”,而不是让它在真空中猜测。它对业务的理解完全来自我的话,我给得越具体,它做出来的东西就越贴近真实需求。
4.2 Codex 的完整工作流程实录
Codex 的交互方式很像在终端里“远程指挥”一名工程师。我观察下来,它会自己执行这么几步:
扫描当前目录,确认有没有现成的项目结构。
创建虚拟环境和依赖文件,安装
httpx
、
apscheduler
等库。
按我描述的目标分模块写代码,先写核心抓取,再写通知。
运行测试脚本,观察输出。
遇到报错时,自己读 traceback,定位问题,修改代码,重新运行。
让我比较惊艳的一个场景是:第一版代码跑起来后,出现了
json.decoder.JSONDecodeError
,原因是我给的接口地址是示意性的,返回的是 HTML 而不是 JSON。Codex 没有干等,它自己去分析响应内容,尝试从 HTML 里找到库存字段,然后调整了解析逻辑。这种“发现问题—分析原因—自动修复”的闭环,是传统 AI 补全工具完全做不到的。
当然,它也有让我无语的时候。比如它会把我的示意接口地址当成真实地址,努力尝试“修正”它。这时候我就得提醒它:接口地址我是占位的,真实地址需要抓包拿到,你先别在这个上面死磕。这里也体现了人类的必要性:AI 缺乏外部世界的真实信息,需要你给它提供“现实数据”。
4.3 人工验收:AI 写的代码不能直接信任
Codex 写完全部代码后,我做了一次系统的验收,主要查几个点:
请求频率是否合理
:看主循环里有没有写死的短间隔,有没有随机延迟。
异常处理是否健壮
:网络请求失败时会不会导致整个程序崩溃。
通知内容是否清晰
:推送消息有没有包含门店名、产品名、当前状态。
对比逻辑是否准确
:状态变化时,是“有货 => 无货”和“无货 => 有货”都能触发,还是只触发其中一种。
我检查后发现 Codex 的一个典型问题:它把“有货”判定写成了一个固定布尔值,但真实接口返回的状态字段可能是“available today”“unavailable”之类的字符串,甚至包含数量。这种“AI 对字段理解的偏差”如果不在验收阶段发现,上线后就会变成漏报。
我给它补充了字段样例后,它很快调整了判断逻辑。这个过程中我的角色是“测试工程师”,而非“编码工程师”。这也说明了一个趋势:AI 编程时代,人的核心能力正从“怎么写代码”转向“怎么定义好问题,以及怎么验收答案”。
5. 实战避坑:测试和上线过程中踩过的那些坑
5.1 代码没问题,但接口被风控了
第一版工具上线后,我美滋滋地等着通知。结果跑了不到 20 分钟,发现所有请求都返回空数据,像是被“静静屏蔽”了。排查了半天,不是代码逻辑问题,而是请求频率太高,触发了服务端的风控。
解决办法是调整策略:把轮询间隔从 10 秒拉到 30 秒,并且每次请求都带上短暂的随机延迟。另外我给每个请求加上了更完整的请求头,包括
Accept-Language
和
Referer
,让请求看起来更像从浏览器页面发起的。调完之后,跑了整整一天,再没出现过被屏蔽的情况。
这个坑给我最大的教训是:
监控工具真正的敌人不是“接口不存在”,而是“你的请求姿势不正确”。
如果每次访问都像一个无感情的刷量机器人,服务商当然会给你上“冷静期”。
5.2 Codex 终端工具的经典报错:“local proxy failed while handling codex endpoint”
用 Codex CLI 的过程中,最常见的报错之一就是类似
cc switch local proxy failed while handling codex endpoint /responses.
这样的信息。它的大意是:Codex 在调用本地后端服务时,网络代理这一环出了问题,导致请求没能送到 Codex 的接口服务上。
我遇到这个问题的场景很典型:频繁切换网络环境后,Codex 突然开始报错,代码写一半根本没法继续。解决思路如下:
先检查本地代理配置是否和当前网络环境匹配。很多开发者会配置本地 HTTP 代理工具来调试接口,如果代理规则没更新,所有请求都可能被卡住。
清理 Codex 的配置缓存,重新登录确认会话状态。
升级 Codex CLI 到最新版本,新版本对网络异常的容错通常更好。
这个报错本身不是代码问题,而是运行环境问题。我的习惯是遇到这类网络层问题,先不急着改代码,而是理清调试工具、系统代理、应用配置这三层关系,再逐层排查。
5.3 模型不支持的报错:“model is not supported”
有一次我更新 Codex 后,运行时报了类似
the 'gpt-5.6-sol' model is not supported when using codex
的错误。原因是我的配置文件中指定了一个当前版本 CLI 不支持的模型名,或者本地版本太旧,不认识新模型。
解决方式很简单:检查
config.toml
里的
model
配置,改成你当前可用、受支持的模型名;或者升级 CLI 版本,让配置项和实际运行环境匹配。这类问题都需要你先冷静看一下报错信息里的关键词,“not supported”指向的就是配置和版本不匹配。
5.4 配置文件告警:“unrecognized configuration setting”
Codex 对配置文件的解析是很严格的。有一次我在配置文件里加了一行自定义参数,结果启动时给了个警告:
codex is ignoring 1 unrecognized configuration setting. Check for typos or deprecated keys.
翻译过来就是“有个配置项我没认出来,我给忽略了”。
这类问题一定要重视。配置被忽略,意味着某些行为不会按你预期工作。可能你自以为设置了某个开关,实际却用的是默认值。解决办法是逐个检查配置项,删除已经废弃的键,或者查文档确认最新写法。
5.5 通知渠道对比与选型
监控工具最后一步是把结果送到你手上,通知渠道的选择也很重要。我实际用过三类:
| 渠道 | 优点 |
|---|
缺点
|
适合场景
| | Server酱 | 配置简单,微信公众号推送 |
|---|
需要申请 Key,依赖第三方平台
|
个人自用,快速上手
| | 企业微信机器人 | 推送速度快,可以发普通文本和 Markdown |
|---|
需要创建企业微信群
|
手头有现成群,通知比较稳定
| | Telegram Bot | 全球可达,API 开放,机器人配置简单 |
|---|
部分网络环境下访问不稳定
|
已有 Telegram 使用习惯的用户
|
我最后选的是企业微信机器人 + Server酱双路通知。原因是可靠性优先:万一其中一个通道服务波动,另一个还能兜底。通知消息里我会带上门店名称、具体型号、库存状态和查看链接,减少收到通知后还要自己去产品反复确认的时间。
6. 常见问题与排查技巧实录
用 AI 做项目,最磨人的其实不是 AI 本身,而是它出错时你怎么定位。我整理了一份自己真实的排查记录,按“症状—原因—处理”的格式放在下面,方便你对照。
| 症状 | 可能原因 |
|---|
处理方式
| | 程序运行后没有拿到任何数据 | 接口地址是占位符,或者返回结构解析失败 |
|---|
打开浏览器开发者工具,重新抓包确认真实接口和字段
| | 请求返回 429 或空数据 | 请求频率太高触发风控 |
|---|
调大轮询间隔,加随机延迟,补全请求头
| | 有货时不通知,无货时乱通知 | 对比逻辑只判断了单一方向的状态 |
|---|
检查 compare 模块,确保“从无到有”和“从有到无”都触发
| | 推送偶尔延迟超过 5 分钟 | 通知服务本身不稳定,或者网络链路有问题 |
|---|
配置双路通知,用备用通道兜底
| | Codex 半天不动,像是在“死循环” | 任务目标不清晰,或它在一个分支里绕不出来 |
|---|
中断会话,重新描述需求,给出现有的代码文件和明确的下一步
| | 代码能跑,但换一个产品编码就失效 | 硬编码了产品编码或门店信息 |
|---|
把可变参数全部抽到 config.py,代码里禁止出现业务常量
| | 程序崩溃后没有自动恢复 | 缺少异常捕获和重启机制 |
|---|
给主循环加 try/except,配合 systemd 或 supervisor 常驻运行
|
这里我想特别强调“硬编码”这个问题。Codex 第一版写出来的东西特别倾向于把产品编码、门店列表直接写在函数参数里,看起来方便,但换一个型号就要改代码。我后来专门花了一轮会话让它把配置全部外置,过程和结果都清爽了很多。
还有一个容易被忽视的细节:监控工具跑的时间长了,会产生大量日志。如果不做日志轮换,磁盘很快会被撑满。我给 Codex 加了一个按天滚动写入日志文件的需求,它写得很干净,这样即使工具连续跑几个月,也不会把机器拖垮。
7. 扩展思路:这个项目还能玩出什么花
等库存监控跑稳定之后,你会发现整个架构可以迁移到各种“信息差”场景。核心模式都是一样的:
低频轮询公共接口 + 状态变化检测 + 即时通知
。比如:
监控某个购物网站的商品降价,把“库存状态”替换成“价格字段”,对比逻辑从“是否有货”改成“价格是否低于阈值”。
监控场馆票务平台的余票,逻辑几乎一模一样。
监控某个查询接口返回的特定关键字,比如新版本固件发布公告。
更有意思的是,你可以让多个 AI Agent 参与这个项目,一个负责写代码,一个负责审查代码,一个负责写测试用例。多 AI 协作的意义在于互相当“质检员”,能够显著降低单个模型产生的盲区。我在这个项目的后期测试脚本就是让另一个 AI 会话帮忙写的,它确实找出了一些边界问题。
这个经验也再次说明了一件事:在 AI 编程时代,你的工作重心会从“亲手写每一行代码”迁移到“设计系统、定义验收标准、整合多个 AI 的产出”。这就像一个制片人,不再需要自己扛摄影机,但必须知道每个镜头要拍什么,以及怎么判断拍得好不好。
我个人的体会是,Codex 这类工具最大的价值不是“帮你省时间”,而是“帮你找回做小项目的主动权”。以前很多念头因为“工程量太大”而被搁置,现在只需要把目标描述清楚,AI 就能在半小时内把骨架搭起来。你依然需要理解代码逻辑、理解业务边界、理解风控规则,但这种“理解”的成本,已经比“从零手写”低太多了。
如果你手头也有一个“要是能自动盯着就好”的小需求,我建议你直接打开 Codex,用这篇文章里的提示词结构试一试。第一次跑通之后你会感受到,真正困难的从来不是写代码,而是想清楚你到底想要什么。
收起阅读 »
App Store 4.3(a) Spam 被拒怎么整改:IPA 相似度检测与提审前复查教程
问题引入:为什么会被 4.3(a) 判定为 Spam
App Store 审核指南 4.3(a) 针对的是重复内容与垃圾应用。实务中,被拒的 App 往往并非功能一模一样,而是主可执行文件、Framework、资源文件、Assets.car、SDK 指纹、网络接口等维度与库中已有 App 高度重合。常见触发场景包括:同一套基础框架套壳多个项目、模板代码未做实质重构、资源与打包结构直接复用、控制流与数据流语义过于接近。
这类拒审的难点在于:肉眼很难判断“差多少算相似”。因此系统性整改的第一步不是改代码,而是先做可复核的相似度检测,再按维度逐项整改。
分步教程:从检测到整改
第一步:检测前固定基线
准备一个参考包(数据库中或自有已上架的相似包)和一个待检测包,记录版本号与构建号,确保后续改动可对照。检测过程应独立完成、不保留 IPA 文件、检测后自动删除,避免 IPA 或账号产生关联风险。
基线固定后,建议先跑一次未经整改的完整检测,作为“整改前分数”,否则后续无法判断改动是否真的起作用。
第二步:做多维度相似度检测
iOS 侧建议覆盖 12 个维度:主可执行文件、Framework、资源文件、Assets.car、元数据、SDK、控制流、数据流与语义线索、重复文件等。IPA 相似度检测工具从 Mach-O、资源、元数据、SDK 和重复文件等维度生成可复核的技术报告,辅助团队在提审前定位相似风险。
其中 SHA-256 精确匹配用于发现完全相同的文件;控制流、数据流与语义线索则用于发现“改写但结构相近”的情况。二者结合,才能覆盖表层与深层重复。报告应保留评分、表格与建议,作为整改依据,而不是只截一张总分图。
第三步:按报告排序整改
先处理精确匹配类问题:相同的图片、Assets、SO 库、字符串表应替换或重做。再处理结构性相似:类与方法命名、包结构、目录布局、网络接口与 SDK 指纹。最后处理逻辑相似:业务流程顺序、状态机、数据模型与关键算法,应结合真实需求做差异化设计,而不是仅改变量名。
整改后重新检测,确认各维度评分下降,并记录改动点,形成可复盘的过程说明。这份说明在申诉或后续提交时,比空口解释更有说服力。若某一维度分数始终偏高,优先排查是否有整段代码或整个资源目录被原样复用。
检查清单
- 是否已选定参考包与待检测包,并固定版本与构建号?
- 是否覆盖主可执行文件、Framework、资源、Assets.car、SDK、控制流、数据流、重复文件等维度?
- 是否处理了 SHA-256 完全相同的文件?
- 是否对 SDK 指纹、网络接口、证书信息做了差异化?
- 资源与目录结构是否仍与参考包高度一致?
- 整改后是否重新检测并留存报告?
- 检测过程是否不保留 IPA、不产生账号关联?
适用条件与边界
本流程适用于自研或委托开发、对代码与资源有实际控制权的团队。若 App 依赖第三方框架且无法修改,应先评估可替换空间;若涉及合规资质类内容(如赌博、金融等受限类目),相似度整改不能替代资质要求。相似度检测与整改是降低 4.3(a) 风险的手段,不构成审核通过的保证。
团队规模较大时,可把证书、Bundle ID、描述文件与上传任务集中管理,减少因资料混乱导致的重复提交问题。整个流程的核心是:先量化,再整改,再复核。

App Store审核被拒:个人开发者账号提交模拟赌博应用问题(2025-11-01)
问题引入:为什么会被 4.3(a) 判定为 Spam
App Store 审核指南 4.3(a) 针对的是重复内容与垃圾应用。实务中,被拒的 App 往往并非功能一模一样,而是主可执行文件、Framework、资源文件、Assets.car、SDK 指纹、网络接口等维度与库中已有 App 高度重合。常见触发场景包括:同一套基础框架套壳多个项目、模板代码未做实质重构、资源与打包结构直接复用、控制流与数据流语义过于接近。
这类拒审的难点在于:肉眼很难判断“差多少算相似”。因此系统性整改的第一步不是改代码,而是先做可复核的相似度检测,再按维度逐项整改。
分步教程:从检测到整改
第一步:检测前固定基线
准备一个参考包(数据库中或自有已上架的相似包)和一个待检测包,记录版本号与构建号,确保后续改动可对照。检测过程应独立完成、不保留 IPA 文件、检测后自动删除,避免 IPA 或账号产生关联风险。
基线固定后,建议先跑一次未经整改的完整检测,作为“整改前分数”,否则后续无法判断改动是否真的起作用。
第二步:做多维度相似度检测
iOS 侧建议覆盖 12 个维度:主可执行文件、Framework、资源文件、Assets.car、元数据、SDK、控制流、数据流与语义线索、重复文件等。IPA 相似度检测工具从 Mach-O、资源、元数据、SDK 和重复文件等维度生成可复核的技术报告,辅助团队在提审前定位相似风险。
其中 SHA-256 精确匹配用于发现完全相同的文件;控制流、数据流与语义线索则用于发现“改写但结构相近”的情况。二者结合,才能覆盖表层与深层重复。报告应保留评分、表格与建议,作为整改依据,而不是只截一张总分图。
第三步:按报告排序整改
先处理精确匹配类问题:相同的图片、Assets、SO 库、字符串表应替换或重做。再处理结构性相似:类与方法命名、包结构、目录布局、网络接口与 SDK 指纹。最后处理逻辑相似:业务流程顺序、状态机、数据模型与关键算法,应结合真实需求做差异化设计,而不是仅改变量名。
整改后重新检测,确认各维度评分下降,并记录改动点,形成可复盘的过程说明。这份说明在申诉或后续提交时,比空口解释更有说服力。若某一维度分数始终偏高,优先排查是否有整段代码或整个资源目录被原样复用。
检查清单
- 是否已选定参考包与待检测包,并固定版本与构建号?
- 是否覆盖主可执行文件、Framework、资源、Assets.car、SDK、控制流、数据流、重复文件等维度?
- 是否处理了 SHA-256 完全相同的文件?
- 是否对 SDK 指纹、网络接口、证书信息做了差异化?
- 资源与目录结构是否仍与参考包高度一致?
- 整改后是否重新检测并留存报告?
- 检测过程是否不保留 IPA、不产生账号关联?
适用条件与边界
本流程适用于自研或委托开发、对代码与资源有实际控制权的团队。若 App 依赖第三方框架且无法修改,应先评估可替换空间;若涉及合规资质类内容(如赌博、金融等受限类目),相似度整改不能替代资质要求。相似度检测与整改是降低 4.3(a) 风险的手段,不构成审核通过的保证。
团队规模较大时,可把证书、Bundle ID、描述文件与上传任务集中管理,减少因资料混乱导致的重复提交问题。整个流程的核心是:先量化,再整改,再复核。
App Store审核被拒:个人开发者账号提交模拟赌博应用问题(2025-11-01)
收起阅读 »
AI开发App全流程实战:从架构设计、接口契约到上架审核的完整指南
1. 从一句“帮我做个App”说起:AI开发App到底在开发什么
“如何用AI开发一款App”,这句话,我在过去一年里被问到的次数,比前五年加起来都多。问的人五花八门:有做网约车调度的小老板,有想给自家运动课程做个打卡工具的教练,有做专利辅助检索的代理人,也有单纯想验证一个点子值不值得投入的产品经理。大家嘴里的“AI开发App”,其实指向的是完全不同的三件事,如果不先把这三件事拆开,后面所有的工具选型、成本估算、上架流程都会跑偏。
第一件事,是
用AI当编程助手,人来主导开发
。你仍然是开发者,只是把写样板代码、查API文档、生成单元测试、解释报错这些活儿交给AI。这是目前最成熟、最可控的路径,也是我日常主力使用的方式。第二件事,是
用AI生成式平台,靠自然语言描述直接产出可运行的应用
。你描述需求,平台吐出前端页面、后端逻辑甚至数据库结构,适合快速验证想法。第三件事,是
把AI能力嵌进App本身
,比如做一个AI聊天女友、AI诵经助手、AI旅游规划、AI声音空间化处理,App只是载体,核心价值在模型调用和提示词工程上。
这三件事经常被混为一谈,导致很多人一上来就问“哪个平台能一键生成App”,结果做出来的东西既不能上架,也没法维护。我的建议是:先明确你要的是“AI帮我写代码”,还是“AI当App的功能”,这两个方向的工具链、成本结构、技术门槛完全不同。本文会以第一件事为主线,因为它是唯一能让你真正掌控产品、并且能走到上架和长期迭代的路径,同时在关键节点上把第二、第三件事的取舍讲清楚。
适合谁看?如果你有基本的编程概念(知道什么是前端、后端、数据库),想用AI把开发效率提升三到五倍,这篇可以直接抄作业。如果你完全不懂代码,只想快速做个原型给投资人看,我也会在第二节给出低代码加AI的替代方案。如果你是想把大模型能力接进现有App的开发者,第三节的架构拆解和第五节的踩坑记录对你会更有用。
先给一个我实测下来的整体判断:
AI能把一个App的开发周期从三个月压到三到四周,但压不掉的是需求梳理、数据设计、上架合规和真机调试这四块。
很多人以为AI能全包,结果卡在应用商店审核和支付回调上,白白浪费两周。所以下面的内容,我会把“AI能加速的部分”和“AI帮不上、必须人来的部分”分得很清楚。

2. 整体设计与思路拆解:先定架构,再谈AI
2.1 为什么我坚持“人定架构、AI填实现”
我见过太多人一上来就打开AI对话窗口,输入“帮我写一个网约车App”,然后拿到一堆看起来能跑、实际上没法扩展的代码。问题出在架构决策上。一个App的核心架构决策包括:前端用什么框架、后端是自建还是用BaaS、数据库选关系型还是文档型、状态管理怎么做、鉴权方案是什么、支付和推送接哪家。这些决策一旦定错,后面AI生成的代码越多,返工成本越高。
举个具体例子。假设你要做一个运动打卡App,用户每天上传运动记录,还要有排行榜。如果你让AI直接生成,它很可能给你一个前端直接调数据库的写法,因为这样代码最短。但排行榜需要聚合查询,前端直连数据库既暴露了密钥,又扛不住并发。正确的做法是后端提供一个聚合接口,前端只调接口。这个决策AI不会主动帮你做,因为它不知道你的用户量级和成本预算。
所以我的流程是:
先用半小时把架构图画在纸上,明确模块边界和接口契约,然后再让AI逐个模块生成实现。
架构图不需要多正式,几个方框加箭头就行,但它决定了后面AI生成的内容能不能拼在一起。这一步省不得,省了后面一定加倍还回来。
2.2 三种技术路线的取舍:原生、跨端、低代码
路线选择直接决定开发成本和上架难度。我把三条路线的关键指标列出来,你可以对照自己的情况选。
| 路线 | 代表方案 |
|---|
开发速度
|
性能
|
上架难度
|
适合场景
| | 原生开发 | Swift/Kotlin |
|---|
慢
|
最好
|
低
|
重度交互、硬件调用
| | 跨端框架 | Flutter/React Native |
|---|
中
|
接近原生
|
低
|
大多数商业App
| | 低代码+AI | 各类生成平台 |
|---|
最快
|
一般
|
中
|
原型验证、内部工具
|
我的默认推荐是
跨端框架
。原因很实际:一套代码同时出iOS和Android,AI对Flutter和React Native的代码生成质量已经相当高,社区资料也全。原生开发虽然性能最好,但两套代码意味着两倍的AI生成量和两倍的调试量,除非你的App重度依赖摄像头、蓝牙、传感器(比如蓝牙控制ESP32这类场景),否则没必要。
低代码加AI这条路,我要泼一点冷水。它确实能让你在一天内看到一个能点的界面,但当你需要自定义支付流程、接入第三方登录、处理复杂的离线缓存时,平台的能力边界就会卡住你。我建议把低代码平台当成“画原型”的工具,而不是“做产品”的工具。原型验证完,该写代码还是得写。
2.3 AI在整个开发链路中的位置
把开发链路拆成需求、设计、编码、测试、发布、运维六个阶段,AI的介入程度是这样的:
需求阶段
:AI可以帮你把模糊想法整理成用户故事和验收标准,但优先级排序必须由人来定。
设计阶段
:AI能生成配色方案、图标描述、甚至Figma插件里的布局建议,但信息架构和交互流程要由人把关。
编码阶段
:这是AI的主场,样板代码、接口封装、数据模型、单元测试,效率提升最明显。
测试阶段
:AI能生成测试用例和边界条件,但真机兼容性测试和用户体验测试必须由人来做。
发布阶段
:AI基本帮不上忙,应用商店的元数据、截图、隐私政策、审核沟通全是人工活。
运维阶段
:AI能帮你分析日志、定位崩溃,但线上事故的决策要人来拍板。
看清楚这张分布图,你就不会对AI抱有不切实际的期待。
编码阶段能省掉百分之六十到七十的敲键盘时间,但整个项目周期只缩短百分之四十左右
,因为其他阶段省不下来。
3. 核心细节解析与实操要点:从零到可运行
3.1 环境准备:别在工具链上浪费时间
环境搭建是新手最容易卡住的地方,也是AI最能帮上忙的地方,因为报错信息可以直接丢给AI让它解释。我的建议是:
用AI帮你配环境,但严格按官方文档的版本号来。
以Flutter为例,你需要装的东西其实就三样:Flutter SDK、一个编辑器(VS Code或Android Studio)、以及对应平台的模拟器或真机调试环境。我见过有人折腾一整天环境还没跑起来,问题往往出在版本不匹配上。Flutter的版本和Dart的版本是绑定的,Android的Gradle版本又和JDK版本绑定,这三者任何一个错位都会报一堆看不懂的错。
我的做法是:先装官方推荐的稳定版,然后用
flutter doctor
命令检查,把输出的每一条警告都丢给AI问“这条警告是什么意思,要不要处理”。实测下来,
flutter doctor
的警告里真正需要处理的一般只有两三条,其余可以忽略。这一步用AI能省掉大量搜索时间。
注意:不要同时装多个版本的SDK,也不要用系统自带的包管理器装Flutter。版本冲突是环境问题的头号来源,用官方压缩包手动解压到固定目录最稳。
3.2 数据模型设计:AI生成后必须人工复核
数据模型是整个App的地基。我的流程是:先用自然语言把实体和关系描述清楚,让AI生成建表语句或ORM模型,然后
逐字段复核
。复核的重点有三个:字段类型是否合理、索引是否加对、关联关系是否会产生N+1查询。
举个例子,做一个图书管理App,用户、书籍、借阅记录三个实体。AI很可能给你生成一个借阅记录表,里面有用户ID和书籍ID,这没问题。但它可能忘记在用户ID和书籍ID上加索引,导致数据量上来后查询变慢。它也可能把借阅时间存成字符串而不是时间戳,导致排序和范围查询出问题。这些细节AI不会主动提醒你,因为它只关心“能跑”,不关心“跑得好”。
我通常会要求AI在生成模型时附带一段说明,解释每个字段的用途和索引策略,然后我对照业务需求检查。这个习惯帮我避免了好几次上线后的性能问题。
3.3 接口契约先行:让AI按契约生成代码
这是我认为最能提升AI编码质量的一个技巧。
不要让AI自由发挥接口设计,而是你先定好接口契约,再让它按契约实现。
接口契约包括:路径、方法、请求参数、响应结构、错误码。你可以用OpenAPI格式写,也可以用简单的表格写。写完之后,把契约贴给AI,让它生成前端调用代码和后端处理逻辑。这样生成的两端代码能严丝合缝地对上,不会出现前端传
userId
后端收
user_id
这种低级错误。
我实测过,用契约驱动的方式,前后端联调的时间能减少一半以上。因为大部分联调问题,本质上都是字段名和类型不一致,契约先行直接从根源上消灭了这类问题。
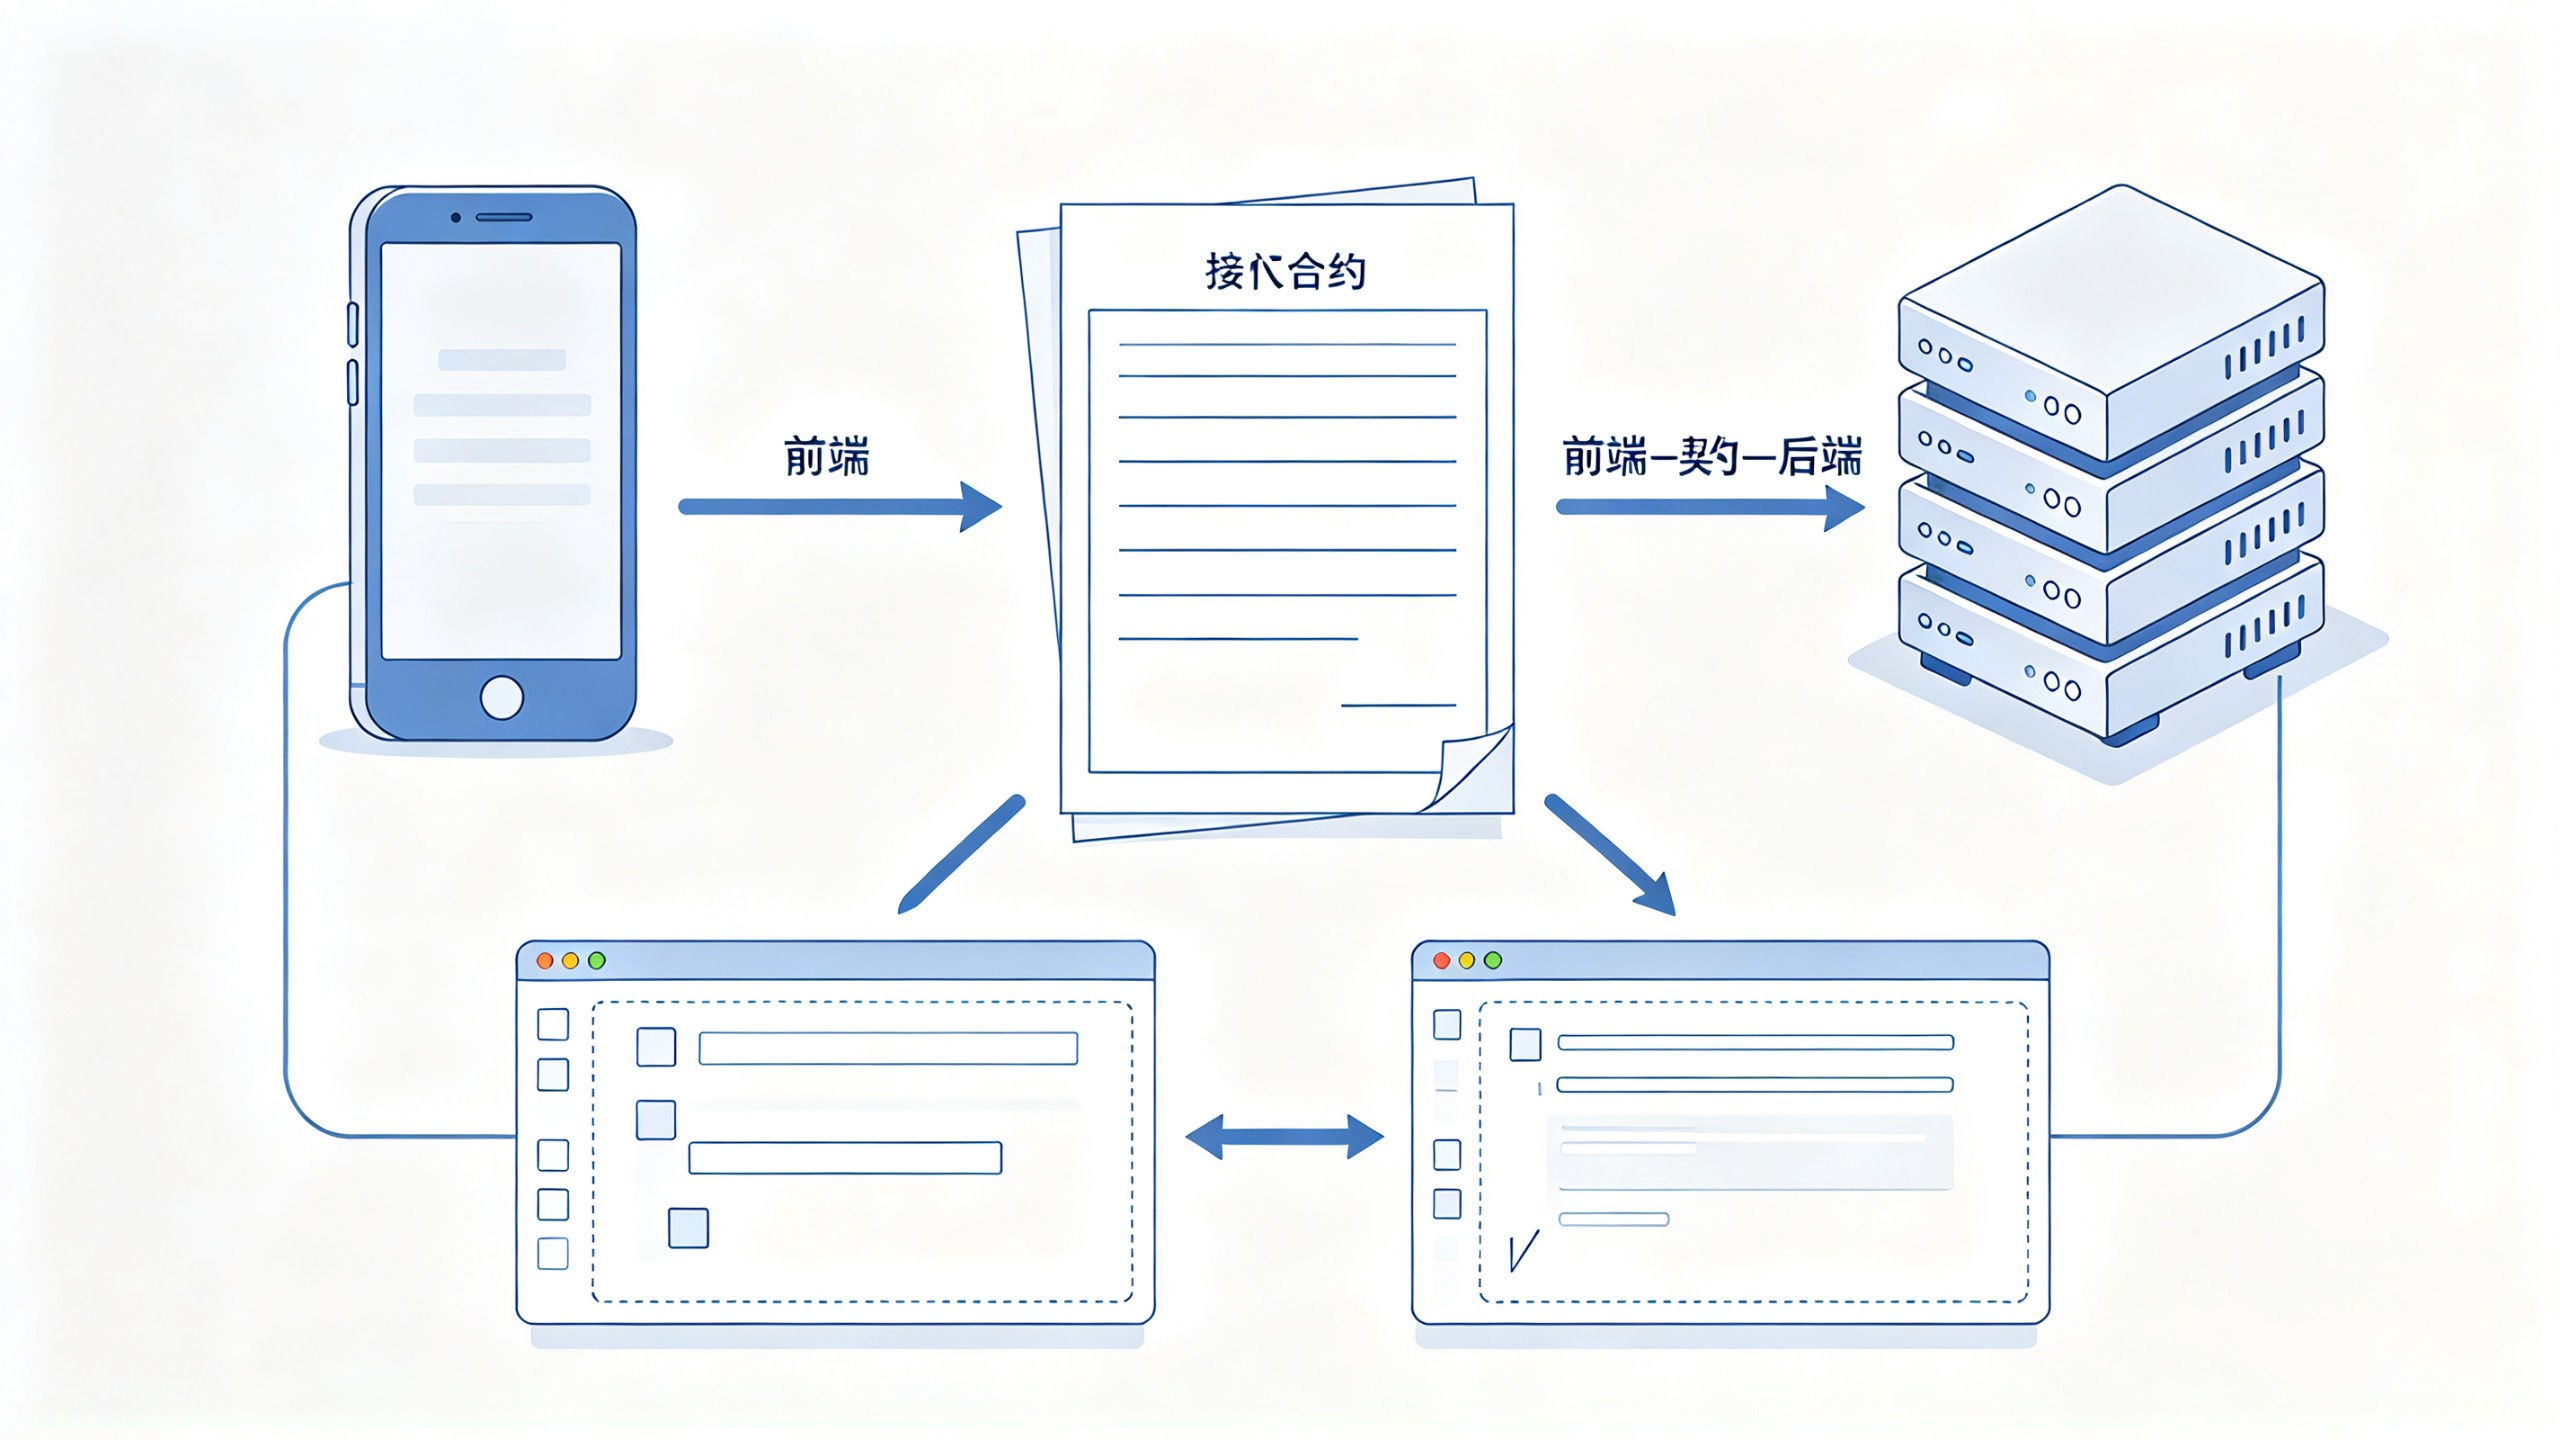
3.4 提示词工程:给AI的指令要像给实习生的任务单
很多人抱怨AI生成的代码质量差,问题往往出在指令太模糊。“帮我写一个登录功能”这种指令,AI只能猜你的技术栈、鉴权方式、错误处理策略。好的指令就应该像给实习生的任务单,要包含:技术栈、输入输出、边界条件、错误处理要求、代码风格。
我常用的指令模板是这样的:
技术栈:Flutter 3.x + Riverpod 状态管理 + Dio 网络库
任务:实现登录页面的表单提交逻辑
输入:手机号(11位,必填)、密码(6-20位,必填)
输出:调用 POST /api/login,成功返回 token 并存入安全存储,失败返回错误信息
边界条件:手机号格式错误时前端拦截,密码为空时按钮置灰
错误处理:网络超时提示重试,401 提示账号密码错误,500 提示稍后再试
代码风格:使用 AsyncNotifier,错误用 sealed class 封装
用这种指令,AI一次生成可用代码的概率会大幅提升。你可以把这个模板存下来,每次改改参数就能复用。
3.5 版本控制:AI改代码前必须提交
这一条是血泪教训。AI有时候会“好心”帮你重构,把你没让它改的地方也一起改了。如果你没有版本控制,改坏了都回不去。我的铁律是:
每次让AI改代码之前,先git commit一次。
这样即使AI改崩了,一条
git reset
就能回到干净状态。
更进一步,我建议用分支来隔离AI的改动。让AI在一个独立分支上改,你review完再合并。这样主分支始终是可运行状态,不会因为AI的一次失误导致整个项目跑不起来。
4. 实操过程与核心环节实现:一个运动打卡App的完整走查
4.1 需求拆解与MVP范围划定
假设我们要做一个运动打卡App,核心功能是:用户注册登录、记录运动(类型、时长、卡路里)、查看历史记录、周排行榜。听起来简单,但如果全做,至少两周。我的做法是先划MVP:
只做注册登录和记录运动,历史记录和排行榜放第二版。
为什么这样划?因为注册登录和记录运动是核心闭环,能验证“用户愿不愿意用”。历史记录和排行榜是增强功能,不影响核心验证。MVP越小,上线越快,拿到反馈越早。AI在这个阶段能帮你把需求写成用户故事,但划范围必须你自己来,因为只有你知道哪个功能是验证假设的关键。
4.2 用AI生成项目骨架
环境配好后,第一步是生成项目骨架。我用Flutter的
flutter create
命令生成基础项目,然后让AI帮我配置目录结构。我的目录结构习惯是这样的:
lib/
  features/
    auth/
      data/
      domain/
      presentation/
    workout/
      data/
      domain/
      presentation/
  core/
    network/
    storage/
    theme/
  main.dart
这个结构是按功能模块划分的,每个模块内部再分数据层、领域层、表现层。好处是模块之间解耦,AI改一个模块不会影响另一个。我把这个结构描述给AI,让它生成各层的空文件和基础类,十分钟就能搭好架子。
4.3 登录模块:从契约到实现
登录模块的接口契约我先定好:
| 项目 | 内容 |
|---|
| 路径 | POST /api/auth/login |
|---|
| 请求 | { "phone": "string", "password": "string" } |
|---|
| 成功响应 | { "token": "string", "userId": "string" } |
|---|
| 失败响应 | { "code": 401, "message": "账号或密码错误" } |
|---|
然后我把这个契约和提示词模板一起交给AI,让它生成Dio的网络请求封装、Riverpod的AsyncNotifier,以及登录页面的表单校验。生成完之后我做了三件事:检查token是否存进了安全存储而不是普通SharedPreferences、检查密码是否在日志里被打印、检查错误提示是否区分了网络错误和业务错误。这三项是登录模块最容易出安全问题的地方。
注意:AI生成的代码里,密码字段经常会被日志打印出来,这是严重的安全隐患。每次生成涉及密码的代码,都要全局搜索一遍日志语句,确认敏感字段没有被输出。
4.4 运动记录模块:本地优先的设计
运动记录这个功能,我采用了本地优先的设计:用户记录先存本地数据库,再异步同步到服务器。这样做的好处是没网也能记录,用户体验好。AI帮我生成了本地数据库的表结构和增删改查逻辑,我选的是Drift(Flutter的ORM库),因为它类型安全,AI生成的质量也高。
同步逻辑是难点。我的做法是给每条记录加一个
synced
字段,同步成功后置为true。同步时只查
synced=false
的记录,逐条上传。如果上传失败,保留
synced=false
,下次再试。这个逻辑并不复杂,但AI第一次生成时漏掉了“上传成功后更新本地状态”这一步,导致重复上传。我在review时发现了,补上之后才恢复正常。
4.5 排行榜:一个被低估的性能陷阱
排行榜看起来简单,实际上却是个性能陷阱。如果每次请求都实时聚合所有用户的运动数据,用户量一上来数据库就扛不住。我的方案是用定时任务每隔十分钟算一次排行榜,把结果缓存起来,前端直接读缓存。AI帮我生成了聚合查询和缓存写入的逻辑,但定时任务的调度需要我自己配置。
这里有个细节:聚合查询要按周分组,涉及日期计算。AI生成的日期计算逻辑用了本地时区,但服务器是UTC时区,导致跨周计算错误。这个问题在测试环境没有暴露,因为测试数据都在同一周内。我是上线后第二天发现排行榜数据不对,才排查出来的。教训是:
所有涉及日期时间的逻辑,都要明确时区,并且用跨周、跨月、跨年的测试数据去验证。
4.6 打包与上架:AI帮不上忙的部分
打包和上架是AI基本帮不上忙的环节。iOS需要配置证书、描述文件、App ID,Android需要签名密钥、混淆规则、多渠道打包。这些配置一旦出错,报错信息往往很晦涩。我的经验是:
严格按官方文档一步步来,不要跳步,也不要用从网上抄来的配置。
上架材料包括应用图标、截图、描述、隐私政策、年龄分级。隐私政策是很多个人开发者容易忽略的,但应用商店审核时一定会查。如果你的App收集了用户手机号、位置、运动数据,隐私政策里必须逐项说明收集什么、用来做什么、是否共享给第三方。这份文档AI能帮你起草,但最终内容你要自己负责,因为它是法律文件。
注意:应用商店审核被拒最常见的原因是隐私政策不完整,以及截图与实际功能不符。提交前把这两项反复检查,能省掉一轮审核往返,通常就是三到五天。
5. 常见问题与排查技巧实录
5.1 AI生成代码的典型问题速查
| 问题现象 | 根本原因 |
|---|
解决方法
| | 代码能跑但性能差 | AI优先选最短实现,忽略索引和缓存 |
|---|
复核数据库查询,补索引和缓存层
| | 前后端字段对不上 | 没有接口契约,AI各自发挥 |
|---|
契约先行,按契约生成两端代码
| | 敏感信息被打印 | AI默认加日志方便调试 |
|---|
全局搜索日志语句,过滤敏感字段
| | 时区计算错误 | AI用本地时区,服务器用UTC |
|---|
统一用UTC存储,展示时再转换
| | 重复提交/重复上传 | 缺少幂等设计 |
|---|
加唯一标识和状态字段
| | 依赖版本冲突 | AI用了过时或未来的版本号 |
|---|
锁定版本,按官方兼容矩阵核对
|
这张表是我踩坑踩出来的,每一条都对应着一次真实的返工。你可以把它当成AI生成代码的review清单,每次生成完就对照检查一遍。
5.2 真机调试的坑:模拟器跑通不等于真机跑通
模拟器和真机的差异比想象中大。我遇到过模拟器上网络请求正常、真机上却超时的问题,排查半天才发现是模拟器走了本机网络,真机走了蜂窝网络,而测试服务器的防火墙只放行了本机IP。还遇到过模拟器上字体正常、真机上字体溢出的问题,因为真机的系统字体设置被用户调大了。
我的建议是:
功能开发阶段用模拟器提效率,但每个模块完成后必须在真机上跑一遍。
尤其是涉及网络、存储、权限、字体、深色模式的功能。真机测试不用等全部做完,做完一个模块测一个,问题越早发现越好修。
5.3 上架审核被拒的常见原因
除了隐私政策和截图问题,还有几个高频拒审原因:App内有测试数据或占位内容、登录功能需要提供测试账号、App崩溃或白屏、使用了未授权的第三方内容。我建议提交审核前做一次“干净安装测试”:把App从设备上完全卸载,重新安装,走一遍完整流程,确保没有残留数据导致的异常。
另外,审核周期通常是一到三天,被拒后重新提交又要再等一轮。所以第一次提交前多花两小时自查,比被拒后等三天划算得多。
5.4 成本估算:开发一个App并上架到底要多少钱
这是被问得最多的问题之一。我把成本拆成几块:开发工具(基本免费)、服务器(初期每月几十到几百)、应用商店开发者账号(iOS每年固定费用,Android一次性费用)、以及最容易被忽略的
时间成本
。如果自己开发,时间就是最大的成本;如果外包,报价从几千到几十万不等,具体取决于功能复杂度。
用AI辅助自己开发,能省掉的主要是人力成本。一个中等复杂度的App,传统外包报价可能在几万到十几万;自己用AI开发,服务器和账号成本加起来一年也就几百到几千。但前提是你愿意投入学习时间,并且能接受前期踩坑。如果你的时间成本很高,外包可能更划算;如果你想长期迭代产品,自己掌握开发能力更值。
6. 把AI能力接进App:另一条完全不同的路
前面讲的都是“AI帮我写App”,这一节讲“AI当App的功能”。这两件事的技术栈和成本结构完全不同,我单独拎出来说,是因为问“AI聊天女友”“AI诵经”“AI旅游规划”这类需求的人越来越多。
6.1 大模型接入的基本架构
把大模型接进App,核心链路是:App收集用户输入,发给你的后端,后端调用大模型接口,拿到结果返回给App。为什么不直接从App调大模型接口?因为API密钥不能放在客户端,否则被人抓包就泄露了。所以必须有一个后端做中转。
后端要做的事包括:鉴权(确认是合法用户)、限流(防止滥用)、提示词组装(把用户输入和系统提示词拼起来)、结果处理(过滤敏感内容、格式化输出),以及计费统计。这些逻辑不复杂,但每一环都不能省。AI能帮你生成这套后端的骨架代码,但提示词的设计和内容安全策略需要你自己反复调试。
6.2 提示词工程与对话状态管理
做AI聊天类功能,提示词是核心竞争力。系统提示词决定了AI的人设、语气、知识边界。我调试提示词的方法是:准备一组典型用户输入,包括正常问题、边界问题、恶意输入,然后观察AI的回复,不断调整提示词。这个过程没有捷径,就是反复试。
对话状态管理是另一个难点。大模型本身是无状态的,每次调用都要把历史对话带上。但历史对话不能无限带,否则会超出上下文长度限制,也会增加成本。我的做法是保留最近若干轮对话,更早的对话做摘要压缩。这个策略需要在成本和体验之间找平衡点,没有标准答案。
6.3 内容安全与合规底线
做AI对话类App,内容安全是红线。你必须有一套机制来过滤不当内容,包括用户输入和AI输出两端。输入端过滤明显的违规词,输出端做二次审核。这套机制可以用现成的审核接口,也可以自己维护词库。无论哪种,都要在上线前充分测试,确保不会漏放违规内容。
注意:内容安全不是加一个过滤器就完事,而是需要持续运营。上线后要有人工复核机制,处理用户举报,定期更新过滤规则。这块投入不能省,省了会出大问题。
6.4 成本控制:token就是钱
大模型调用是按token计费的,用户聊得越多,成本越高。如果不做控制,一个爆款App的API账单能吓死人。我的控制策略有三层:限制单用户每日调用次数、限制单次对话的上下文长度、对高频用户做分级限流。这三层加起来,能把成本控制在可预测范围内。
另外,不是所有功能都需要用大模型。比如AI诵经这种场景,如果内容相对固定,完全可以用规则引擎加模板,成本几乎为零。用大模型是杀鸡用牛刀。判断标准很简单:
如果这个任务的输出空间是有限的、可枚举的,就别用大模型。
7. 我踩过的坑和几条硬经验
先说一个最贵的坑。我曾经让AI帮我重构一个模块,它把数据库字段名从驼峰改成了下划线,理由是“符合SQL规范”。结果前端所有引用这个字段的地方全挂了,而我当时没有仔细review,直接合并了。上线后用户数据加载失败,排查了两个小时才发现是字段名的问题。从那以后,我定了一条规矩:
AI改动的代码,diff必须逐行看,尤其是字段名、接口路径、配置项这类“牵一发动全身”的地方。
第二条经验是关于测试的。AI生成的单元测试往往只覆盖正常路径,边界条件覆盖不足。我的做法是让AI先生成测试,然后我手动补充边界用例:空值、超长字符串、特殊字符、并发调用、网络中断。这些用例AI不会主动想,但恰恰是线上问题的高发区。
第三条是关于依赖管理的。AI有时候会推荐一些冷门的第三方库,理由是“代码更简洁”。但冷门库意味着社区小、维护差,出了问题没人帮你。我的原则是:
优先用官方库和主流库,冷门库除非有不可替代的优势,否则不用。
主流库的坑已经被无数人踩过,解决方案一搜就有;冷门库的坑只有你自己踩,踩完还得自己填。
最后一条,也是我觉得最重要的一条:
AI是加速器,不是替代品。
它能帮你更快地写出代码,但不能帮你决定写什么代码。需求判断、架构设计、安全底线、用户体验,这些仍然需要人来做。把AI当成一个不知疲倦、知识面广、但缺乏判断力的实习生,你负责定方向和把关,它负责执行。这个定位摆正了,效率提升是实实在在的;摆不正,就会陷入“AI生成一堆代码、自己收拾烂摊子”的循环。
如果你现在正准备用AI开发第一个App,我的建议是从最小的功能开始,跑通“需求到上架”的完整链路,哪怕这个App只有一个页面。走完一遍,你就知道哪些环节AI能帮上忙、哪些环节必须自己来。这个认知比任何教程都值钱。
1. 从一句“帮我做个App”说起:AI开发App到底在开发什么
“如何用AI开发一款App”,这句话,我在过去一年里被问到的次数,比前五年加起来都多。问的人五花八门:有做网约车调度的小老板,有想给自家运动课程做个打卡工具的教练,有做专利辅助检索的代理人,也有单纯想验证一个点子值不值得投入的产品经理。大家嘴里的“AI开发App”,其实指向的是完全不同的三件事,如果不先把这三件事拆开,后面所有的工具选型、成本估算、上架流程都会跑偏。
第一件事,是
用AI当编程助手,人来主导开发
。你仍然是开发者,只是把写样板代码、查API文档、生成单元测试、解释报错这些活儿交给AI。这是目前最成熟、最可控的路径,也是我日常主力使用的方式。第二件事,是
用AI生成式平台,靠自然语言描述直接产出可运行的应用
。你描述需求,平台吐出前端页面、后端逻辑甚至数据库结构,适合快速验证想法。第三件事,是
把AI能力嵌进App本身
,比如做一个AI聊天女友、AI诵经助手、AI旅游规划、AI声音空间化处理,App只是载体,核心价值在模型调用和提示词工程上。
这三件事经常被混为一谈,导致很多人一上来就问“哪个平台能一键生成App”,结果做出来的东西既不能上架,也没法维护。我的建议是:先明确你要的是“AI帮我写代码”,还是“AI当App的功能”,这两个方向的工具链、成本结构、技术门槛完全不同。本文会以第一件事为主线,因为它是唯一能让你真正掌控产品、并且能走到上架和长期迭代的路径,同时在关键节点上把第二、第三件事的取舍讲清楚。
适合谁看?如果你有基本的编程概念(知道什么是前端、后端、数据库),想用AI把开发效率提升三到五倍,这篇可以直接抄作业。如果你完全不懂代码,只想快速做个原型给投资人看,我也会在第二节给出低代码加AI的替代方案。如果你是想把大模型能力接进现有App的开发者,第三节的架构拆解和第五节的踩坑记录对你会更有用。
先给一个我实测下来的整体判断:
AI能把一个App的开发周期从三个月压到三到四周,但压不掉的是需求梳理、数据设计、上架合规和真机调试这四块。
很多人以为AI能全包,结果卡在应用商店审核和支付回调上,白白浪费两周。所以下面的内容,我会把“AI能加速的部分”和“AI帮不上、必须人来的部分”分得很清楚。
2. 整体设计与思路拆解:先定架构,再谈AI
2.1 为什么我坚持“人定架构、AI填实现”
我见过太多人一上来就打开AI对话窗口,输入“帮我写一个网约车App”,然后拿到一堆看起来能跑、实际上没法扩展的代码。问题出在架构决策上。一个App的核心架构决策包括:前端用什么框架、后端是自建还是用BaaS、数据库选关系型还是文档型、状态管理怎么做、鉴权方案是什么、支付和推送接哪家。这些决策一旦定错,后面AI生成的代码越多,返工成本越高。
举个具体例子。假设你要做一个运动打卡App,用户每天上传运动记录,还要有排行榜。如果你让AI直接生成,它很可能给你一个前端直接调数据库的写法,因为这样代码最短。但排行榜需要聚合查询,前端直连数据库既暴露了密钥,又扛不住并发。正确的做法是后端提供一个聚合接口,前端只调接口。这个决策AI不会主动帮你做,因为它不知道你的用户量级和成本预算。
所以我的流程是:
先用半小时把架构图画在纸上,明确模块边界和接口契约,然后再让AI逐个模块生成实现。
架构图不需要多正式,几个方框加箭头就行,但它决定了后面AI生成的内容能不能拼在一起。这一步省不得,省了后面一定加倍还回来。
2.2 三种技术路线的取舍:原生、跨端、低代码
路线选择直接决定开发成本和上架难度。我把三条路线的关键指标列出来,你可以对照自己的情况选。
| 路线 | 代表方案 |
|---|
开发速度
|
性能
|
上架难度
|
适合场景
| | 原生开发 | Swift/Kotlin |
|---|
慢
|
最好
|
低
|
重度交互、硬件调用
| | 跨端框架 | Flutter/React Native |
|---|
中
|
接近原生
|
低
|
大多数商业App
| | 低代码+AI | 各类生成平台 |
|---|
最快
|
一般
|
中
|
原型验证、内部工具
|
我的默认推荐是
跨端框架
。原因很实际:一套代码同时出iOS和Android,AI对Flutter和React Native的代码生成质量已经相当高,社区资料也全。原生开发虽然性能最好,但两套代码意味着两倍的AI生成量和两倍的调试量,除非你的App重度依赖摄像头、蓝牙、传感器(比如蓝牙控制ESP32这类场景),否则没必要。
低代码加AI这条路,我要泼一点冷水。它确实能让你在一天内看到一个能点的界面,但当你需要自定义支付流程、接入第三方登录、处理复杂的离线缓存时,平台的能力边界就会卡住你。我建议把低代码平台当成“画原型”的工具,而不是“做产品”的工具。原型验证完,该写代码还是得写。
2.3 AI在整个开发链路中的位置
把开发链路拆成需求、设计、编码、测试、发布、运维六个阶段,AI的介入程度是这样的:
需求阶段
:AI可以帮你把模糊想法整理成用户故事和验收标准,但优先级排序必须由人来定。
设计阶段
:AI能生成配色方案、图标描述、甚至Figma插件里的布局建议,但信息架构和交互流程要由人把关。
编码阶段
:这是AI的主场,样板代码、接口封装、数据模型、单元测试,效率提升最明显。
测试阶段
:AI能生成测试用例和边界条件,但真机兼容性测试和用户体验测试必须由人来做。
发布阶段
:AI基本帮不上忙,应用商店的元数据、截图、隐私政策、审核沟通全是人工活。
运维阶段
:AI能帮你分析日志、定位崩溃,但线上事故的决策要人来拍板。
看清楚这张分布图,你就不会对AI抱有不切实际的期待。
编码阶段能省掉百分之六十到七十的敲键盘时间,但整个项目周期只缩短百分之四十左右
,因为其他阶段省不下来。
3. 核心细节解析与实操要点:从零到可运行
3.1 环境准备:别在工具链上浪费时间
环境搭建是新手最容易卡住的地方,也是AI最能帮上忙的地方,因为报错信息可以直接丢给AI让它解释。我的建议是:
用AI帮你配环境,但严格按官方文档的版本号来。
以Flutter为例,你需要装的东西其实就三样:Flutter SDK、一个编辑器(VS Code或Android Studio)、以及对应平台的模拟器或真机调试环境。我见过有人折腾一整天环境还没跑起来,问题往往出在版本不匹配上。Flutter的版本和Dart的版本是绑定的,Android的Gradle版本又和JDK版本绑定,这三者任何一个错位都会报一堆看不懂的错。
我的做法是:先装官方推荐的稳定版,然后用
flutter doctor
命令检查,把输出的每一条警告都丢给AI问“这条警告是什么意思,要不要处理”。实测下来,
flutter doctor
的警告里真正需要处理的一般只有两三条,其余可以忽略。这一步用AI能省掉大量搜索时间。
注意:不要同时装多个版本的SDK,也不要用系统自带的包管理器装Flutter。版本冲突是环境问题的头号来源,用官方压缩包手动解压到固定目录最稳。
3.2 数据模型设计:AI生成后必须人工复核
数据模型是整个App的地基。我的流程是:先用自然语言把实体和关系描述清楚,让AI生成建表语句或ORM模型,然后
逐字段复核
。复核的重点有三个:字段类型是否合理、索引是否加对、关联关系是否会产生N+1查询。
举个例子,做一个图书管理App,用户、书籍、借阅记录三个实体。AI很可能给你生成一个借阅记录表,里面有用户ID和书籍ID,这没问题。但它可能忘记在用户ID和书籍ID上加索引,导致数据量上来后查询变慢。它也可能把借阅时间存成字符串而不是时间戳,导致排序和范围查询出问题。这些细节AI不会主动提醒你,因为它只关心“能跑”,不关心“跑得好”。
我通常会要求AI在生成模型时附带一段说明,解释每个字段的用途和索引策略,然后我对照业务需求检查。这个习惯帮我避免了好几次上线后的性能问题。
3.3 接口契约先行:让AI按契约生成代码
这是我认为最能提升AI编码质量的一个技巧。
不要让AI自由发挥接口设计,而是你先定好接口契约,再让它按契约实现。
接口契约包括:路径、方法、请求参数、响应结构、错误码。你可以用OpenAPI格式写,也可以用简单的表格写。写完之后,把契约贴给AI,让它生成前端调用代码和后端处理逻辑。这样生成的两端代码能严丝合缝地对上,不会出现前端传
userId
后端收
user_id
这种低级错误。
我实测过,用契约驱动的方式,前后端联调的时间能减少一半以上。因为大部分联调问题,本质上都是字段名和类型不一致,契约先行直接从根源上消灭了这类问题。
3.4 提示词工程:给AI的指令要像给实习生的任务单
很多人抱怨AI生成的代码质量差,问题往往出在指令太模糊。“帮我写一个登录功能”这种指令,AI只能猜你的技术栈、鉴权方式、错误处理策略。好的指令就应该像给实习生的任务单,要包含:技术栈、输入输出、边界条件、错误处理要求、代码风格。
我常用的指令模板是这样的:
技术栈:Flutter 3.x + Riverpod 状态管理 + Dio 网络库
任务:实现登录页面的表单提交逻辑
输入:手机号(11位,必填)、密码(6-20位,必填)
输出:调用 POST /api/login,成功返回 token 并存入安全存储,失败返回错误信息
边界条件:手机号格式错误时前端拦截,密码为空时按钮置灰
错误处理:网络超时提示重试,401 提示账号密码错误,500 提示稍后再试
代码风格:使用 AsyncNotifier,错误用 sealed class 封装
用这种指令,AI一次生成可用代码的概率会大幅提升。你可以把这个模板存下来,每次改改参数就能复用。
3.5 版本控制:AI改代码前必须提交
这一条是血泪教训。AI有时候会“好心”帮你重构,把你没让它改的地方也一起改了。如果你没有版本控制,改坏了都回不去。我的铁律是:
每次让AI改代码之前,先git commit一次。
这样即使AI改崩了,一条
git reset
就能回到干净状态。
更进一步,我建议用分支来隔离AI的改动。让AI在一个独立分支上改,你review完再合并。这样主分支始终是可运行状态,不会因为AI的一次失误导致整个项目跑不起来。
4. 实操过程与核心环节实现:一个运动打卡App的完整走查
4.1 需求拆解与MVP范围划定
假设我们要做一个运动打卡App,核心功能是:用户注册登录、记录运动(类型、时长、卡路里)、查看历史记录、周排行榜。听起来简单,但如果全做,至少两周。我的做法是先划MVP:
只做注册登录和记录运动,历史记录和排行榜放第二版。
为什么这样划?因为注册登录和记录运动是核心闭环,能验证“用户愿不愿意用”。历史记录和排行榜是增强功能,不影响核心验证。MVP越小,上线越快,拿到反馈越早。AI在这个阶段能帮你把需求写成用户故事,但划范围必须你自己来,因为只有你知道哪个功能是验证假设的关键。
4.2 用AI生成项目骨架
环境配好后,第一步是生成项目骨架。我用Flutter的
flutter create
命令生成基础项目,然后让AI帮我配置目录结构。我的目录结构习惯是这样的:
lib/
  features/
    auth/
      data/
      domain/
      presentation/
    workout/
      data/
      domain/
      presentation/
  core/
    network/
    storage/
    theme/
  main.dart
这个结构是按功能模块划分的,每个模块内部再分数据层、领域层、表现层。好处是模块之间解耦,AI改一个模块不会影响另一个。我把这个结构描述给AI,让它生成各层的空文件和基础类,十分钟就能搭好架子。
4.3 登录模块:从契约到实现
登录模块的接口契约我先定好:
| 项目 | 内容 |
|---|
| 路径 | POST /api/auth/login |
|---|
| 请求 | { "phone": "string", "password": "string" } |
|---|
| 成功响应 | { "token": "string", "userId": "string" } |
|---|
| 失败响应 | { "code": 401, "message": "账号或密码错误" } |
|---|
然后我把这个契约和提示词模板一起交给AI,让它生成Dio的网络请求封装、Riverpod的AsyncNotifier,以及登录页面的表单校验。生成完之后我做了三件事:检查token是否存进了安全存储而不是普通SharedPreferences、检查密码是否在日志里被打印、检查错误提示是否区分了网络错误和业务错误。这三项是登录模块最容易出安全问题的地方。
注意:AI生成的代码里,密码字段经常会被日志打印出来,这是严重的安全隐患。每次生成涉及密码的代码,都要全局搜索一遍日志语句,确认敏感字段没有被输出。
4.4 运动记录模块:本地优先的设计
运动记录这个功能,我采用了本地优先的设计:用户记录先存本地数据库,再异步同步到服务器。这样做的好处是没网也能记录,用户体验好。AI帮我生成了本地数据库的表结构和增删改查逻辑,我选的是Drift(Flutter的ORM库),因为它类型安全,AI生成的质量也高。
同步逻辑是难点。我的做法是给每条记录加一个
synced
字段,同步成功后置为true。同步时只查
synced=false
的记录,逐条上传。如果上传失败,保留
synced=false
,下次再试。这个逻辑并不复杂,但AI第一次生成时漏掉了“上传成功后更新本地状态”这一步,导致重复上传。我在review时发现了,补上之后才恢复正常。
4.5 排行榜:一个被低估的性能陷阱
排行榜看起来简单,实际上却是个性能陷阱。如果每次请求都实时聚合所有用户的运动数据,用户量一上来数据库就扛不住。我的方案是用定时任务每隔十分钟算一次排行榜,把结果缓存起来,前端直接读缓存。AI帮我生成了聚合查询和缓存写入的逻辑,但定时任务的调度需要我自己配置。
这里有个细节:聚合查询要按周分组,涉及日期计算。AI生成的日期计算逻辑用了本地时区,但服务器是UTC时区,导致跨周计算错误。这个问题在测试环境没有暴露,因为测试数据都在同一周内。我是上线后第二天发现排行榜数据不对,才排查出来的。教训是:
所有涉及日期时间的逻辑,都要明确时区,并且用跨周、跨月、跨年的测试数据去验证。
4.6 打包与上架:AI帮不上忙的部分
打包和上架是AI基本帮不上忙的环节。iOS需要配置证书、描述文件、App ID,Android需要签名密钥、混淆规则、多渠道打包。这些配置一旦出错,报错信息往往很晦涩。我的经验是:
严格按官方文档一步步来,不要跳步,也不要用从网上抄来的配置。
上架材料包括应用图标、截图、描述、隐私政策、年龄分级。隐私政策是很多个人开发者容易忽略的,但应用商店审核时一定会查。如果你的App收集了用户手机号、位置、运动数据,隐私政策里必须逐项说明收集什么、用来做什么、是否共享给第三方。这份文档AI能帮你起草,但最终内容你要自己负责,因为它是法律文件。
注意:应用商店审核被拒最常见的原因是隐私政策不完整,以及截图与实际功能不符。提交前把这两项反复检查,能省掉一轮审核往返,通常就是三到五天。
5. 常见问题与排查技巧实录
5.1 AI生成代码的典型问题速查
| 问题现象 | 根本原因 |
|---|
解决方法
| | 代码能跑但性能差 | AI优先选最短实现,忽略索引和缓存 |
|---|
复核数据库查询,补索引和缓存层
| | 前后端字段对不上 | 没有接口契约,AI各自发挥 |
|---|
契约先行,按契约生成两端代码
| | 敏感信息被打印 | AI默认加日志方便调试 |
|---|
全局搜索日志语句,过滤敏感字段
| | 时区计算错误 | AI用本地时区,服务器用UTC |
|---|
统一用UTC存储,展示时再转换
| | 重复提交/重复上传 | 缺少幂等设计 |
|---|
加唯一标识和状态字段
| | 依赖版本冲突 | AI用了过时或未来的版本号 |
|---|
锁定版本,按官方兼容矩阵核对
|
这张表是我踩坑踩出来的,每一条都对应着一次真实的返工。你可以把它当成AI生成代码的review清单,每次生成完就对照检查一遍。
5.2 真机调试的坑:模拟器跑通不等于真机跑通
模拟器和真机的差异比想象中大。我遇到过模拟器上网络请求正常、真机上却超时的问题,排查半天才发现是模拟器走了本机网络,真机走了蜂窝网络,而测试服务器的防火墙只放行了本机IP。还遇到过模拟器上字体正常、真机上字体溢出的问题,因为真机的系统字体设置被用户调大了。
我的建议是:
功能开发阶段用模拟器提效率,但每个模块完成后必须在真机上跑一遍。
尤其是涉及网络、存储、权限、字体、深色模式的功能。真机测试不用等全部做完,做完一个模块测一个,问题越早发现越好修。
5.3 上架审核被拒的常见原因
除了隐私政策和截图问题,还有几个高频拒审原因:App内有测试数据或占位内容、登录功能需要提供测试账号、App崩溃或白屏、使用了未授权的第三方内容。我建议提交审核前做一次“干净安装测试”:把App从设备上完全卸载,重新安装,走一遍完整流程,确保没有残留数据导致的异常。
另外,审核周期通常是一到三天,被拒后重新提交又要再等一轮。所以第一次提交前多花两小时自查,比被拒后等三天划算得多。
5.4 成本估算:开发一个App并上架到底要多少钱
这是被问得最多的问题之一。我把成本拆成几块:开发工具(基本免费)、服务器(初期每月几十到几百)、应用商店开发者账号(iOS每年固定费用,Android一次性费用)、以及最容易被忽略的
时间成本
。如果自己开发,时间就是最大的成本;如果外包,报价从几千到几十万不等,具体取决于功能复杂度。
用AI辅助自己开发,能省掉的主要是人力成本。一个中等复杂度的App,传统外包报价可能在几万到十几万;自己用AI开发,服务器和账号成本加起来一年也就几百到几千。但前提是你愿意投入学习时间,并且能接受前期踩坑。如果你的时间成本很高,外包可能更划算;如果你想长期迭代产品,自己掌握开发能力更值。
6. 把AI能力接进App:另一条完全不同的路
前面讲的都是“AI帮我写App”,这一节讲“AI当App的功能”。这两件事的技术栈和成本结构完全不同,我单独拎出来说,是因为问“AI聊天女友”“AI诵经”“AI旅游规划”这类需求的人越来越多。
6.1 大模型接入的基本架构
把大模型接进App,核心链路是:App收集用户输入,发给你的后端,后端调用大模型接口,拿到结果返回给App。为什么不直接从App调大模型接口?因为API密钥不能放在客户端,否则被人抓包就泄露了。所以必须有一个后端做中转。
后端要做的事包括:鉴权(确认是合法用户)、限流(防止滥用)、提示词组装(把用户输入和系统提示词拼起来)、结果处理(过滤敏感内容、格式化输出),以及计费统计。这些逻辑不复杂,但每一环都不能省。AI能帮你生成这套后端的骨架代码,但提示词的设计和内容安全策略需要你自己反复调试。
6.2 提示词工程与对话状态管理
做AI聊天类功能,提示词是核心竞争力。系统提示词决定了AI的人设、语气、知识边界。我调试提示词的方法是:准备一组典型用户输入,包括正常问题、边界问题、恶意输入,然后观察AI的回复,不断调整提示词。这个过程没有捷径,就是反复试。
对话状态管理是另一个难点。大模型本身是无状态的,每次调用都要把历史对话带上。但历史对话不能无限带,否则会超出上下文长度限制,也会增加成本。我的做法是保留最近若干轮对话,更早的对话做摘要压缩。这个策略需要在成本和体验之间找平衡点,没有标准答案。
6.3 内容安全与合规底线
做AI对话类App,内容安全是红线。你必须有一套机制来过滤不当内容,包括用户输入和AI输出两端。输入端过滤明显的违规词,输出端做二次审核。这套机制可以用现成的审核接口,也可以自己维护词库。无论哪种,都要在上线前充分测试,确保不会漏放违规内容。
注意:内容安全不是加一个过滤器就完事,而是需要持续运营。上线后要有人工复核机制,处理用户举报,定期更新过滤规则。这块投入不能省,省了会出大问题。
6.4 成本控制:token就是钱
大模型调用是按token计费的,用户聊得越多,成本越高。如果不做控制,一个爆款App的API账单能吓死人。我的控制策略有三层:限制单用户每日调用次数、限制单次对话的上下文长度、对高频用户做分级限流。这三层加起来,能把成本控制在可预测范围内。
另外,不是所有功能都需要用大模型。比如AI诵经这种场景,如果内容相对固定,完全可以用规则引擎加模板,成本几乎为零。用大模型是杀鸡用牛刀。判断标准很简单:
如果这个任务的输出空间是有限的、可枚举的,就别用大模型。
7. 我踩过的坑和几条硬经验
先说一个最贵的坑。我曾经让AI帮我重构一个模块,它把数据库字段名从驼峰改成了下划线,理由是“符合SQL规范”。结果前端所有引用这个字段的地方全挂了,而我当时没有仔细review,直接合并了。上线后用户数据加载失败,排查了两个小时才发现是字段名的问题。从那以后,我定了一条规矩:
AI改动的代码,diff必须逐行看,尤其是字段名、接口路径、配置项这类“牵一发动全身”的地方。
第二条经验是关于测试的。AI生成的单元测试往往只覆盖正常路径,边界条件覆盖不足。我的做法是让AI先生成测试,然后我手动补充边界用例:空值、超长字符串、特殊字符、并发调用、网络中断。这些用例AI不会主动想,但恰恰是线上问题的高发区。
第三条是关于依赖管理的。AI有时候会推荐一些冷门的第三方库,理由是“代码更简洁”。但冷门库意味着社区小、维护差,出了问题没人帮你。我的原则是:
优先用官方库和主流库,冷门库除非有不可替代的优势,否则不用。
主流库的坑已经被无数人踩过,解决方案一搜就有;冷门库的坑只有你自己踩,踩完还得自己填。
最后一条,也是我觉得最重要的一条:
AI是加速器,不是替代品。
它能帮你更快地写出代码,但不能帮你决定写什么代码。需求判断、架构设计、安全底线、用户体验,这些仍然需要人来做。把AI当成一个不知疲倦、知识面广、但缺乏判断力的实习生,你负责定方向和把关,它负责执行。这个定位摆正了,效率提升是实实在在的;摆不正,就会陷入“AI生成一堆代码、自己收拾烂摊子”的循环。
如果你现在正准备用AI开发第一个App,我的建议是从最小的功能开始,跑通“需求到上架”的完整链路,哪怕这个App只有一个页面。走完一遍,你就知道哪些环节AI能帮上忙、哪些环节必须自己来。这个认知比任何教程都值钱。
收起阅读 »
uniapp ios运行自定义基座包:只有编译成功,手机没有自动安装自定义基座;解决办法
一:运行步骤
1、HBuilder X版本老基座是:5.24;升级后:5.26
2、5.26重新打自定义基座包;
3、打包成功后;运行控制台报:
09:58:36.248 uni-agent:最懂 uni-app(x) 开发的 AI Agent,全程自动化、真正的无人值守,详情
09:58:36.255 项目 DiTuiApp 开始编译
09:58:38.335 请注意运行模式下,因日志输出、sourcemap 以及未压缩源码等原因,性能和包体积,均不及发行模式。
09:58:38.336 编译器版本:5.26(vue3)
09:58:38.336 正在编译中...
09:58:38.336 编译会生成大量临时文件,杀毒软件监控时会影响编译速度,并造成CPU升高。推荐把项目目录添加到杀毒软件的监控排除名单中。[添加] [帮助]
09:58:51.874 项目 DiTuiApp 编译成功。
09:58:52.061 ready in 15106ms.
4、等待五分钟后,手机未正常运行基座或安装最新基座;运行其他正常项目发现也不行了!!
二:解决办法(三种办法):
1、使用超级管理员(Administrator)身份启动 HBuilderX,然后重新尝试运行。(我没效果)
2、确保 iOS 设备已正确信任电脑:(这个方法解决了)
手机连接电脑后,确认手机上已点击“信任此电脑”。
对于 iOS 16+ 设备,需开启【设置】->【隐私与安全性】->【开发者模式】。
首次安装时,需在【设置】->【通用】->【VPN与设备管理】中信任开发者证书。
3、如果自动安装持续失败,可尝试手动安装:(没测试;但是看案例逻辑是正确的)
云打包完成后,下载生成的 iOS_debug.ipa 文件。
使用爱思助手、iTunes 或 Apple Configurator 2 将 ipa 安装到手机。
安装后,在 HBuilderX 的【运行】->【运行到手机或模拟器】->【运行到 iOS App 基座】中选择已安装的自定义基座进行调试。
4、恢复上一个能正常运行HBuilder X版本尝试是否是版本更新问题;
以上四个方法,大家可以自行尝试,我是通过第二种方法解决的问题!!
一:运行步骤
1、HBuilder X版本老基座是:5.24;升级后:5.26
2、5.26重新打自定义基座包;
3、打包成功后;运行控制台报:
09:58:36.248 uni-agent:最懂 uni-app(x) 开发的 AI Agent,全程自动化、真正的无人值守,详情
09:58:36.255 项目 DiTuiApp 开始编译
09:58:38.335 请注意运行模式下,因日志输出、sourcemap 以及未压缩源码等原因,性能和包体积,均不及发行模式。
09:58:38.336 编译器版本:5.26(vue3)
09:58:38.336 正在编译中...
09:58:38.336 编译会生成大量临时文件,杀毒软件监控时会影响编译速度,并造成CPU升高。推荐把项目目录添加到杀毒软件的监控排除名单中。[添加] [帮助]
09:58:51.874 项目 DiTuiApp 编译成功。
09:58:52.061 ready in 15106ms.
4、等待五分钟后,手机未正常运行基座或安装最新基座;运行其他正常项目发现也不行了!!
二:解决办法(三种办法):
1、使用超级管理员(Administrator)身份启动 HBuilderX,然后重新尝试运行。(我没效果)
2、确保 iOS 设备已正确信任电脑:(这个方法解决了)
手机连接电脑后,确认手机上已点击“信任此电脑”。
对于 iOS 16+ 设备,需开启【设置】->【隐私与安全性】->【开发者模式】。
首次安装时,需在【设置】->【通用】->【VPN与设备管理】中信任开发者证书。
3、如果自动安装持续失败,可尝试手动安装:(没测试;但是看案例逻辑是正确的)
云打包完成后,下载生成的 iOS_debug.ipa 文件。
使用爱思助手、iTunes 或 Apple Configurator 2 将 ipa 安装到手机。
安装后,在 HBuilderX 的【运行】->【运行到手机或模拟器】->【运行到 iOS App 基座】中选择已安装的自定义基座进行调试。
4、恢复上一个能正常运行HBuilder X版本尝试是否是版本更新问题;
以上四个方法,大家可以自行尝试,我是通过第二种方法解决的问题!!
收起阅读 »
uni-app 开发鸿蒙 Next 应用:从 HBuilderX 初始化到 DevEco Studio 上架全流程
我用 uni-app 从零到一落地过一款鸿蒙 Next 应用,从 HBuilderX 初始化工程、写好页面,到跑上真机,再打包上架到应用市场,整个过程比想象中要顺,但中间也确实有几个配置和适配的坎。这篇文章我把整条链路拆开讲,重点放在 HBuilderX 怎么开发 uni-app 程序、入口文件与工程结构怎么理解、鸿蒙 Next 的适配差异,以及上架审核时容易忽略的材料和权限问题。适合刚入门的 uni-app 开发者,也适合手里已有小程序或 H5 项目、想低成本迁移进鸿蒙生态的团队参考。
1. 先说结论:uni-app 为什么能碰鸿蒙 Next
1.1 鸿蒙 Next 的真实处境
鸿蒙 Next 系统出来后,很多人的第一反应是:以前打一个安卓 APK 包,华为手机装上就能跑,现在这条路断了。新系统不再直接兼容安卓应用,这对个人开发者和小团队来说确实是个门槛——如果要用原生 ArkTS 重写整套业务,学习成本、时间成本都是肉眼可见的高。
但反过来看,这也是一次机会。鸿蒙 Next 的应用市场正处于生态建设的快速通道期,很多品类还没有被头部 App 占满。对个人开发者来说,早点把产品搬上去,能吃到一波流量红利。关键是得有一条低成本的跨端开发路径,而 uni-app 的编译能力刚好能覆盖这个需求。
1.2 为什么选 uni-app 而不是直接上 ArkTS
我身边不少朋友纠结过这个问题:直接用 ArkTS 写原生不好吗?当然好,官方支持最完整、性能上限最高。但现实是,如果你已经有了一套基于 Vue 的 uni-app 项目,或者主力技术栈是 Vue,那么用 ArkTS 重写的成本就不是十天半个月的事。
uni-app 的优势在于它把 Vue 语法翻译成多种端的目标代码,鸿蒙 Next 只是其中一个编译目标。同一套代码,小程序端、App 端、H5 端、鸿蒙端都能出包。选型时我也对比过 Taro、Flutter、React Native:Taro 对鸿蒙的适配链路不如 uni-app 直接,Flutter 在鸿蒙上的第三方生态还在完善,React Native 的鸿蒙支持更是要自己拼接不少胶水代码。综合下来,uni-app 是“用最少的迁移成本换一个可上架鸿蒙应用”的最优解。
注意:这里说的“低门槛”不是让团队放弃原生,而是指个人开发者、小团队、存量 uni-app 项目迁移时,uni-app 是性价比最高的方案。如果你的核心业务非常依赖原生地图、复杂动画、底层音视频处理,那该上 ArkTS 还是要上。
1.3 动手前先想清楚三件事
第一件事:你的应用是否有必须依赖原生组件的能力。比如人脸识别、实时音视频、自定义高性能绘制,这些在 uni-app 里虽然能通过插件市场找到封装方案,但可定制性有限。跑通“工具型小应用”没问题,复杂业务要先做技术验证。
第二件事:后端接口是否已经是 HTTPS,且域名有备案。鸿蒙 Next 的应用和很多移动端一样,对明文 HTTP 的限制比较严格,开发阶段还好,上架前如果还是 HTTP 接口,审核基本过不去。
第三件事:你的签名账号和设备准备好了没有。上架应用市场需要华为开发者账号,真机调试需要开启开发者模式的鸿蒙 Next 设备,或者用 DevEco Studio 自带的模拟器。这些最好在开发之前就备齐,别等页面写完了才去注册账号、等审核。
2. HBuilderX 环境与工程初始化
2.1 工具链版本匹配:HBuilderX、DevEco、SDK
我用的是 HBuilderX 4.62 版本,这个版本号在鸿蒙编译支持上已经算比较稳的了。撰写本文时,HBuilderX 对鸿蒙 Next 的支持已经包含在正式版里,不需要额外装插件。但有一环绕不开:最终打包还是得用 DevEco Studio。
如果你之前只做过小程序,没碰过鸿蒙原生,这个搭配会有点绕,简单说就是:HBuilderX 负责写代码和编译,生成一个完整的鸿蒙工程;DevEco Studio 负责打开这个工程,配置签名、跑模拟器、打正式包。所以两个工具都要装,DevEco Studio 里对应的鸿蒙 SDK 也要装好。
安装顺序建议是先装 HBuilderX,再装 DevEco Studio。DevEco Studio 安装时会让你选择 SDK 版本,这里别选太新的预览版,优先选正式发布的 API 版本,兼容性更好。我第一次用 Preview SDK 编译,运行阶段被一个底层接口变更折腾了大半天,后来退回正式版就没事了。

2.2 新建 uni-app 项目与目录结构
在 HBuilderX 里新建项目时,选“uni-app”模板,框架选 Vue 3,模版选默认空模版即可。很多人第一步就踩坑:选了“Hello uni-app”这种带大量示例插件的模板,里面冗余代码太多,编译到鸿蒙时体积大,还有不少与业务无关的插件请求。
新建完成后,目录结构是这样的,我建议你把每个文件的作用先搞清楚再写代码:
| 文件/目录 | 作用 |
|---|
| pages | 页面文件,每个页面一般由 .vue 文件构成 |
|---|
| static | 静态资源,图标、图片、本地 json 等 |
|---|
| main.js | 入口文件,创建应用实例、挂载 Pinia 等 |
|---|
| App.vue | 应用根组件,可以监听 onLaunch、onShow 等生命周期 |
|---|
| pages.json | 页面路由与导航栏、tabBar 配置 |
|---|
| manifest.json | 应用配置,包括应用ID、图标、模块权限、鸿蒙相关设置 |
|---|
| uni.scss | 全局样式变量 |
|---|
对小白来说,最常见的困惑是“页面到底从哪个文件开始”。实际启动顺序是:main.js 先执行,创建应用实例;然后是 App.vue 的 onLaunch 生命周期;最后根据 pages.json 里 pages 数组的第一项加载首页。这个过程不是单纯看代码就能理解的,建议你在 App.vue 的 onLaunch 里打一个 console.log,在首页 onLoad 里也打一个,运行时看控制台顺序,一次就清楚了。
2.3 入口文件与启动流程:main.js、App.vue、pages.json
很多从微信小程序转过来的开发者容易对入口文件犯迷糊。小程序里入口是 app.js、app.json、app.wxss 三件套,uni-app 里对应关系是:main.js 负责 JS 启动,App.vue 负责应用生命周期和全局样式,pages.json 负责路由和窗口表现。
main.js 通常是这样写的:
import App from './App.vue'
import { createSSRApp } from 'vue'

export function createApp() {
  const app = createSSRApp(App)
  return {
    app
  }
}
在 App.vue 里,你可以这样编写生命周期:
<script>
export default {
  onLaunch() {
    console.log('应用启动')
  },
  onShow() {
    console.log('应用从前台切换到前台')
  }
}
</script>

<style>
/* 全局样式 */
</style>
pages.json 里则要声明每个页面的路径、窗口标题和导航栏样式。编译到鸿蒙 Next 时,pages.json 中配置的导航栏会映射为鸿蒙侧的页面路由配置。需要注意的一点是:鸿蒙端对“首页必须存在且第一个呈现”有明确要求,pages.json 数组中的第一项就会被当作启动首页,别把启动页配置搞错。
2.4 manifest.json 配置要点
manifest.json 是很多人最容易忽略但坑最深的文件。在 HBuilderX 里它以可视化表单呈现,但本质是 JSON。对鸿蒙 Next 来说,重点关注以下几块:
基础配置里要填写应用名称和应用版本号,版本号后续上架会严格校验,建议一开始就按语义化版本维护。
图标和启动图,要准备多尺寸的 PNG,鸿蒙对圆角图标要求比较细,直接用 1024x1024 的主图生成最省事。
App 模块权限:按需勾选,比如定位、相机、网络。这里的原则是“用不到的权限绝对不勾”,鸿蒙上架审核对隐私合规很敏感,权限越多,审核问题越多。
鸿蒙相关配置:包括应用 ID、证书文件、描述文件。开发阶段可以先不填,但真机调试和打正式包时,这些必须要与 DevEco Studio 里配置的保持一致,否则构建出来的应用无法安装。
实操经验:我把 manifest.json 里所有能通过代码判断的权限都做成了运行时的动态申请,而不是在配置里一次性全声明。这样审核时被问到权限用途的概率会低很多。
3. 页面开发与核心功能实现
3.1 搭建首页、列表页、详情页
不管是工具类应用还是内容类应用,首页、列表页、详情页这三个结构基本能覆盖大多数场景。我的做法是先搭路由,再写页面骨架。
pages.json 路由配置示例:
{
  "pages": [
    {
      "path": "pages/index/index",
      "style": {
        "navigationBarTitleText": "首页"
      }
    },
    {
      "path": "pages/list/list",
      "style": {
        "navigationBarTitleText": "列表"
      }
    },
    {
      "path": "pages/detail/detail",
      "style": {
        "navigationBarTitleText": "详情"
      }
    }
  ]
}
首页的 .vue 文件大概是这个骨架:
<template>
  <view class="page">
    <view class="banner">今日推荐</view>
    <view class="card-list">
      <view v-for="item in list" :key="item.id" class="card" @click="goDetail(item.id)">
        <text class="title">{{ item.title }}</text>
        <text class="desc">{{ item.desc }}</text>
      </view>
    </view>
  </view>
</template>

<script setup>
import { ref, onLoad } from '@dcloudio/uni-app'

const list = ref([])

onLoad(() => {
  // 拉取数据
})

function goDetail(id) {
  uni.navigateTo({
    url: '/pages/detail/detail?id=' + id
  })
}
</script>
这里特别提醒一下:如果你用的是 Vue 3 script setup 写法,生命周期方法建议从
@dcloudio/uni-app
里 import,要和 Vue 自带的 onMounted 区分开。onLoad 是页面级生命周期,页面跳转传参只能靠它拿到;onMounted 是组件挂载,两者在 uni-app 里不能划等号。在鸿蒙 Next 端,路由栈和应用生命周期管理与小程序端有细微差别,页面 onLoad 的触发时机基本一致,但 onShow 会更容易被触发,因为鸿蒙的窗口切换生命周期更频繁。
3.2 数据请求与状态管理
数据请求是 uni-app 开发中的高频场景。官方提供的 uni.request 在小程序端和 H5 端都可用,鸿蒙 Next 端同样支持,但要注意以下几点。
第一,接口域名必须是 HTTPS,且证书有效。我在开发阶段用 HTTP 的测试接口,页面能正常出数据,但编译成鸿蒙包后请求直接失败,控制台报错说是网络安全配置问题。所以至少到真机调试阶段,就要把接口切到 HTTPS。
第二,请求封装要统一处理 loading、错误码、登录态。我的封装思路很简单:每个请求维护一个拦截器,进入时开启 loading,返回后统一判断 code,非 0 就弹出 toast。鸿蒙端 toast 组件和微信小程序的体验接近,但注意不要在短时间内连续调用 uni.showToast,鸿蒙会丢失前面的提示。
第三,状态管理。Vue 3 项目我推荐 Pinia,uni-app 官方也支持。页面多了以后,跨页面共享用户信息、设置项,全靠 props 和事件会非常痛苦。用 Pinia 的 store 管理全局状态,配合
pinia
插件,在 main.js 里挂载,然后在业务页面里
useStore()
即可。
3.3 原生能力调用与权限声明
一个鸿蒙 Next 应用如果要调用相机、定位、相册,必须提前声明权限。在 uni-app 里,这些能力通常用官方 API 封装,比如
uni.chooseImage
、
uni.getLocation
、
uni.scanCode
实际开发中我踩过的一个坑是:manifest.json 的模块权限没有勾选“相机”,结果在真机上调用扫码功能,一点反应都没有,控制台报 “Permission denied”。翻了一圈,不是代码问题,是权限声明问题。所以页面里用到什么能力,先在 manifest 可视化配置里勾选对应模块。
权限声明只是第一层,运行时系统还会弹窗询问用户是否授权。这里要处理好拒绝授权的场景。我在 App.vue 里做了一个“未授权引导”:当用户拒绝后,下一次操作时弹窗说明为什么要这个权限,引导去系统设置打开。鸿蒙 Next 的设置跳转接口在 uni-app 里可以通过
uni.openAppAuthorizeSetting
调用,亲测有效。
3.4 样式与 rpx 适配:鸿蒙下的坑
uni-app 开发 App 时可以选 rpx 作为样式单位,在鸿蒙 Next 端同样支持。rpx 的原理是把屏幕宽度分成 750 份,理论上跨设备等比缩放。但鸿蒙的部分设备屏幕尺寸跨度大,折叠屏、平板跑同一个应用时,卡片布局可能会出现拉伸变形的问题。
我的处理策略是:
基础间距用 rpx,保证小屏下比例正常。
大区块布局使用 flex 加百分比,避免内容被过度拉伸。
文字大小在关键标题上额外用
upx
动态计算,确保折叠屏展开时不至于缩得太小。
另外注意安全区。鸿蒙 Next 全面屏设备底部有一条手势条,如果页面有底部操作栏,要额外设置
padding-bottom: env(safe-area-inset-bottom)
。我凭 iPhone 时代的经验直接搬过来,发现鸿蒙同样支持这个 CSS 环境变量,但不同机型返回值有差异,需要在真机上再确认一遍。
4. 真机调试与鸿蒙适配
4.1 把编译产物跑起来:模拟器与真机
整个开发链路里,最容易让小白崩溃的就是“代码写了但不知道怎么跑起来”。在 HBuilderX 中,点击“运行到鸿蒙”的相关入口,选择设备或模拟器前,要确保 DevEco Studio 的 SDK 已经配置到 HBuilderX 里。
我第一次运行时,HBuilderX 提示找不到鸿蒙 SDK,实际上是因为 DevEco Studio 装好后,SDK 路径默认在用户目录下,而 HBuilderX 需要指定这个路径。填好路径后,编译过程会自动生成鸿蒙工程,然后拉起模拟器安装运行。
如果要在真机上调试,步骤会多两步:手机开启开发者模式并连接电脑,然后在 DevEco Studio 的签名配置页面生成调试证书。没有做调试签名的话,真机安装会被拒。
真机调试时我习惯的做法是:先用 HBuilderX 的“运行”查看页面代码层面的报错,再用 DevEco Studio 查看系统级日志。两边的日志一边看业务代码,一边看系统调用,配合起来排查问题速度快很多。
4.2 鸿蒙 Next 特有的适配差异
不做鸿蒙适配的话,很多页面在安卓/iOS 上正常,到了鸿蒙就出现各种小问题。我整理几个高概率碰到的差异点:
| 差异点 | 现象 |
|---|
我的处理方案
| | 键盘遮挡输入框 | 底部输入框被弹出键盘盖住 |
|---|
使用 adjust-position
或监听键盘高度做位移
|
| 状态栏高度 | 页面顶部内容被状态栏吞掉 |
|---|
使用 uni.getSystemInfo
获取状态栏高度,动态设置 padding
|
| 导航栏返回 | 手势返回时页面状态没有触发 onShow |
|---|
在 onShow 里做数据刷新,而不是依赖返回事件
| | 字体渲染 | 部分字体在鸿蒙下偏细、偏小 |
|---|
全局指定系统默认字体栈,不引入过细的自定义字体
| | 下拉刷新 | 原生下拉刷新样式不一致 |
|---|
关闭导航栏原生下拉,用自定义刷新组件统一视觉
|
尤其是键盘遮挡问题,在鸿蒙 Next 的几个版本上表现不一致,不能只做一套方案。我的最终做法是:单行输入框用系统默认的弹出策略,多行输入框手动监听键盘高度,给页面底部留出安全空间。这个细节在审核演示视频里会很加分,因为操作流畅性一眼就能看出来。
4.3 首屏性能和长列表优化
鸿蒙 Next 端毕竟是原生渲染,uni-app 编译出来的页面在性能上不如纯 ArkTS 是正常的,但通过优化能让体验接近原生。我重点做了三件事:
第一,首页的请求并发控制。不要在页面的 onLoad 里同时发五个请求,尽量合并接口,或者用 Promise.all 串行控制,减少首屏加载时长。鸿蒙端的网络并发限制在某些版本上比较保守,一次并发太多,响应会被延迟。
第二,长列表虚拟滚动。如果列表一次性渲染 50 条以上数据,在鸿蒙低端机上滑动会有肉眼可见的掉帧。我换成了虚拟列表组件,只渲染可视区域内的节点。实测在 200 条数据的场景下,滚动流畅度提升非常明显。
第三,图片懒加载与压缩。首页 banner 图不能直接丢一张 2MB 的原图上去,我在上传服务端时统一压缩到 webp 或 jpg,质量 80%,宽度按设备 2 倍屏适配。这个优化收益最直接,页面加载速度几乎能提升一倍。
5. 打包签名与上架应用市场
5.1 从 HBuilderX 到 DevEco Studio 的整包打包
开发完成后,最关键的一步就是把代码变成可以被应用市场接受的正式包。在 HBuilderX 里点击“发行”菜单,选择鸿蒙 Next 打包,编译器会生成一个鸿蒙工程。重点来了:这个工程不是最终的发布包,它还需要用 DevEco Studio 打开并完成正式签名,才会生成可以上架的应用文件。
签名的具体流程是:在华为开发者后台创建一个应用,拿到应用的 App ID,然后生成公私钥证书和 Profile 描述文件。在 DevEco Studio 的签名配置界面里,把这些信息填进去,Build 时选择 Release 模式,系统会自动完成签名和打包。
这里有一个特别容易踩的坑:HBuilderX 里配置的 manifest.json 中的应用 ID,必须和 DevEco Studio 里签名用的应用 ID 完全一致,一个字符都不能差。我第一次打包时把应用 ID 填错了一个下划线,导致构建出来的包安装时报签名无效,排查了一个小时才找到问题。
5.2 上架流程与审核材料清单
上架鸿蒙应用市场需要提前准备的材料,比想象中要多,我整理了一份清单:
华为开发者账号(个人开发者即可,需实名认证)
应用基本信息:名称、简介、关键词、分类
应用图标:要求高清、无圆角,建议准备 1024x1024
应用截图:通常需要 3-5 张,要求包含主要功能界面,分辨率要按上架要求生成
软件著作权证书:如果软件是自主研发,建议申请软著,审核更快
测试账号说明:如果应用有登录功能,需要向审核人员提供测试账号。
提交审核页面在 AppGallery Connect 后台,创建应用后依次填写信息、上传包。整个上传界面很清晰,按步骤走就行,需要注意的是“隐私政策”栏目,如果只填一个网页链接,审核人员手动访问打不开,大概率会被驳回。
5.3 审核驳回的常见原因与避坑
我身边几个朋友上架鸿蒙应用,被驳回的原因高度集中在以下几类:
权限声明与实际功能不符。这是最大的一类驳回原因。比如你声明了读取位置权限,但应用里根本没有地点相关功能。所以打包前把 manifest 里的权限再检查一遍,该删的删。
隐私政策链接无法访问。
截图上显示的是开发数据。审核人员看不到真实业务内容,会觉得应用不完整。上架截图里的数据一定要真实、干净,不要用“假数据测试”这样的文案。
应用内出现“测试版”“Beta”字样。部分审核严格时,带测试字样的应用会被认为未完成。
避坑建议:提交审核前,自己按审核人员的视角走一遍完整流程:注册登录、看功能、测试权限弹窗、查隐私政策链接。发现问题先自行处理后,再审一次,通过率会高很多。
6. 常见问题速查表与个人体会
6.1 高频问题排查速查表
| 问题 | 可能原因 |
|---|
解决思路
| | 运行到鸿蒙提示找不到 SDK | HBuilderX 未配置 DevEco Studio 的 SDK 路径 |
|---|
在 HBuilderX 设置里填写 SDK 路径,确保版本匹配
| | 页面白屏 | 路由配置不对或入口文件挂了 |
|---|
检查 pages.json 首页路径、main.js 是否有语法错误
| | uni.request 请求失败 | 接口不是 HTTPS 或证书不受信 |
|---|
切换 HTTPS 接口,确认证书链完整
| | 真机安装失败 | 调试证书未配置或应用 ID 不一致 |
|---|
在 DevEco Studio 里重新配置签名,确认 ID 与 manifest 一致
| | 上架审核被驳回 | 权限与功能不符、隐私政策不可访问 |
|---|
|
这个速查表是我在整套开发流程里真实遇到过的场景。最让我意外的是“应用 ID 不一致”这个问题,它不会在开发阶段暴露,只要是打正式包就必然出现,而新手第一时间根本想不到是签名配置的锅。
6.2 跑通第一版后的几点个人体会
整个项目从零到上架,我做下来最大的感受是:技术难度其实没有想象中大,真正花时间的是处理各种工具链衔接和审核规范。uni-app 本身已经把 90% 的跨端复杂度隐藏掉了,剩下的 10% 集中在鸿蒙编译链路和上架环节。
如果你正准备起步,我的建议是从一个小工具应用开始,比如一个计算器、一个汇率查询、一个待办清单。先把“HBuilderX 写页面 → 编译成鸿蒙工程 → DevEco Studio 签名 → 真机运行 → 打包上架”这一整条链路跑通一次,再去做复杂业务。
最后分享一个我在调试时的小技巧:在 App.vue 的 onLaunch 里,把系统版本、设备型号、屏幕宽度这些参数打一条日志,整理成一个对象存到全局。后面所有页面遇到兼容性问题时,先看这个对象里的参数,再决定是否要做条件判断。这个习惯帮我少走了不少弯路,也让我在追查线上问题时多了一条判断依据。
我用 uni-app 从零到一落地过一款鸿蒙 Next 应用,从 HBuilderX 初始化工程、写好页面,到跑上真机,再打包上架到应用市场,整个过程比想象中要顺,但中间也确实有几个配置和适配的坎。这篇文章我把整条链路拆开讲,重点放在 HBuilderX 怎么开发 uni-app 程序、入口文件与工程结构怎么理解、鸿蒙 Next 的适配差异,以及上架审核时容易忽略的材料和权限问题。适合刚入门的 uni-app 开发者,也适合手里已有小程序或 H5 项目、想低成本迁移进鸿蒙生态的团队参考。
1. 先说结论:uni-app 为什么能碰鸿蒙 Next
1.1 鸿蒙 Next 的真实处境
鸿蒙 Next 系统出来后,很多人的第一反应是:以前打一个安卓 APK 包,华为手机装上就能跑,现在这条路断了。新系统不再直接兼容安卓应用,这对个人开发者和小团队来说确实是个门槛——如果要用原生 ArkTS 重写整套业务,学习成本、时间成本都是肉眼可见的高。
但反过来看,这也是一次机会。鸿蒙 Next 的应用市场正处于生态建设的快速通道期,很多品类还没有被头部 App 占满。对个人开发者来说,早点把产品搬上去,能吃到一波流量红利。关键是得有一条低成本的跨端开发路径,而 uni-app 的编译能力刚好能覆盖这个需求。
1.2 为什么选 uni-app 而不是直接上 ArkTS
我身边不少朋友纠结过这个问题:直接用 ArkTS 写原生不好吗?当然好,官方支持最完整、性能上限最高。但现实是,如果你已经有了一套基于 Vue 的 uni-app 项目,或者主力技术栈是 Vue,那么用 ArkTS 重写的成本就不是十天半个月的事。
uni-app 的优势在于它把 Vue 语法翻译成多种端的目标代码,鸿蒙 Next 只是其中一个编译目标。同一套代码,小程序端、App 端、H5 端、鸿蒙端都能出包。选型时我也对比过 Taro、Flutter、React Native:Taro 对鸿蒙的适配链路不如 uni-app 直接,Flutter 在鸿蒙上的第三方生态还在完善,React Native 的鸿蒙支持更是要自己拼接不少胶水代码。综合下来,uni-app 是“用最少的迁移成本换一个可上架鸿蒙应用”的最优解。
注意:这里说的“低门槛”不是让团队放弃原生,而是指个人开发者、小团队、存量 uni-app 项目迁移时,uni-app 是性价比最高的方案。如果你的核心业务非常依赖原生地图、复杂动画、底层音视频处理,那该上 ArkTS 还是要上。
1.3 动手前先想清楚三件事
第一件事:你的应用是否有必须依赖原生组件的能力。比如人脸识别、实时音视频、自定义高性能绘制,这些在 uni-app 里虽然能通过插件市场找到封装方案,但可定制性有限。跑通“工具型小应用”没问题,复杂业务要先做技术验证。
第二件事:后端接口是否已经是 HTTPS,且域名有备案。鸿蒙 Next 的应用和很多移动端一样,对明文 HTTP 的限制比较严格,开发阶段还好,上架前如果还是 HTTP 接口,审核基本过不去。
第三件事:你的签名账号和设备准备好了没有。上架应用市场需要华为开发者账号,真机调试需要开启开发者模式的鸿蒙 Next 设备,或者用 DevEco Studio 自带的模拟器。这些最好在开发之前就备齐,别等页面写完了才去注册账号、等审核。
2. HBuilderX 环境与工程初始化
2.1 工具链版本匹配:HBuilderX、DevEco、SDK
我用的是 HBuilderX 4.62 版本,这个版本号在鸿蒙编译支持上已经算比较稳的了。撰写本文时,HBuilderX 对鸿蒙 Next 的支持已经包含在正式版里,不需要额外装插件。但有一环绕不开:最终打包还是得用 DevEco Studio。
如果你之前只做过小程序,没碰过鸿蒙原生,这个搭配会有点绕,简单说就是:HBuilderX 负责写代码和编译,生成一个完整的鸿蒙工程;DevEco Studio 负责打开这个工程,配置签名、跑模拟器、打正式包。所以两个工具都要装,DevEco Studio 里对应的鸿蒙 SDK 也要装好。
安装顺序建议是先装 HBuilderX,再装 DevEco Studio。DevEco Studio 安装时会让你选择 SDK 版本,这里别选太新的预览版,优先选正式发布的 API 版本,兼容性更好。我第一次用 Preview SDK 编译,运行阶段被一个底层接口变更折腾了大半天,后来退回正式版就没事了。
2.2 新建 uni-app 项目与目录结构
在 HBuilderX 里新建项目时,选“uni-app”模板,框架选 Vue 3,模版选默认空模版即可。很多人第一步就踩坑:选了“Hello uni-app”这种带大量示例插件的模板,里面冗余代码太多,编译到鸿蒙时体积大,还有不少与业务无关的插件请求。
新建完成后,目录结构是这样的,我建议你把每个文件的作用先搞清楚再写代码:
| 文件/目录 | 作用 |
|---|
| pages | 页面文件,每个页面一般由 .vue 文件构成 |
|---|
| static | 静态资源,图标、图片、本地 json 等 |
|---|
| main.js | 入口文件,创建应用实例、挂载 Pinia 等 |
|---|
| App.vue | 应用根组件,可以监听 onLaunch、onShow 等生命周期 |
|---|
| pages.json | 页面路由与导航栏、tabBar 配置 |
|---|
| manifest.json | 应用配置,包括应用ID、图标、模块权限、鸿蒙相关设置 |
|---|
| uni.scss | 全局样式变量 |
|---|
对小白来说,最常见的困惑是“页面到底从哪个文件开始”。实际启动顺序是:main.js 先执行,创建应用实例;然后是 App.vue 的 onLaunch 生命周期;最后根据 pages.json 里 pages 数组的第一项加载首页。这个过程不是单纯看代码就能理解的,建议你在 App.vue 的 onLaunch 里打一个 console.log,在首页 onLoad 里也打一个,运行时看控制台顺序,一次就清楚了。
2.3 入口文件与启动流程:main.js、App.vue、pages.json
很多从微信小程序转过来的开发者容易对入口文件犯迷糊。小程序里入口是 app.js、app.json、app.wxss 三件套,uni-app 里对应关系是:main.js 负责 JS 启动,App.vue 负责应用生命周期和全局样式,pages.json 负责路由和窗口表现。
main.js 通常是这样写的:
import App from './App.vue'
import { createSSRApp } from 'vue'

export function createApp() {
  const app = createSSRApp(App)
  return {
    app
  }
}
在 App.vue 里,你可以这样编写生命周期:
<script>
export default {
  onLaunch() {
    console.log('应用启动')
  },
  onShow() {
    console.log('应用从前台切换到前台')
  }
}
</script>

<style>
/* 全局样式 */
</style>
pages.json 里则要声明每个页面的路径、窗口标题和导航栏样式。编译到鸿蒙 Next 时,pages.json 中配置的导航栏会映射为鸿蒙侧的页面路由配置。需要注意的一点是:鸿蒙端对“首页必须存在且第一个呈现”有明确要求,pages.json 数组中的第一项就会被当作启动首页,别把启动页配置搞错。
2.4 manifest.json 配置要点
manifest.json 是很多人最容易忽略但坑最深的文件。在 HBuilderX 里它以可视化表单呈现,但本质是 JSON。对鸿蒙 Next 来说,重点关注以下几块:
基础配置里要填写应用名称和应用版本号,版本号后续上架会严格校验,建议一开始就按语义化版本维护。
图标和启动图,要准备多尺寸的 PNG,鸿蒙对圆角图标要求比较细,直接用 1024x1024 的主图生成最省事。
App 模块权限:按需勾选,比如定位、相机、网络。这里的原则是“用不到的权限绝对不勾”,鸿蒙上架审核对隐私合规很敏感,权限越多,审核问题越多。
鸿蒙相关配置:包括应用 ID、证书文件、描述文件。开发阶段可以先不填,但真机调试和打正式包时,这些必须要与 DevEco Studio 里配置的保持一致,否则构建出来的应用无法安装。
实操经验:我把 manifest.json 里所有能通过代码判断的权限都做成了运行时的动态申请,而不是在配置里一次性全声明。这样审核时被问到权限用途的概率会低很多。
3. 页面开发与核心功能实现
3.1 搭建首页、列表页、详情页
不管是工具类应用还是内容类应用,首页、列表页、详情页这三个结构基本能覆盖大多数场景。我的做法是先搭路由,再写页面骨架。
pages.json 路由配置示例:
{
  "pages": [
    {
      "path": "pages/index/index",
      "style": {
        "navigationBarTitleText": "首页"
      }
    },
    {
      "path": "pages/list/list",
      "style": {
        "navigationBarTitleText": "列表"
      }
    },
    {
      "path": "pages/detail/detail",
      "style": {
        "navigationBarTitleText": "详情"
      }
    }
  ]
}
首页的 .vue 文件大概是这个骨架:
<template>
  <view class="page">
    <view class="banner">今日推荐</view>
    <view class="card-list">
      <view v-for="item in list" :key="item.id" class="card" @click="goDetail(item.id)">
        <text class="title">{{ item.title }}</text>
        <text class="desc">{{ item.desc }}</text>
      </view>
    </view>
  </view>
</template>

<script setup>
import { ref, onLoad } from '@dcloudio/uni-app'

const list = ref([])

onLoad(() => {
  // 拉取数据
})

function goDetail(id) {
  uni.navigateTo({
    url: '/pages/detail/detail?id=' + id
  })
}
</script>
这里特别提醒一下:如果你用的是 Vue 3 script setup 写法,生命周期方法建议从
@dcloudio/uni-app
里 import,要和 Vue 自带的 onMounted 区分开。onLoad 是页面级生命周期,页面跳转传参只能靠它拿到;onMounted 是组件挂载,两者在 uni-app 里不能划等号。在鸿蒙 Next 端,路由栈和应用生命周期管理与小程序端有细微差别,页面 onLoad 的触发时机基本一致,但 onShow 会更容易被触发,因为鸿蒙的窗口切换生命周期更频繁。
3.2 数据请求与状态管理
数据请求是 uni-app 开发中的高频场景。官方提供的 uni.request 在小程序端和 H5 端都可用,鸿蒙 Next 端同样支持,但要注意以下几点。
第一,接口域名必须是 HTTPS,且证书有效。我在开发阶段用 HTTP 的测试接口,页面能正常出数据,但编译成鸿蒙包后请求直接失败,控制台报错说是网络安全配置问题。所以至少到真机调试阶段,就要把接口切到 HTTPS。
第二,请求封装要统一处理 loading、错误码、登录态。我的封装思路很简单:每个请求维护一个拦截器,进入时开启 loading,返回后统一判断 code,非 0 就弹出 toast。鸿蒙端 toast 组件和微信小程序的体验接近,但注意不要在短时间内连续调用 uni.showToast,鸿蒙会丢失前面的提示。
第三,状态管理。Vue 3 项目我推荐 Pinia,uni-app 官方也支持。页面多了以后,跨页面共享用户信息、设置项,全靠 props 和事件会非常痛苦。用 Pinia 的 store 管理全局状态,配合
pinia
插件,在 main.js 里挂载,然后在业务页面里
useStore()
即可。
3.3 原生能力调用与权限声明
一个鸿蒙 Next 应用如果要调用相机、定位、相册,必须提前声明权限。在 uni-app 里,这些能力通常用官方 API 封装,比如
uni.chooseImage
、
uni.getLocation
、
uni.scanCode
实际开发中我踩过的一个坑是:manifest.json 的模块权限没有勾选“相机”,结果在真机上调用扫码功能,一点反应都没有,控制台报 “Permission denied”。翻了一圈,不是代码问题,是权限声明问题。所以页面里用到什么能力,先在 manifest 可视化配置里勾选对应模块。
权限声明只是第一层,运行时系统还会弹窗询问用户是否授权。这里要处理好拒绝授权的场景。我在 App.vue 里做了一个“未授权引导”:当用户拒绝后,下一次操作时弹窗说明为什么要这个权限,引导去系统设置打开。鸿蒙 Next 的设置跳转接口在 uni-app 里可以通过
uni.openAppAuthorizeSetting
调用,亲测有效。
3.4 样式与 rpx 适配:鸿蒙下的坑
uni-app 开发 App 时可以选 rpx 作为样式单位,在鸿蒙 Next 端同样支持。rpx 的原理是把屏幕宽度分成 750 份,理论上跨设备等比缩放。但鸿蒙的部分设备屏幕尺寸跨度大,折叠屏、平板跑同一个应用时,卡片布局可能会出现拉伸变形的问题。
我的处理策略是:
基础间距用 rpx,保证小屏下比例正常。
大区块布局使用 flex 加百分比,避免内容被过度拉伸。
文字大小在关键标题上额外用
upx
动态计算,确保折叠屏展开时不至于缩得太小。
另外注意安全区。鸿蒙 Next 全面屏设备底部有一条手势条,如果页面有底部操作栏,要额外设置
padding-bottom: env(safe-area-inset-bottom)
。我凭 iPhone 时代的经验直接搬过来,发现鸿蒙同样支持这个 CSS 环境变量,但不同机型返回值有差异,需要在真机上再确认一遍。
4. 真机调试与鸿蒙适配
4.1 把编译产物跑起来:模拟器与真机
整个开发链路里,最容易让小白崩溃的就是“代码写了但不知道怎么跑起来”。在 HBuilderX 中,点击“运行到鸿蒙”的相关入口,选择设备或模拟器前,要确保 DevEco Studio 的 SDK 已经配置到 HBuilderX 里。
我第一次运行时,HBuilderX 提示找不到鸿蒙 SDK,实际上是因为 DevEco Studio 装好后,SDK 路径默认在用户目录下,而 HBuilderX 需要指定这个路径。填好路径后,编译过程会自动生成鸿蒙工程,然后拉起模拟器安装运行。
如果要在真机上调试,步骤会多两步:手机开启开发者模式并连接电脑,然后在 DevEco Studio 的签名配置页面生成调试证书。没有做调试签名的话,真机安装会被拒。
真机调试时我习惯的做法是:先用 HBuilderX 的“运行”查看页面代码层面的报错,再用 DevEco Studio 查看系统级日志。两边的日志一边看业务代码,一边看系统调用,配合起来排查问题速度快很多。
4.2 鸿蒙 Next 特有的适配差异
不做鸿蒙适配的话,很多页面在安卓/iOS 上正常,到了鸿蒙就出现各种小问题。我整理几个高概率碰到的差异点:
| 差异点 | 现象 |
|---|
我的处理方案
| | 键盘遮挡输入框 | 底部输入框被弹出键盘盖住 |
|---|
使用 adjust-position
或监听键盘高度做位移
|
| 状态栏高度 | 页面顶部内容被状态栏吞掉 |
|---|
使用 uni.getSystemInfo
获取状态栏高度,动态设置 padding
|
| 导航栏返回 | 手势返回时页面状态没有触发 onShow |
|---|
在 onShow 里做数据刷新,而不是依赖返回事件
| | 字体渲染 | 部分字体在鸿蒙下偏细、偏小 |
|---|
全局指定系统默认字体栈,不引入过细的自定义字体
| | 下拉刷新 | 原生下拉刷新样式不一致 |
|---|
关闭导航栏原生下拉,用自定义刷新组件统一视觉
|
尤其是键盘遮挡问题,在鸿蒙 Next 的几个版本上表现不一致,不能只做一套方案。我的最终做法是:单行输入框用系统默认的弹出策略,多行输入框手动监听键盘高度,给页面底部留出安全空间。这个细节在审核演示视频里会很加分,因为操作流畅性一眼就能看出来。
4.3 首屏性能和长列表优化
鸿蒙 Next 端毕竟是原生渲染,uni-app 编译出来的页面在性能上不如纯 ArkTS 是正常的,但通过优化能让体验接近原生。我重点做了三件事:
第一,首页的请求并发控制。不要在页面的 onLoad 里同时发五个请求,尽量合并接口,或者用 Promise.all 串行控制,减少首屏加载时长。鸿蒙端的网络并发限制在某些版本上比较保守,一次并发太多,响应会被延迟。
第二,长列表虚拟滚动。如果列表一次性渲染 50 条以上数据,在鸿蒙低端机上滑动会有肉眼可见的掉帧。我换成了虚拟列表组件,只渲染可视区域内的节点。实测在 200 条数据的场景下,滚动流畅度提升非常明显。
第三,图片懒加载与压缩。首页 banner 图不能直接丢一张 2MB 的原图上去,我在上传服务端时统一压缩到 webp 或 jpg,质量 80%,宽度按设备 2 倍屏适配。这个优化收益最直接,页面加载速度几乎能提升一倍。
5. 打包签名与上架应用市场
5.1 从 HBuilderX 到 DevEco Studio 的整包打包
开发完成后,最关键的一步就是把代码变成可以被应用市场接受的正式包。在 HBuilderX 里点击“发行”菜单,选择鸿蒙 Next 打包,编译器会生成一个鸿蒙工程。重点来了:这个工程不是最终的发布包,它还需要用 DevEco Studio 打开并完成正式签名,才会生成可以上架的应用文件。
签名的具体流程是:在华为开发者后台创建一个应用,拿到应用的 App ID,然后生成公私钥证书和 Profile 描述文件。在 DevEco Studio 的签名配置界面里,把这些信息填进去,Build 时选择 Release 模式,系统会自动完成签名和打包。
这里有一个特别容易踩的坑:HBuilderX 里配置的 manifest.json 中的应用 ID,必须和 DevEco Studio 里签名用的应用 ID 完全一致,一个字符都不能差。我第一次打包时把应用 ID 填错了一个下划线,导致构建出来的包安装时报签名无效,排查了一个小时才找到问题。
5.2 上架流程与审核材料清单
上架鸿蒙应用市场需要提前准备的材料,比想象中要多,我整理了一份清单:
华为开发者账号(个人开发者即可,需实名认证)
应用基本信息:名称、简介、关键词、分类
应用图标:要求高清、无圆角,建议准备 1024x1024
应用截图:通常需要 3-5 张,要求包含主要功能界面,分辨率要按上架要求生成
软件著作权证书:如果软件是自主研发,建议申请软著,审核更快
测试账号说明:如果应用有登录功能,需要向审核人员提供测试账号。
提交审核页面在 AppGallery Connect 后台,创建应用后依次填写信息、上传包。整个上传界面很清晰,按步骤走就行,需要注意的是“隐私政策”栏目,如果只填一个网页链接,审核人员手动访问打不开,大概率会被驳回。
5.3 审核驳回的常见原因与避坑
我身边几个朋友上架鸿蒙应用,被驳回的原因高度集中在以下几类:
权限声明与实际功能不符。这是最大的一类驳回原因。比如你声明了读取位置权限,但应用里根本没有地点相关功能。所以打包前把 manifest 里的权限再检查一遍,该删的删。
隐私政策链接无法访问。
截图上显示的是开发数据。审核人员看不到真实业务内容,会觉得应用不完整。上架截图里的数据一定要真实、干净,不要用“假数据测试”这样的文案。
应用内出现“测试版”“Beta”字样。部分审核严格时,带测试字样的应用会被认为未完成。
避坑建议:提交审核前,自己按审核人员的视角走一遍完整流程:注册登录、看功能、测试权限弹窗、查隐私政策链接。发现问题先自行处理后,再审一次,通过率会高很多。
6. 常见问题速查表与个人体会
6.1 高频问题排查速查表
| 问题 | 可能原因 |
|---|
解决思路
| | 运行到鸿蒙提示找不到 SDK | HBuilderX 未配置 DevEco Studio 的 SDK 路径 |
|---|
在 HBuilderX 设置里填写 SDK 路径,确保版本匹配
| | 页面白屏 | 路由配置不对或入口文件挂了 |
|---|
检查 pages.json 首页路径、main.js 是否有语法错误
| | uni.request 请求失败 | 接口不是 HTTPS 或证书不受信 |
|---|
切换 HTTPS 接口,确认证书链完整
| | 真机安装失败 | 调试证书未配置或应用 ID 不一致 |
|---|
在 DevEco Studio 里重新配置签名,确认 ID 与 manifest 一致
| | 上架审核被驳回 | 权限与功能不符、隐私政策不可访问 |
|---|
|
这个速查表是我在整套开发流程里真实遇到过的场景。最让我意外的是“应用 ID 不一致”这个问题,它不会在开发阶段暴露,只要是打正式包就必然出现,而新手第一时间根本想不到是签名配置的锅。
6.2 跑通第一版后的几点个人体会
整个项目从零到上架,我做下来最大的感受是:技术难度其实没有想象中大,真正花时间的是处理各种工具链衔接和审核规范。uni-app 本身已经把 90% 的跨端复杂度隐藏掉了,剩下的 10% 集中在鸿蒙编译链路和上架环节。
如果你正准备起步,我的建议是从一个小工具应用开始,比如一个计算器、一个汇率查询、一个待办清单。先把“HBuilderX 写页面 → 编译成鸿蒙工程 → DevEco Studio 签名 → 真机运行 → 打包上架”这一整条链路跑通一次,再去做复杂业务。
最后分享一个我在调试时的小技巧:在 App.vue 的 onLaunch 里,把系统版本、设备型号、屏幕宽度这些参数打一条日志,整理成一个对象存到全局。后面所有页面遇到兼容性问题时,先看这个对象里的参数,再决定是否要做条件判断。这个习惯帮我少走了不少弯路,也让我在追查线上问题时多了一条判断依据。
收起阅读 »
运行到浏览器报错: Network: unavailable
Network: unavailable 是 vue-cli 的 default-gateway 模块调用已被新版 Windows 移除的 wmic 命令失败,导致 prepareURLs.js 里 lanUrlForTerminal 保留了默认字面量 chalk.gray('unavailable'),再被 HBuilderX 原样转发到控制台。
修复:public 显式指定局域网访问地址,修复新版 Windows(无 wmic)下 default-gateway 探测失败、控制台显示 Network: unavailable 的问题;getLocalIPv4() 自动取本机私有网段 IP,换网络无需手改。
const os = require('os');
// 获取本机局域网 IPv4(优先 192.168.x / 10.x / 172.16-31.x,排除 169.254.x 链路本地地址)
function getLocalIPv4 () {
const nets = os.networkInterfaces()
const list = []
Object.keys(nets).forEach(name => {
(nets[name] || []).forEach(net => {
if (net.family === 'IPv4' && !net.internal) list.push(net.address)
})
})
const isPrivate = ip => /^10[.]|^172.[.]|^192[.]168[.]/.test(ip)
return list.find(isPrivate) || ''
}
const localIP = getLocalIPv4()
const devPort = 9001
devServer: {
proxy: proxyOption,
port: devPort, // 你的端口号
// 修复新版 Windows(无 wmic)下 default-gateway 探测失败导致控制台显示 Network: unavailable
// 显式指定局域网地址后,控制台会显示 http://<本机IP>:9001/
public: localIP ? ${localIP}:${devPort} : undefined,
},
Network: unavailable 是 vue-cli 的 default-gateway 模块调用已被新版 Windows 移除的 wmic 命令失败,导致 prepareURLs.js 里 lanUrlForTerminal 保留了默认字面量 chalk.gray('unavailable'),再被 HBuilderX 原样转发到控制台。
修复:public 显式指定局域网访问地址,修复新版 Windows(无 wmic)下 default-gateway 探测失败、控制台显示 Network: unavailable 的问题;getLocalIPv4() 自动取本机私有网段 IP,换网络无需手改。
const os = require('os');
// 获取本机局域网 IPv4(优先 192.168.x / 10.x / 172.16-31.x,排除 169.254.x 链路本地地址)
function getLocalIPv4 () {
const nets = os.networkInterfaces()
const list = []
Object.keys(nets).forEach(name => {
(nets[name] || []).forEach(net => {
if (net.family === 'IPv4' && !net.internal) list.push(net.address)
})
})
const isPrivate = ip => /^10[.]|^172.[.]|^192[.]168[.]/.test(ip)
return list.find(isPrivate) || ''
}
const localIP = getLocalIPv4()
const devPort = 9001
devServer: {
proxy: proxyOption,
port: devPort, // 你的端口号
// 修复新版 Windows(无 wmic)下 default-gateway 探测失败导致控制台显示 Network: unavailable
// 显式指定局域网地址后,控制台会显示 http://<本机IP>:9001/
public: localIP ? ${localIP}:${devPort} : undefined,
},
鸿蒙化适配 react-native-torch:模拟器无闪光灯,依赖硬件的三方库该怎么验证
本文记录把 react-native-torch(手电筒 / 相机闪光灯控制)适配到 HarmonyOS 的完整过程,涵盖版本对齐、原生实现走查、接入宿主、构建运行,以及依赖硬件的库在模拟器上究竟该怎么验证。
react-native-torch 的 API 只有两个,却是个典型例子:它控制的是一块模拟器上根本不存在的硬件。这类库的适配难点不在代码量,而在“什么算验证通过”。

一、先说结论
项 | 结果 |
上游最新版 | 1.2.0 |
是否带原生实现 | 是(ArkTS TurboModule,不是纯 JS) |
是否依赖硬件 | 是,依赖相机闪光灯 |
公开 API | switchState(enabled)、requestCameraPermission(title?, message?),都返回 Promise |
是否需要声明权限 | 不需要(连 ohos.permission.CAMERA 都用不上) |
原生实现体量 | ArkTS 侧 19 行,HAR 包 2,875 字节 |
编译是否通过 | ✅ assembleHap 成功,HAP 从 80,714,316 增至 80,867,227 字节(+152,911 ≈ 149 KB) |
原生是否注册 | ✅ 日志 TM created: RCTTorch |
软件层断言 | ✅ 13 / 13 通过(契约 6 + 参数守卫 7) |
硬件层结论 | ⚠️ 本机没有闪光灯,四次调用全部以 ERR_TORCH_UNAVAILABLE 拒绝——没有返回 true 假装成功 |
一句话结论:这个库不需要权限、实现只有 19 行、接入后正常注册;但它要控制的闪光灯在这台设备上并不存在,所以“灯亮不亮”无法在本轮验证——本轮真正验证到的,是它在硬件不支持时会明确报错,而不是假装成功。这两件事必须分开说。
二、判定过程
适配前先回答三个问题。
2.1 这个库需要鸿蒙化吗
看源码就知道必须:
// src/NativeTorch.ts
import type {TurboModule} from 'react-native';
import {TurboModuleRegistry} from 'react-native';

export interface Spec extends TurboModule {
  switchState(enabled: boolean): Promise<boolean>;
  requestCameraPermission(title?: string, message?: string): Promise<boolean>;
}

export default TurboModuleRegistry.getEnforcing<Spec>('RCTTorch');
getEnforcing 意味着取不到原生模块就直接抛错,没有 JS 兜底实现。而 react-native-torch 上游只提供 Android 与 iOS 原生代码,鸿蒙上没有 RCTTorch 这个名字的模块——所以必须补一个鸿蒙原生实现。
这里和纯 JS 库的分界线很清楚:纯 JS 库只要能跑通就直接可用,而这类库不补原生实现就必然报错。
2.2 上游版本核对
npm view react-native-torch version # 1.2.0拿到鸿蒙适配包后对比到上游基线,版本一致,没有落后。
2.3 交付包里该有的信息都在
spec.json 里有 upstream 仓库地址,也有 upstreamCommit 基线 commit——两样都记了,意味着后续上游改动时能确定该合到哪个点,这次适配的可追溯性是完整的。
validation 里还明确写了能力边界,其中一条很关键:
返回 true 不表示设备一定有闪光灯。
交付包自己先把这件事说清楚了,这一点很重要——它没有让调用方误以为“switchState 返回 true = 灯亮了”。
三、适配实现:先查支持性,再下发命令
原生实现全文:
// harmony/torch/src/main/ets/RCTTorchTurboModule.ts
import camera from '@ohos.multimedia.camera';
import { UITurboModule } from '@rnoh/react-native-openharmony/ts';

export class RCTTorchTurboModule extends UITurboModule {
  async switchState(enabled: boolean): Promise<boolean> {
    const manager = camera.getCameraManager(this.ctx.uiAbilityContext);
    const mode = enabled ? camera.TorchMode.ON : camera.TorchMode.OFF;
    if (!manager.isTorchSupported() || !manager.isTorchModeSupported(mode)) {
      throw new Error('ERR_TORCH_UNAVAILABLE: flashlight mode is not supported');
    }
    manager.setTorchMode(mode);
    return true;
  }

  async requestCameraPermission(): Promise<boolean> {
    // HarmonyOS CameraManager torch APIs do not require CAMERA permission
    // or open a camera input.
    return true;
  }
}
三个设计点值得展开。
3.1 支持性检查必须在下发命令之前
if (!manager.isTorchSupported() || !manager.isTorchModeSupported(mode)) {
  throw new Error('ERR_TORCH_UNAVAILABLE: ...');
}
manager.setTorchMode(mode);
这里做了两层检查:
- isTorchSupported() —— 这台设备有没有闪光灯;
- isTorchModeSupported(mode) —— 这个模式(ON / OFF)支不支持。
两层检查是必要的,因为有些设备的闪光灯只支持常亮、不支持闪烁(或反过来),“有闪光灯”并不等于“这个模式可用”。
检查失败时抛出的是带前缀的明确错误(ERR_TORCH_UNAVAILABLE),调用方能靠字符串识别并走降级逻辑。这一点比“静默返回 false”好得多——静默失败会让调用方以为操作成功了。
3.2 它不打开相机、不采集图像
实现里出现的相机 API 只有四个:
getCameraManager / isTorchSupported / isTorchModeSupported / setTorchMode没有 createCameraInput、没有 createCaptureSession、没有预览流。这是静态就能查清的事实,也是理解“为什么不需要 CAMERA 权限”的钥匙——它只借用 CameraManager 的手电接口,不碰相机采集链路。
3.3 JS 侧的参数守卫是"被拒绝的 Promise"
上游 JS 层保留了类型校验:
async function switchState(enabled: boolean): Promise<boolean> {
  if (typeof enabled !== 'boolean') {
    throw new TypeError('Torch.switchState expects a boolean');
  }
  return NativeTorch.switchState(enabled);
}
注意它在 async 函数里,所以抛出的是一个被拒绝的 Promise,而不是同步异常。这意味着:
// ❌ 抓不到
try { Torch.switchState(1); } catch (e) {}

// ✅ 这样才抓得到
await Torch.switchState(1).catch(e => console.log(e.message));
这个细节在本轮验证中被实际确认过——参数守卫组的断言必须用 await 才能捕获到 TypeError。调用方如果按同步异常来写 try/catch,会漏掉所有参数错误。
四、requestCameraPermission() 为什么直接返回 true
这个方法最容易引起误解。它在 Android 上的语义是弹出系统相机授权框,所以返回值表示“用户授权了没有”。到了鸿蒙,实现直接写成:
async requestCameraPermission(): Promise<boolean> {
  return true;
}
为什么可以这样写?
因为鸿蒙的手电筒 API 走的是 CameraManager,既不要求声明 ohos.permission.CAMERA,也不打开相机输入。既然没有权限可申请,也就没有授权框可弹——直接返回 true 表示"没有权限障碍,你继续调 switchState 就行"。
这个 true 的含义要读准:
它表示 | 它不表示 |
不存在权限障碍 | 设备一定有闪光灯 |
可以继续调用 switchState | 闪光灯能被点亮 |
保留了上游接口的兼容性 | Android 上的授权弹窗行为也一致 |
交付包 README 专门写了这个限定,这一点做得很诚实。如果调用方把 requestCameraPermission() === true 当成"硬件可用"的判据,就会在无闪光灯设备上做出错误决策——正确的判据是 switchState 是否成功,而不是权限方法是否返回 true。
五、接入宿主
宿主工程是一个已经运行起来的 RNOH 示例应用。接入这个库要改四处:
文件 | 改动 |
package.json | 加 "react-native-torch": "file:../react-native-torch" |
metro.config.js | watchFolders 增加该库的绝对路径 |
index.js | import 测试页并注册 |
harmony/entry/oh-package.json5 | 手工加 HAR 依赖 |
第四处是唯一需要留神的:
"@react-native-ohos/react-native-torch": "file:../../node_modules/react-native-torch/harmony/torch.har"自动链接工具不会写这一处。它会把 package.json 的依赖关系和 Metro 的模块解析处理好,日志里也会报 linked 9 libraries,但模块级的 oh-package.json5 依赖需要手工补——漏了这一步,编译期就会在 CMake / ohpm 阶段报找不到包。
这一点交付包的 README 里也专门提醒了,写成了一句很实在的话:
若宿主 CMake 的 OH_MODULES_DIR 指向 entry/oh_modules,还需在 harmony/entry/oh-package.json5 添加 HAR 依赖……不能据 link 成功省略这一步。
这类“工具链不会代劳的一步”是接入环节最容易踩的坑:link-harmony 成功不代表接线完成,得认准编译产物里到底有没有这个包。
另一个刻意的选择:没有改 harmony/entry/src/main/module.json5。宿主的 requestPermissions 里只有:
"requestPermissions": [
  { "name": "ohos.permission.INTERNET" },
  { "name": "ohos.permission.VIBRATE" }
]
没有 ohos.permission.CAMERA——保持原样,因为本库不需要。这一点后来还成了一个有用的旁证,见第七节。
关于换测试页
宿主用一个启动参数(rnAppKey)决定加载哪个测试页。这个参数只在冷启动时生效,所以换页必须:
hdc shell aa force-stop com.rnoh084.demo
hdc shell aa start -b com.rnoh084.demo -a EntryAbility --ps rnAppKey TorchTestApp
force-stop 不能省。少了它,应用还活着,新参数不会重新读取,你会一直在看旧页面——而且页面长得没错,很容易误判。
六、构建与运行
# 1. 装依赖
npm install

# 2. 自动链接
node_modules\.bin\react-native link-harmony        # linked 9 libraries

# 3. 装 HAR(在 harmony/ 目录)
ohpm install --all

# 4. 出 bundle
npm run dev

# 5. 打 HAP
hvigorw --mode module -p product=default -p module=entry@default assembleHap --no-daemon
编译结果:
项 | 数值 |
首次 assembleHap 耗时 | 6 分 39 秒 |
HAP 变化 | 80,714,316 → 80,867,227 字节(+152,911 ≈ 149 KB) |
原生注册日志 | #RNOH_ARK ... TM created: RCTTorch |
二次重编(改了一条断言) | 6 分 27 秒,HAP 80,867,224 字节 |
两个数量级上的观察:
- 149 KB vs 2,875 字节的 HAR:HAR 本身极小,但会连带拉起相机相关的能力声明与依赖,所以最终产物增量比 HAR 大两个数量级。别拿 HAR 体积估增量。
- 编译耗时基本由 ABI / CMake 阶段决定,跟这个库没关系:加 19 行 ArkTS 不会让编译从 2 分钟变成 6 分钟,这 6 分钟是 RNOH 工程本身的量级,做集成排期时要按这个数留时间。
日志里的 #RNOH_ARK 标签说明这是 ArkTS 侧 TurboModule(不是纯 C++ TurboModule,也不是 JSI)。这个区别在排查时有用:ArkTS 模块的问题看 ArkTS 日志,纯 C++ 模块才有 #RNOH_CPP 的 TurboModuleFactory.cpp 记录。
七、验证设计:依赖硬件的库在模拟器上怎么验
这是本文最重要的一节。

7.1 问题:灯亮不亮,模拟器答不了
模拟器(Pura X View,ohos-x64)没有闪光灯硬件。这意味着一件事:
switchState(true) 之后“灯是否真的亮了”,在模拟器上永远无法验证。
如果验证方案写成“调用 switchState(true),断言返回 true”,那么在这个环境下必然失败——但这个失败不是库的问题。反过来,如果为了让测试通过而放宽断言,又会遮盖真正该测的东西。
所以验证设计的关键是换一个落点。
7.2 换落点:从"硬件是否动作"换到"行为是否正确"
既然“能不能亮”验不了,那就验能验的、而且同样重要的:
硬件不支持时,它是明确失败,还是返回 true 假装成功?
这个问题在模拟器上完全可以验证,而且它比“灯能不能亮”更接近库的真实质量——因为调用方写降级逻辑时,依赖的正是“失败能被感知到”这件事。一个在无硬件时静默返回 true 的库,会让调用方以为灯亮了,这比报错糟糕得多。
于是把验证分成三层:
层 | 能验吗 | 内容 |
A. 契约与类型 | ✅ 完全可验 | 两个方法存在、返回 Promise、权限方法解析为 true |
B. JS 侧参数守卫 | ✅ 完全可验 | 非布尔参数必须以 TypeError 拒绝(6 种取值) |
C. 硬件相关行为 | ⚠️ 只记录,不断言“应当成功” | 实测结局,重点看是明确失败还是假装成功 |
A、B 两层进通过率,C 层如实记录。这样通过率是有意义的(13 / 13),同时不掩盖硬件未验证的事实。
7.3 A 组:契约与类型(6 项,全通过)
断言 | 结果 |
switchState 是 function | ✅ |
requestCameraPermission 是 function | ✅ |
requestCameraPermission() 返回 Promise | ✅ |
requestCameraPermission() 解析为 true | ✅ |
switchState(true) 返回 Promise | ✅ |
switchState(false) 返回 Promise | ✅ |
这里有个细节让这组在无硬件时依然成立:switchState 是 async 函数,无论内部成功还是抛错,返回的一定是 Promise。 因此,“返回 Promise”这条断言与硬件无关,可以放心验证。
7.4 B 组:参数守卫(7 项,全通过)
非布尔参数必须以 TypeError 拒绝:
传入值 | 结果 |
undefined | ✅ TypeError |
null | ✅ TypeError |
0 | ✅ TypeError |
1 | ✅ TypeError |
"true" | ✅ TypeError |
{} | ✅ TypeError |
非法参数之后,合法调用不再被参数守卫拦住 | ✅ |
最后一条值得单独说,因为它让我改过一次断言。
初版我把它写成"非法参数之后调用应当成功"。结果在本机失败——因为无闪光灯时,合法调用会以 ERR_TORCH_UNAVAILABLE 拒绝。那是正确的硬件行为,不是参数问题,但我的断言把两件事混在了一起。
改判据后:只检查结果里不再出现 TypeError,不管它最终是成功还是因硬件拒绝——这样断言只依赖"参数守卫"这一个契约,与环境能力无关。
教训:测试断言不能隐含"环境具备某能力"这个前提。
断言应该只依赖被测代码的契约,不依赖环境能力。如果确实要断言环境,就把它单独成组并如实记录,而不是混进通过率里——否则通过率会随设备变化,失去意义。
7.5 C 组:硬件相关行为(如实记录)
四次调用的实测结果:
硬件|switchState(true)        拒绝:ERR_TORCH_UNAVAILABLE: flashlight mode is not supported
硬件|switchState(false)       拒绝:ERR_TORCH_UNAVAILABLE: flashlight mode is not supported
硬件|switchState(true) 第二次   拒绝:ERR_TORCH_UNAVAILABLE: flashlight mode is not supported
硬件|switchState(false) 第二次  拒绝:ERR_TORCH_UNAVAILABLE: flashlight mode is not supported
硬件|两轮结果是否一致:是
硬件|四次调用是否都以 ERR_TORCH_UNAVAILABLE 拒绝:是
硬件|硬件不支持时是否返回 true 假装成功:否(明确失败)
后两条是页面从实测结果动态推导出来的,不是写死的文案——这样它们才是断言,而不是修饰。
两个结论:
- 本机确实没有闪光灯 —— 四次调用全部走到"不支持"分支,两轮一致;
- 库的行为是对的 —— 硬件不支持时明确拒绝,没有返回 true 假装成功。
第 2 条才是本轮真正验证到的东西,而它恰好是模拟器能验证、也最应该验证的那一条。
7.6 两个独立旁证
断言之外还找了两个不依赖测试页的旁证,用来交叉验证“确实没碰硬件”。
旁证一:相机服务侧没有任何日志。
在两次调用前后抓取 hilog,没有相机服务的任何记录。这和代码路径完全一致:isTorchSupported() 检查失败就抛错了,从未执行到 setTorchMode,所以系统侧没有动作可记录。
如果代码是“先下发命令再检查结果”,就会看到系统侧有响应——日志的有无,正好反证了检查发生在命令之前。
旁证二:没有 CAMERA 权限,错误类型却是“硬件不支持”。
宿主 module.json5 里没有声明 ohos.permission.CAMERA,而 switchState 返回的是:
ERR_TORCH_UNAVAILABLE: flashlight mode is not supported是“不支持”,不是“无权限”。如果是权限问题,报错应该是权限拒绝;既然系统先给出了硬件不支持的判断,就说明这条调用路径根本没走到权限校验——独立印证了“鸿蒙手电 API 不需要相机权限”这个结论。
这两个旁证的价值在于:它们不来自我的测试代码。一个来自系统日志,一个来自工程配置,都是外部事实。
7.7 关于测试页本身
测试页沿用了一个统一的断言夹具:每条断言用 record(组名, 描述, 期望, 实际) 记录,最后按组汇总“通过 / 失败”。硬件行为单独成组,不计入通过率。页面根节点包在 SafeAreaView 里避免被状态栏遮挡,日志统一带 [torch-test] 前缀方便过滤。
另外,C 组的两个推导结论是运行时算出来的:
四次调用是否都以 ERR_TORCH_UNAVAILABLE 拒绝:是
硬件不支持时是否返回 true 假装成功:否(明确失败)
这样做的好处是——换一台有闪光灯的设备跑,这两行会自动变成“否”和“不适用”,而不会继续打印“是”。写死的文案会骗人,动态推导不会。
八、真机验证:哪些验过了,哪些没验
这一节必须写清楚,因为这是本轮最容易被含糊过去的地方。
8.1 已验证
项 | 证据 |
两个方法的契约与类型 | A 组 6 条断言全通过 |
JS 侧参数守卫(6 种非布尔值) | B 组 7 条断言全通过 |
原生模块成功注册 | hilog 中 TM created: RCTTorch |
模块是 ArkTS 实现 | 日志标签为 #RNOH_ARK |
硬件不支持时的失败模式 | C 组:四次调用全部以 ERR_TORCH_UNAVAILABLE 明确拒绝,未返回 true 假装成功,两轮一致 |
失败发生命令下发之前 | 相机服务侧无任何 hilog 记录 |
手电 API 不需要 CAMERA 权限 | 宿主无该权限声明,错误类型仍是“硬件不支持”而非“无权限” |
编译与产物 | assembleHap 成功,HAP +149 KB |
8.2 未验证(本轮无法验证)
项 | 为什么没验 |
闪光灯是否真的会亮 | 本机没有闪光灯硬件,无法验证 |
开启 / 关闭的实际硬件状态 | 需要真机,并需要查看系统侧的手电状态事件 |
相机被其他应用占用时的失败路径 | 需要真实硬件与占用场景 |
其他 ROM / 平板 / 无闪光灯真机的差异 | 只有一台模拟器 |
亮灯时的功耗与发热 | 无硬件 |
8.3 为什么要分开写
因为这两类事的可信度完全不同。
- 把"已验证"说成"适配成功、功能正常"是过度声明——灯到底亮不亮,我没验过;
- 把"未验证"含糊成"应该没问题",会让下一位使用者踩坑;
- 反过来,把"硬件不支持时正确报错"也归入未验证,又低估了本轮的实际成果。
准确的表述是:软件层全通过,硬件动作未验证,但硬件不支持时的失败模式已确认为正确。
九、已知限制
- 模拟器没有闪光灯,"点亮"无法验证。这是本轮最大的空白,需要真机补充。
- requestCameraPermission() 恒返回 true,是兼容桩而非硬件探测。它的返回值不能当作"硬件可用"的判据。调用方应改用 switchState 是否成功来判断。
- 无权限声明的结论只在本轮环境成立。本轮验证了"不声明 CAMERA 权限也能走到硬件检查",但没有验证其他 ROM 上是否同样如此。
- 未做跨平台对照。本轮只验证鸿蒙,没有对比 Android / iOS 上同一接口的行为差异(特别是 requestCameraPermission 的弹窗语义)。
- ERR_TORCH_UNAVAILABLE 是字符串前缀,不是错误码。调用方靠自己匹配字符串来识别,匹配时要考虑前缀而非全等,否则错误文案微调就会破坏降级逻辑。
- 单设备、单次运行。只在一台模拟器上跑过,没有压力测试、没有并发调用场景、没有反复快速切换。
- 未改动库代码,也未发现缺陷。本轮唯一一次失败是我自己测试页的断言写错了(隐含了"硬件存在"的前提),修正后通过。
十、常见问题
Q1:调用 switchState(true) 报 ERR_TORCH_UNAVAILABLE,是适配坏了吗?
不一定。先确认设备有没有闪光灯——模拟器上、平板上、很多无闪光灯设备上,这个错误是正确行为。这个库的设计就是"没有闪光灯就明确报错",而不是静默成功。
Q2:requestCameraPermission() 返回 true 了,为什么 switchState 还是失败?
因为这两件事无关。true 表示"不存在权限障碍",不表示设备有闪光灯。在鸿蒙上手电 API 根本不需要相机权限,所以这个方法只是个兼容桩。
Q3:需要声明 ohos.permission.CAMERA 吗?
本库不需要,本轮实测没有声明也能正常走到硬件检查。但如果你的应用自己还要做拍照、录像,那当然要声明——那是另一条采集链路的事。
Q4:为什么 try { Torch.switchState(1) } catch {} 抓不到参数错误?
因为 JS 守卫在 async 函数里,抛出的是被拒绝的 Promise。必须 await 或 .catch():
await Torch.switchState(1).catch(e => console.log(e.message));Q5:link-harmony 报链接成功,编译还是找不到包?
检查 harmony/entry/oh-package.json5 有没有手工加上 HAR 依赖。自动链接工具不写模块级的这一处,漏了就报找不到包——这不是链接失败,是链接没覆盖到这里。
Q6:换了测试页代码,界面还是旧的?
rnAppKey 这类启动参数只在冷启动生效。先 aa force-stop 再 aa start,否则一直在看旧页面。
Q7:怎么在自己设备上确认闪光灯到底能不能用?
别信权限方法,直接试:
try {
  await Torch.switchState(true);
  console.log('下发成功');        // 注意:命令被接受,不代表灯一定亮了
} catch (e) {
  console.log('不可用:', e.message);
}
注意日志里的措辞——即使返回成功,也只表示"命令被系统接受";要确认灯真的亮了,得看设备本身。这个区分在交付包的 README 里也写明了。
Q8:编译要 6 分多钟,是不是这个库太重?
不是。这 6 分钟是 RNOH 工程本身 ABI / CMake 阶段的量级,跟 19 行 ArkTS 无关。HAR 只有 2,875 字节,但最终 HAP 增了 149 KB——别拿 HAR 体积估算集成增量。
小结
react-native-torch 是个小库:两个 API、19 行原生实现、不需要任何权限。但它在方法论上给了一个很典型的题目——当库依赖的硬件在你手上不存在时,验证该怎么做?
这次的做法是:
- 把验证分层。 契约与参数守卫(A、B)完全可验,计入通过率;硬件行为(C)只记录、不断言“应当成功”。
- 换验证落点。 既然“灯亮不亮”验不了,就验**“硬件不支持时是否明确失败,而不是返回 true 假装成功”**——这一条模拟器能验,而且比“能不能亮”更接近库的质量。
- 找不依赖测试代码的旁证。 相机服务无日志(证明检查发生在命令下发之前)、无 CAMERA 权限却报“硬件不支持”(证明这条路径不需要相机权限)——两个都来自系统日志和工程配置,不是我自己的断言。
- 把“已验证”和“未验证”分开写。 软件层全通过是真的,硬件动作没验也是真的,不能混成一句“适配成功”。
另外两条从实践中得来的经验:
- 断言不能隐含“环境具备某能力”。 我初版把“非法参数之后调用应当成功”写成断言,在有闪光灯的机器上会过,在这台机器上必然失败。断言只该依赖被测代码的契约,否则通过率会随设备漂移,失去意义。
- requestCameraPermission() 返回 true 不是硬件探针。 它是权限语义上的“没有障碍”,把两者混为一谈,就会在无硬件设备上做出错误决策。
还有一点关于交付包:它自己在 README 里就写清了“返回 true 不表示设备一定有闪光灯”,并且诚实声明了哪些场景是 mock 验证、哪些没做真机覆盖。 一个交付包能主动划出自己的能力边界,比它多写几个 API 有用得多——因为使用者正是靠这句话避免误判的。
本篇用到的库
项 | 内容 |
三方库 | react-native-torch(上游 1.2.0 的鸿蒙适配版) |
适配仓库 | https://atomgit.com/oh-react-native/react-native-torch |
适配 TAG | 1.2.0-ohos-1.0.0 |
ohpm 包名 | @react-native-ohos/react-native-torch |
HAR | harmony/torch.har(2,875 字节) |
原生模块名 | RCTTorch(ArkTS TurboModule,日志标签 #RNOH_ARK) |
是否需要权限 | 不需要 |
上游仓库 | https://github.com/ludo/react-native-torch(基线 commit 957db6330a0afd09455e42ce6537e0ca69518e3c,MIT) |
宿主工程 | RNOH084Demo(测试页 rnAppKey = TorchTestApp) |
接入方式:
// harmony/entry/oh-package.json5(需手工添加)
"@react-native-ohos/react-native-torch": "file:../../node_modules/react-native-torch/harmony/torch.har"
import Torch from 'react-native-torch';
await Torch.requestCameraPermission(); // 鸿蒙上恒为 true,仅表"无权限障碍"
try {
await Torch.switchState(true); // 成功只代表命令被系统接受
} catch (e) {
// 无闪光灯设备会抛 ERR_TORCH_UNAVAILABLE
console.log(String(e));
}
await Torch.switchState(false);# 换页启动测试页(force-stop 不能省,换页参数只在冷启动生效)
hdc shell aa force-stop com.rnoh084.demo
hdc shell aa start -b com.rnoh084.demo -a EntryAbility --ps rnAppKey TorchTestApp验证环境
项 | 版本 |
React Native | 0.84.1 |
React | 19.2.3 |
RNOH(npm / ohpm) | @react-native-oh/react-native-harmony / @rnoh/react-native-openharmony 0.84.3 |
Node.js | v24.14.0 |
DevEco Studio | 26.0.0.621 |
HarmonyOS SDK | API 26(26.0.0.32) |
设备 | HarmonyOS 7.0.0(26.0.0) Beta2 模拟器 Pura X View(ohos-x64)——无闪光灯硬件 |
宿主 HAP 产物 | entry-default-signed.hap(80.87 MB) |
本次增量构建 | assembleHap 6 分 39 秒,HAP +149 KB |
验证规模 | 设备侧软件层 13 项断言全部通过;硬件行为组 4 次调用如实记录(全部 ERR_TORCH_UNAVAILABLE) |
欢迎加入 CPF-RN 鸿蒙社区:https://atomgit.com/CPF-RN
React Native for OpenHarmony 组织:https://atomgit.com/oh-react-native
RN 三方库鸿蒙适配清单:https://atomgit.com/oh-react-native/rn-ohos-adaptation-overview
本文记录把 react-native-torch(手电筒 / 相机闪光灯控制)适配到 HarmonyOS 的完整过程,涵盖版本对齐、原生实现走查、接入宿主、构建运行,以及依赖硬件的库在模拟器上究竟该怎么验证。
react-native-torch 的 API 只有两个,却是个典型例子:它控制的是一块模拟器上根本不存在的硬件。这类库的适配难点不在代码量,而在“什么算验证通过”。
一、先说结论
项 | 结果 |
上游最新版 | 1.2.0 |
是否带原生实现 | 是(ArkTS TurboModule,不是纯 JS) |
是否依赖硬件 | 是,依赖相机闪光灯 |
公开 API | switchState(enabled)、requestCameraPermission(title?, message?),都返回 Promise |
是否需要声明权限 | 不需要(连 ohos.permission.CAMERA 都用不上) |
原生实现体量 | ArkTS 侧 19 行,HAR 包 2,875 字节 |
编译是否通过 | ✅ assembleHap 成功,HAP 从 80,714,316 增至 80,867,227 字节(+152,911 ≈ 149 KB) |
原生是否注册 | ✅ 日志 TM created: RCTTorch |
软件层断言 | ✅ 13 / 13 通过(契约 6 + 参数守卫 7) |
硬件层结论 | ⚠️ 本机没有闪光灯,四次调用全部以 ERR_TORCH_UNAVAILABLE 拒绝——没有返回 true 假装成功 |
一句话结论:这个库不需要权限、实现只有 19 行、接入后正常注册;但它要控制的闪光灯在这台设备上并不存在,所以“灯亮不亮”无法在本轮验证——本轮真正验证到的,是它在硬件不支持时会明确报错,而不是假装成功。这两件事必须分开说。
二、判定过程
适配前先回答三个问题。
2.1 这个库需要鸿蒙化吗
看源码就知道必须:
// src/NativeTorch.ts
import type {TurboModule} from 'react-native';
import {TurboModuleRegistry} from 'react-native';

export interface Spec extends TurboModule {
  switchState(enabled: boolean): Promise<boolean>;
  requestCameraPermission(title?: string, message?: string): Promise<boolean>;
}

export default TurboModuleRegistry.getEnforcing<Spec>('RCTTorch');
getEnforcing 意味着取不到原生模块就直接抛错,没有 JS 兜底实现。而 react-native-torch 上游只提供 Android 与 iOS 原生代码,鸿蒙上没有 RCTTorch 这个名字的模块——所以必须补一个鸿蒙原生实现。
这里和纯 JS 库的分界线很清楚:纯 JS 库只要能跑通就直接可用,而这类库不补原生实现就必然报错。
2.2 上游版本核对
npm view react-native-torch version # 1.2.0拿到鸿蒙适配包后对比到上游基线,版本一致,没有落后。
2.3 交付包里该有的信息都在
spec.json 里有 upstream 仓库地址,也有 upstreamCommit 基线 commit——两样都记了,意味着后续上游改动时能确定该合到哪个点,这次适配的可追溯性是完整的。
validation 里还明确写了能力边界,其中一条很关键:
返回 true 不表示设备一定有闪光灯。
交付包自己先把这件事说清楚了,这一点很重要——它没有让调用方误以为“switchState 返回 true = 灯亮了”。
三、适配实现:先查支持性,再下发命令
原生实现全文:
// harmony/torch/src/main/ets/RCTTorchTurboModule.ts
import camera from '@ohos.multimedia.camera';
import { UITurboModule } from '@rnoh/react-native-openharmony/ts';

export class RCTTorchTurboModule extends UITurboModule {
  async switchState(enabled: boolean): Promise<boolean> {
    const manager = camera.getCameraManager(this.ctx.uiAbilityContext);
    const mode = enabled ? camera.TorchMode.ON : camera.TorchMode.OFF;
    if (!manager.isTorchSupported() || !manager.isTorchModeSupported(mode)) {
      throw new Error('ERR_TORCH_UNAVAILABLE: flashlight mode is not supported');
    }
    manager.setTorchMode(mode);
    return true;
  }

  async requestCameraPermission(): Promise<boolean> {
    // HarmonyOS CameraManager torch APIs do not require CAMERA permission
    // or open a camera input.
    return true;
  }
}
三个设计点值得展开。
3.1 支持性检查必须在下发命令之前
if (!manager.isTorchSupported() || !manager.isTorchModeSupported(mode)) {
  throw new Error('ERR_TORCH_UNAVAILABLE: ...');
}
manager.setTorchMode(mode);
这里做了两层检查:
- isTorchSupported() —— 这台设备有没有闪光灯;
- isTorchModeSupported(mode) —— 这个模式(ON / OFF)支不支持。
两层检查是必要的,因为有些设备的闪光灯只支持常亮、不支持闪烁(或反过来),“有闪光灯”并不等于“这个模式可用”。
检查失败时抛出的是带前缀的明确错误(ERR_TORCH_UNAVAILABLE),调用方能靠字符串识别并走降级逻辑。这一点比“静默返回 false”好得多——静默失败会让调用方以为操作成功了。
3.2 它不打开相机、不采集图像
实现里出现的相机 API 只有四个:
getCameraManager / isTorchSupported / isTorchModeSupported / setTorchMode没有 createCameraInput、没有 createCaptureSession、没有预览流。这是静态就能查清的事实,也是理解“为什么不需要 CAMERA 权限”的钥匙——它只借用 CameraManager 的手电接口,不碰相机采集链路。
3.3 JS 侧的参数守卫是"被拒绝的 Promise"
上游 JS 层保留了类型校验:
async function switchState(enabled: boolean): Promise<boolean> {
  if (typeof enabled !== 'boolean') {
    throw new TypeError('Torch.switchState expects a boolean');
  }
  return NativeTorch.switchState(enabled);
}
注意它在 async 函数里,所以抛出的是一个被拒绝的 Promise,而不是同步异常。这意味着:
// ❌ 抓不到
try { Torch.switchState(1); } catch (e) {}

// ✅ 这样才抓得到
await Torch.switchState(1).catch(e => console.log(e.message));
这个细节在本轮验证中被实际确认过——参数守卫组的断言必须用 await 才能捕获到 TypeError。调用方如果按同步异常来写 try/catch,会漏掉所有参数错误。
四、requestCameraPermission() 为什么直接返回 true
这个方法最容易引起误解。它在 Android 上的语义是弹出系统相机授权框,所以返回值表示“用户授权了没有”。到了鸿蒙,实现直接写成:
async requestCameraPermission(): Promise<boolean> {
  return true;
}
为什么可以这样写?
因为鸿蒙的手电筒 API 走的是 CameraManager,既不要求声明 ohos.permission.CAMERA,也不打开相机输入。既然没有权限可申请,也就没有授权框可弹——直接返回 true 表示"没有权限障碍,你继续调 switchState 就行"。
这个 true 的含义要读准:
它表示 | 它不表示 |
不存在权限障碍 | 设备一定有闪光灯 |
可以继续调用 switchState | 闪光灯能被点亮 |
保留了上游接口的兼容性 | Android 上的授权弹窗行为也一致 |
交付包 README 专门写了这个限定,这一点做得很诚实。如果调用方把 requestCameraPermission() === true 当成"硬件可用"的判据,就会在无闪光灯设备上做出错误决策——正确的判据是 switchState 是否成功,而不是权限方法是否返回 true。
五、接入宿主
宿主工程是一个已经运行起来的 RNOH 示例应用。接入这个库要改四处:
文件 | 改动 |
package.json | 加 "react-native-torch": "file:../react-native-torch" |
metro.config.js | watchFolders 增加该库的绝对路径 |
index.js | import 测试页并注册 |
harmony/entry/oh-package.json5 | 手工加 HAR 依赖 |
第四处是唯一需要留神的:
"@react-native-ohos/react-native-torch": "file:../../node_modules/react-native-torch/harmony/torch.har"自动链接工具不会写这一处。它会把 package.json 的依赖关系和 Metro 的模块解析处理好,日志里也会报 linked 9 libraries,但模块级的 oh-package.json5 依赖需要手工补——漏了这一步,编译期就会在 CMake / ohpm 阶段报找不到包。
这一点交付包的 README 里也专门提醒了,写成了一句很实在的话:
若宿主 CMake 的 OH_MODULES_DIR 指向 entry/oh_modules,还需在 harmony/entry/oh-package.json5 添加 HAR 依赖……不能据 link 成功省略这一步。
这类“工具链不会代劳的一步”是接入环节最容易踩的坑:link-harmony 成功不代表接线完成,得认准编译产物里到底有没有这个包。
另一个刻意的选择:没有改 harmony/entry/src/main/module.json5。宿主的 requestPermissions 里只有:
"requestPermissions": [
  { "name": "ohos.permission.INTERNET" },
  { "name": "ohos.permission.VIBRATE" }
]
没有 ohos.permission.CAMERA——保持原样,因为本库不需要。这一点后来还成了一个有用的旁证,见第七节。
关于换测试页
宿主用一个启动参数(rnAppKey)决定加载哪个测试页。这个参数只在冷启动时生效,所以换页必须:
hdc shell aa force-stop com.rnoh084.demo
hdc shell aa start -b com.rnoh084.demo -a EntryAbility --ps rnAppKey TorchTestApp
force-stop 不能省。少了它,应用还活着,新参数不会重新读取,你会一直在看旧页面——而且页面长得没错,很容易误判。
六、构建与运行
# 1. 装依赖
npm install

# 2. 自动链接
node_modules\.bin\react-native link-harmony        # linked 9 libraries

# 3. 装 HAR(在 harmony/ 目录)
ohpm install --all

# 4. 出 bundle
npm run dev

# 5. 打 HAP
hvigorw --mode module -p product=default -p module=entry@default assembleHap --no-daemon
编译结果:
项 | 数值 |
首次 assembleHap 耗时 | 6 分 39 秒 |
HAP 变化 | 80,714,316 → 80,867,227 字节(+152,911 ≈ 149 KB) |
原生注册日志 | #RNOH_ARK ... TM created: RCTTorch |
二次重编(改了一条断言) | 6 分 27 秒,HAP 80,867,224 字节 |
两个数量级上的观察:
- 149 KB vs 2,875 字节的 HAR:HAR 本身极小,但会连带拉起相机相关的能力声明与依赖,所以最终产物增量比 HAR 大两个数量级。别拿 HAR 体积估增量。
- 编译耗时基本由 ABI / CMake 阶段决定,跟这个库没关系:加 19 行 ArkTS 不会让编译从 2 分钟变成 6 分钟,这 6 分钟是 RNOH 工程本身的量级,做集成排期时要按这个数留时间。
日志里的 #RNOH_ARK 标签说明这是 ArkTS 侧 TurboModule(不是纯 C++ TurboModule,也不是 JSI)。这个区别在排查时有用:ArkTS 模块的问题看 ArkTS 日志,纯 C++ 模块才有 #RNOH_CPP 的 TurboModuleFactory.cpp 记录。
七、验证设计:依赖硬件的库在模拟器上怎么验
这是本文最重要的一节。
7.1 问题:灯亮不亮,模拟器答不了
模拟器(Pura X View,ohos-x64)没有闪光灯硬件。这意味着一件事:
switchState(true) 之后“灯是否真的亮了”,在模拟器上永远无法验证。
如果验证方案写成“调用 switchState(true),断言返回 true”,那么在这个环境下必然失败——但这个失败不是库的问题。反过来,如果为了让测试通过而放宽断言,又会遮盖真正该测的东西。
所以验证设计的关键是换一个落点。
7.2 换落点:从"硬件是否动作"换到"行为是否正确"
既然“能不能亮”验不了,那就验能验的、而且同样重要的:
硬件不支持时,它是明确失败,还是返回 true 假装成功?
这个问题在模拟器上完全可以验证,而且它比“灯能不能亮”更接近库的真实质量——因为调用方写降级逻辑时,依赖的正是“失败能被感知到”这件事。一个在无硬件时静默返回 true 的库,会让调用方以为灯亮了,这比报错糟糕得多。
于是把验证分成三层:
层 | 能验吗 | 内容 |
A. 契约与类型 | ✅ 完全可验 | 两个方法存在、返回 Promise、权限方法解析为 true |
B. JS 侧参数守卫 | ✅ 完全可验 | 非布尔参数必须以 TypeError 拒绝(6 种取值) |
C. 硬件相关行为 | ⚠️ 只记录,不断言“应当成功” | 实测结局,重点看是明确失败还是假装成功 |
A、B 两层进通过率,C 层如实记录。这样通过率是有意义的(13 / 13),同时不掩盖硬件未验证的事实。
7.3 A 组:契约与类型(6 项,全通过)
断言 | 结果 |
switchState 是 function | ✅ |
requestCameraPermission 是 function | ✅ |
requestCameraPermission() 返回 Promise | ✅ |
requestCameraPermission() 解析为 true | ✅ |
switchState(true) 返回 Promise | ✅ |
switchState(false) 返回 Promise | ✅ |
这里有个细节让这组在无硬件时依然成立:switchState 是 async 函数,无论内部成功还是抛错,返回的一定是 Promise。 因此,“返回 Promise”这条断言与硬件无关,可以放心验证。
7.4 B 组:参数守卫(7 项,全通过)
非布尔参数必须以 TypeError 拒绝:
传入值 | 结果 |
undefined | ✅ TypeError |
null | ✅ TypeError |
0 | ✅ TypeError |
1 | ✅ TypeError |
"true" | ✅ TypeError |
{} | ✅ TypeError |
非法参数之后,合法调用不再被参数守卫拦住 | ✅ |
最后一条值得单独说,因为它让我改过一次断言。
初版我把它写成"非法参数之后调用应当成功"。结果在本机失败——因为无闪光灯时,合法调用会以 ERR_TORCH_UNAVAILABLE 拒绝。那是正确的硬件行为,不是参数问题,但我的断言把两件事混在了一起。
改判据后:只检查结果里不再出现 TypeError,不管它最终是成功还是因硬件拒绝——这样断言只依赖"参数守卫"这一个契约,与环境能力无关。
教训:测试断言不能隐含"环境具备某能力"这个前提。
断言应该只依赖被测代码的契约,不依赖环境能力。如果确实要断言环境,就把它单独成组并如实记录,而不是混进通过率里——否则通过率会随设备变化,失去意义。
7.5 C 组:硬件相关行为(如实记录)
四次调用的实测结果:
硬件|switchState(true)        拒绝:ERR_TORCH_UNAVAILABLE: flashlight mode is not supported
硬件|switchState(false)       拒绝:ERR_TORCH_UNAVAILABLE: flashlight mode is not supported
硬件|switchState(true) 第二次   拒绝:ERR_TORCH_UNAVAILABLE: flashlight mode is not supported
硬件|switchState(false) 第二次  拒绝:ERR_TORCH_UNAVAILABLE: flashlight mode is not supported
硬件|两轮结果是否一致:是
硬件|四次调用是否都以 ERR_TORCH_UNAVAILABLE 拒绝:是
硬件|硬件不支持时是否返回 true 假装成功:否(明确失败)
后两条是页面从实测结果动态推导出来的,不是写死的文案——这样它们才是断言,而不是修饰。
两个结论:
- 本机确实没有闪光灯 —— 四次调用全部走到"不支持"分支,两轮一致;
- 库的行为是对的 —— 硬件不支持时明确拒绝,没有返回 true 假装成功。
第 2 条才是本轮真正验证到的东西,而它恰好是模拟器能验证、也最应该验证的那一条。
7.6 两个独立旁证
断言之外还找了两个不依赖测试页的旁证,用来交叉验证“确实没碰硬件”。
旁证一:相机服务侧没有任何日志。
在两次调用前后抓取 hilog,没有相机服务的任何记录。这和代码路径完全一致:isTorchSupported() 检查失败就抛错了,从未执行到 setTorchMode,所以系统侧没有动作可记录。
如果代码是“先下发命令再检查结果”,就会看到系统侧有响应——日志的有无,正好反证了检查发生在命令之前。
旁证二:没有 CAMERA 权限,错误类型却是“硬件不支持”。
宿主 module.json5 里没有声明 ohos.permission.CAMERA,而 switchState 返回的是:
ERR_TORCH_UNAVAILABLE: flashlight mode is not supported是“不支持”,不是“无权限”。如果是权限问题,报错应该是权限拒绝;既然系统先给出了硬件不支持的判断,就说明这条调用路径根本没走到权限校验——独立印证了“鸿蒙手电 API 不需要相机权限”这个结论。
这两个旁证的价值在于:它们不来自我的测试代码。一个来自系统日志,一个来自工程配置,都是外部事实。
7.7 关于测试页本身
测试页沿用了一个统一的断言夹具:每条断言用 record(组名, 描述, 期望, 实际) 记录,最后按组汇总“通过 / 失败”。硬件行为单独成组,不计入通过率。页面根节点包在 SafeAreaView 里避免被状态栏遮挡,日志统一带 [torch-test] 前缀方便过滤。
另外,C 组的两个推导结论是运行时算出来的:
四次调用是否都以 ERR_TORCH_UNAVAILABLE 拒绝:是
硬件不支持时是否返回 true 假装成功:否(明确失败)
这样做的好处是——换一台有闪光灯的设备跑,这两行会自动变成“否”和“不适用”,而不会继续打印“是”。写死的文案会骗人,动态推导不会。
八、真机验证:哪些验过了,哪些没验
这一节必须写清楚,因为这是本轮最容易被含糊过去的地方。
8.1 已验证
项 | 证据 |
两个方法的契约与类型 | A 组 6 条断言全通过 |
JS 侧参数守卫(6 种非布尔值) | B 组 7 条断言全通过 |
原生模块成功注册 | hilog 中 TM created: RCTTorch |
模块是 ArkTS 实现 | 日志标签为 #RNOH_ARK |
硬件不支持时的失败模式 | C 组:四次调用全部以 ERR_TORCH_UNAVAILABLE 明确拒绝,未返回 true 假装成功,两轮一致 |
失败发生命令下发之前 | 相机服务侧无任何 hilog 记录 |
手电 API 不需要 CAMERA 权限 | 宿主无该权限声明,错误类型仍是“硬件不支持”而非“无权限” |
编译与产物 | assembleHap 成功,HAP +149 KB |
8.2 未验证(本轮无法验证)
项 | 为什么没验 |
闪光灯是否真的会亮 | 本机没有闪光灯硬件,无法验证 |
开启 / 关闭的实际硬件状态 | 需要真机,并需要查看系统侧的手电状态事件 |
相机被其他应用占用时的失败路径 | 需要真实硬件与占用场景 |
其他 ROM / 平板 / 无闪光灯真机的差异 | 只有一台模拟器 |
亮灯时的功耗与发热 | 无硬件 |
8.3 为什么要分开写
因为这两类事的可信度完全不同。
- 把"已验证"说成"适配成功、功能正常"是过度声明——灯到底亮不亮,我没验过;
- 把"未验证"含糊成"应该没问题",会让下一位使用者踩坑;
- 反过来,把"硬件不支持时正确报错"也归入未验证,又低估了本轮的实际成果。
准确的表述是:软件层全通过,硬件动作未验证,但硬件不支持时的失败模式已确认为正确。
九、已知限制
- 模拟器没有闪光灯,"点亮"无法验证。这是本轮最大的空白,需要真机补充。
- requestCameraPermission() 恒返回 true,是兼容桩而非硬件探测。它的返回值不能当作"硬件可用"的判据。调用方应改用 switchState 是否成功来判断。
- 无权限声明的结论只在本轮环境成立。本轮验证了"不声明 CAMERA 权限也能走到硬件检查",但没有验证其他 ROM 上是否同样如此。
- 未做跨平台对照。本轮只验证鸿蒙,没有对比 Android / iOS 上同一接口的行为差异(特别是 requestCameraPermission 的弹窗语义)。
- ERR_TORCH_UNAVAILABLE 是字符串前缀,不是错误码。调用方靠自己匹配字符串来识别,匹配时要考虑前缀而非全等,否则错误文案微调就会破坏降级逻辑。
- 单设备、单次运行。只在一台模拟器上跑过,没有压力测试、没有并发调用场景、没有反复快速切换。
- 未改动库代码,也未发现缺陷。本轮唯一一次失败是我自己测试页的断言写错了(隐含了"硬件存在"的前提),修正后通过。
十、常见问题
Q1:调用 switchState(true) 报 ERR_TORCH_UNAVAILABLE,是适配坏了吗?
不一定。先确认设备有没有闪光灯——模拟器上、平板上、很多无闪光灯设备上,这个错误是正确行为。这个库的设计就是"没有闪光灯就明确报错",而不是静默成功。
Q2:requestCameraPermission() 返回 true 了,为什么 switchState 还是失败?
因为这两件事无关。true 表示"不存在权限障碍",不表示设备有闪光灯。在鸿蒙上手电 API 根本不需要相机权限,所以这个方法只是个兼容桩。
Q3:需要声明 ohos.permission.CAMERA 吗?
本库不需要,本轮实测没有声明也能正常走到硬件检查。但如果你的应用自己还要做拍照、录像,那当然要声明——那是另一条采集链路的事。
Q4:为什么 try { Torch.switchState(1) } catch {} 抓不到参数错误?
因为 JS 守卫在 async 函数里,抛出的是被拒绝的 Promise。必须 await 或 .catch():
await Torch.switchState(1).catch(e => console.log(e.message));Q5:link-harmony 报链接成功,编译还是找不到包?
检查 harmony/entry/oh-package.json5 有没有手工加上 HAR 依赖。自动链接工具不写模块级的这一处,漏了就报找不到包——这不是链接失败,是链接没覆盖到这里。
Q6:换了测试页代码,界面还是旧的?
rnAppKey 这类启动参数只在冷启动生效。先 aa force-stop 再 aa start,否则一直在看旧页面。
Q7:怎么在自己设备上确认闪光灯到底能不能用?
别信权限方法,直接试:
try {
  await Torch.switchState(true);
  console.log('下发成功');        // 注意:命令被接受,不代表灯一定亮了
} catch (e) {
  console.log('不可用:', e.message);
}
注意日志里的措辞——即使返回成功,也只表示"命令被系统接受";要确认灯真的亮了,得看设备本身。这个区分在交付包的 README 里也写明了。
Q8:编译要 6 分多钟,是不是这个库太重?
不是。这 6 分钟是 RNOH 工程本身 ABI / CMake 阶段的量级,跟 19 行 ArkTS 无关。HAR 只有 2,875 字节,但最终 HAP 增了 149 KB——别拿 HAR 体积估算集成增量。
小结
react-native-torch 是个小库:两个 API、19 行原生实现、不需要任何权限。但它在方法论上给了一个很典型的题目——当库依赖的硬件在你手上不存在时,验证该怎么做?
这次的做法是:
- 把验证分层。 契约与参数守卫(A、B)完全可验,计入通过率;硬件行为(C)只记录、不断言“应当成功”。
- 换验证落点。 既然“灯亮不亮”验不了,就验**“硬件不支持时是否明确失败,而不是返回 true 假装成功”**——这一条模拟器能验,而且比“能不能亮”更接近库的质量。
- 找不依赖测试代码的旁证。 相机服务无日志(证明检查发生在命令下发之前)、无 CAMERA 权限却报“硬件不支持”(证明这条路径不需要相机权限)——两个都来自系统日志和工程配置,不是我自己的断言。
- 把“已验证”和“未验证”分开写。 软件层全通过是真的,硬件动作没验也是真的,不能混成一句“适配成功”。
另外两条从实践中得来的经验:
- 断言不能隐含“环境具备某能力”。 我初版把“非法参数之后调用应当成功”写成断言,在有闪光灯的机器上会过,在这台机器上必然失败。断言只该依赖被测代码的契约,否则通过率会随设备漂移,失去意义。
- requestCameraPermission() 返回 true 不是硬件探针。 它是权限语义上的“没有障碍”,把两者混为一谈,就会在无硬件设备上做出错误决策。
还有一点关于交付包:它自己在 README 里就写清了“返回 true 不表示设备一定有闪光灯”,并且诚实声明了哪些场景是 mock 验证、哪些没做真机覆盖。 一个交付包能主动划出自己的能力边界,比它多写几个 API 有用得多——因为使用者正是靠这句话避免误判的。
本篇用到的库
项 | 内容 |
三方库 | react-native-torch(上游 1.2.0 的鸿蒙适配版) |
适配仓库 | https://atomgit.com/oh-react-native/react-native-torch |
适配 TAG | 1.2.0-ohos-1.0.0 |
ohpm 包名 | @react-native-ohos/react-native-torch |
HAR | harmony/torch.har(2,875 字节) |
原生模块名 | RCTTorch(ArkTS TurboModule,日志标签 #RNOH_ARK) |
是否需要权限 | 不需要 |
上游仓库 | https://github.com/ludo/react-native-torch(基线 commit 957db6330a0afd09455e42ce6537e0ca69518e3c,MIT) |
宿主工程 | RNOH084Demo(测试页 rnAppKey = TorchTestApp) |
接入方式:
// harmony/entry/oh-package.json5(需手工添加)
"@react-native-ohos/react-native-torch": "file:../../node_modules/react-native-torch/harmony/torch.har"
import Torch from 'react-native-torch';
await Torch.requestCameraPermission(); // 鸿蒙上恒为 true,仅表"无权限障碍"
try {
await Torch.switchState(true); // 成功只代表命令被系统接受
} catch (e) {
// 无闪光灯设备会抛 ERR_TORCH_UNAVAILABLE
console.log(String(e));
}
await Torch.switchState(false);# 换页启动测试页(force-stop 不能省,换页参数只在冷启动生效)
hdc shell aa force-stop com.rnoh084.demo
hdc shell aa start -b com.rnoh084.demo -a EntryAbility --ps rnAppKey TorchTestApp验证环境
项 | 版本 |
React Native | 0.84.1 |
React | 19.2.3 |
RNOH(npm / ohpm) | @react-native-oh/react-native-harmony / @rnoh/react-native-openharmony 0.84.3 |
Node.js | v24.14.0 |
DevEco Studio | 26.0.0.621 |
HarmonyOS SDK | API 26(26.0.0.32) |
设备 | HarmonyOS 7.0.0(26.0.0) Beta2 模拟器 Pura X View(ohos-x64)——无闪光灯硬件 |
宿主 HAP 产物 | entry-default-signed.hap(80.87 MB) |
本次增量构建 | assembleHap 6 分 39 秒,HAP +149 KB |
验证规模 | 设备侧软件层 13 项断言全部通过;硬件行为组 4 次调用如实记录(全部 ERR_TORCH_UNAVAILABLE) |
欢迎加入 CPF-RN 鸿蒙社区:https://atomgit.com/CPF-RN
React Native for OpenHarmony 组织:https://atomgit.com/oh-react-native
RN 三方库鸿蒙适配清单:https://atomgit.com/oh-react-native/rn-ohos-adaptation-overview
收起阅读 »